

Conseils concrets pour passer d'un RAG simple à un meilleur RAG
queries: ["how do cells take in water"]
- Cell membrane transport0.71
- Osmosis and diffusion0.58
- Mitosis, phase timing0.19
- Photosynthesis, light cycle0.11
dropped below 0.4
Two chunks reach the agent. The other two never existed as far as it knows.
Presque tous les tutoriels RAG sur n8n aboutissent au même schéma : un agent IA, auquel est rattaché un nœud de stockage vectoriel utilisé directement comme outil. J’ai monté cette configuration maintes fois. Ça fonctionne, et pendant un temps, je ne me suis pas posé de questions.
Puis j’ai commencé à lui poser des questions plus complexes, et trois problèmes sont apparus, tous issus de la même cause. L’agent gère la récupération, et vous n’avez aucun contrôle.
Ceci est la version écrite d’une vidéo, avec le même cours de biologie et les mêmes chiffres.
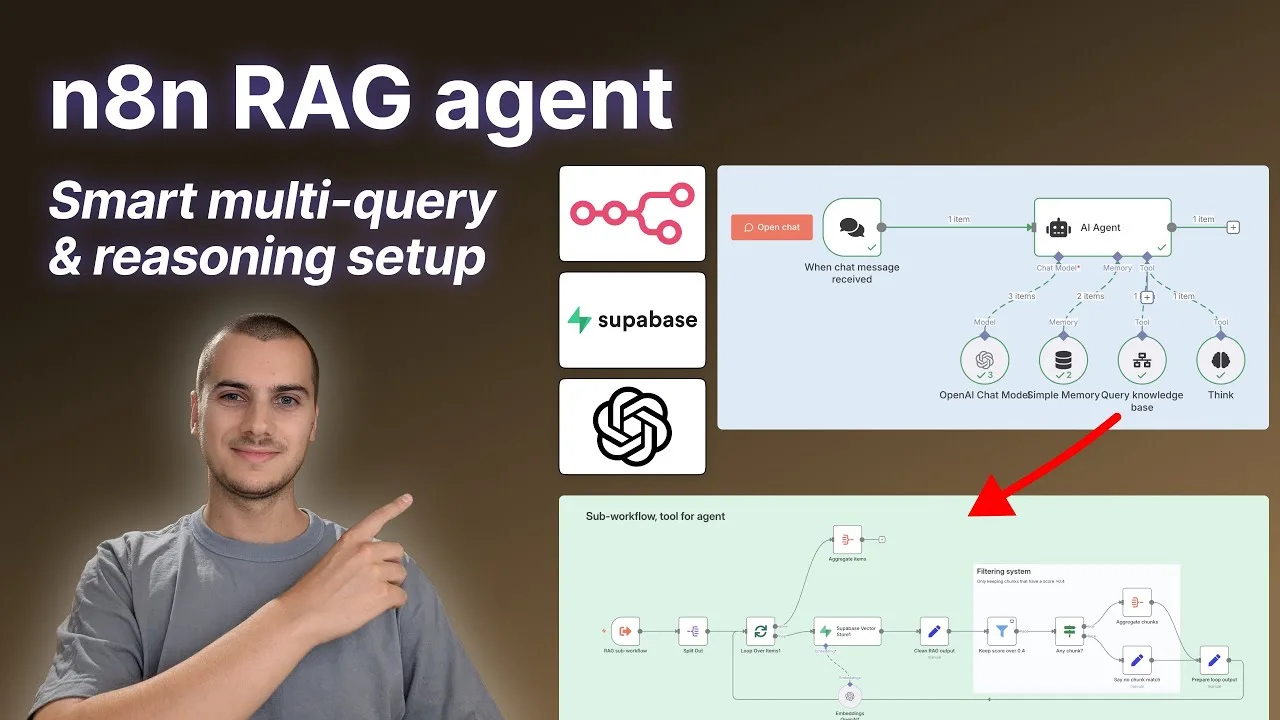
Le schéma de départ classique
Ma base de connaissances pour cet exemple est un cours de biologie, vectorisé dans Supabase. Si on lui demande « qu’est-ce qu’une cellule », il répond très bien. C’est la démo que tout le monde montre, et ce n’est pas un mensonge : les questions simples fonctionnent.
Agent IA
- Lors de la réception d'un message
- Agent IAModèle de chatModèle de chat OpenAIMémoireMémoire simpleOutilStockage vectoriel SupabaseL'agent écrit la requête, quatre segments sont retournés
Voici ce que vous contrôlez dans cette configuration : une description de l’outil, indiquant à l’agent quand l’utiliser. C’est toute la surface de réglage.
Ce que vous réglezUne seule fois, au build
- Une description de l’outil
- Le nombre de chunks à retourner
Ce que l’agent décideÀ chaque appel
- Le texte exact de la requête envoyée au vector store
- Le fait qu’il n’y ait qu’une seule requête, jamais deux
- Rien concernant le degré de proximité requis pour un chunk
Vous ne voyez jamais la requête
L’agent écrit la requête lui-même et l’envoie. Vous pouvez essayer de l’orienter via la description de l’outil et espérer. Sur une question nécessitant une reformulation, ou lorsque la formulation de l’utilisateur est très différente de celle de vos documents, vous ne le découvrez qu’en consultant le journal d’exécution après coup.
Une seule requête par appel
Une question réelle n’est souvent pas une question unique. Demandez quelque chose qui nécessite la définition d’un terme, puis la mise en relation de ce terme avec un autre, et une seule recherche de similitude devra couvrir les deux à la fois. Elle retournera alors des chunks médiocres pour les deux, plutôt que pertinents pour l’un ou l’autre.
L’agent peut appeler l’outil deux fois, mais cela représente deux tours complets du modèle, et il ne s’en donne généralement pas la peine.
Quatre chunks sont retournés, peu importe la question
C’est ce point qui m’a poussé à changer la configuration. Le vector store retourne les quatre chunks les plus proches. Les plus proches, pas forcément proches.
Demandez à mon cours de biologie quand nous dînons ce soir, et vous recevrez quand même quatre chunks. Ils sont loin, mais ce sont les quatre les moins loin, donc ils remontent. L’agent les reçoit sans aucune indication qu’ils sont inutiles, et les modèles sont conciliants, donc il les traite comme du matériel pertinent.
Requête : “quand dînons-nous ce soir”
Les scores existent dans le vector store. L’outil ne vous les transmet pas.
Remplacer l’outil par un sous-workflow
La solution consiste à ne plus donner le vector store à l’agent, mais à lui donner un sous-workflow à la place. Dans n8n, il s’agit de l’outil Call n8n Workflow : l’agent l’appelle, un workflow s’exécute sur son propre canevas, et l’agent reçoit ce que le dernier nœud produit.
Côté agent, le changement est minime. Même déclencheur, même agent, et le vector store est remplacé par deux outils.
Agent IA
- Quand un message de chat est reçu
- Agent IAgpt-5-miniModèle de chatModèle de chat OpenAIgpt-5-miniMémoireMémoire simpleLes 8 derniers toursOutilInterroger la base de connaissancesLe sous-workflow. Prend un tableau de 1 à 5 requêtesOutilThinkUtilisé juste après la récupération, 50 mots max
C’est dans le sous-workflow que se trouve toute la nouvelle surface de contrôle. Chaque bloc ci-dessous est une étape que vous avez écrite, et que vous pouvez ouvrir dans le journal d’exécution après coup.
Sous-workflow, outil pour agent
- Sous-workflow RAGDéclencheur. Entrée : queries, un tableau
- Split OutUn élément par requête
- Boucle sur les élémentsTout ce qui suit s’exécute une fois par requête
- Vector Store SupabaseEn tant que nœud, pas outil. Vous mappez la requête, et chaque chunk revient avec son scoreEmbeddingEmbeddings OpenAI
- Nettoyage sortie RAGGarde le texte du chunk, le nom du chapitre et le score arrondi à deux décimales
- Garder score > 0,4Filtre. Produit toujours des données, donc une requête sans correspondance continue quand même
- Un chunk existant ?IF, vérifie si quelque chose a survécu
vrai, un élément est passé
- Agrégé chunks
faux, rien n'est passé
- Indiquer aucun match"Aucun chunk n'a atteint le seuil de pertinence, la base de connaissances n'a pu fournir d'information"
- Préparer sortie boucleLa requête, associée à ce qu'elle a retourné
↩ Préparer sortie boucle retourne vers Boucle sur les éléments. Une fois toutes les requêtes traitées, la sortie finale de la boucle va vers un nœud Agrégé et l’agent reçoit un champ unique : Récupération base de connaissances.
Un tableau de requêtes, en un seul appel d’outil
Le déclencheur du sous-workflow accepte un champ appelé queries. La description de l’outil indique à l’agent qu’il s’agit d’un tableau de un à cinq éléments, et le prompt système dit la même chose dans l’autre sens : plus la question de l’utilisateur est complexe, plus vous devez la diviser en sous-requêtes, jusqu’à cinq.
C’est là que réside la partie multi-requête, et cela coûte un seul appel d’outil au lieu de trois.
- L'utilisateur pose une question complexeDeux termes et leur interaction
- L'agent rédige trois requêtesDéfinir le premier terme, définir le second, établir le lien1 appel d'outil
- Le sous-workflow exécute les troisUne boucle et un score pour chaque résultat
- Un élément agrégé est retournéGroupé par requête
Le score est l’élément central
Dans le sous-workflow, Supabase est un nœud classique, je mappe donc la requête moi-même et la réponse contient un score de similarité. Le filtre élimine tout ce qui est égal ou inférieur à 0,4.
Deux détails m’ont fait perdre du temps. Le filtre doit être configuré pour toujours sortir des données, sinon une requête où rien ne passe ne produit aucun élément et la branche suivante ne s’exécute jamais. Et le IF qui suit vérifie si un chunk a survécu, car c’est le cas que l’on veut gérer explicitement plutôt que par le silence : l’agent reçoit alors une phrase indiquant que la base de connaissances n’a rien contenu d’utile pour cette requête.
Indiquer à l’agent la provenance d’un chunk
L’étape de nettoyage est plus importante qu’il n’y paraît. Supabase renvoie des métadonnées dont je n’ai pas besoin, comme le type de contenu du fichier source, et cela consomme des tokens pour chaque chunk de chaque requête.
Ce que je conserve, c’est le texte du chunk plus deux champs : le chapitre dont il est issu et son score de pertinence arrondi à deux décimales. Les deux sont transmis à l’agent. Le nom du chapitre lui permet de citer sa source, et la transmission du score permet à l’agent de voir que l’une de ses cinq requêtes a atteint 0,42 tandis qu’une autre a atteint 0,81, et de les pondérer en conséquence.
Nommer les données retournées
L’agrégation finale ne produit pas un bloc anonyme. Elle génère un champ appelé Knowledge base retrieval, et à l’intérieur, chaque entrée associe Query to the knowledge base à Chunks returned.
Cette association est fondamentale. L’agent a envoyé trois requêtes, il reçoit trois groupes étiquetés et peut ainsi savoir quels chunks répondent à quelle partie de sa propre question. Si vous lui donnez un tableau plat de douze chunks, il devra en déduire la correspondance, ce qu’il fera, parfois mal.
Nommer les champs nécessite un nœud Set. C’est l’élément le moins coûteux de cette liste et celui que j’ai ignoré le plus longtemps.
Une étape de réflexion avant la réponse
L’autre changement concerne l’agent lui-même. Je lui ai donné un outil de réflexion, et le prompt système lui ordonne d’utiliser cet outil dès que la récupération est terminée : analyser la question par rapport aux résultats et vérifier s’il dispose réellement de ce dont il a besoin pour répondre.
La description de l’outil limite la réponse à 50 mots. Sans cela, il écrit des paragraphes, et réfléchir à voix haute sur quatre chunks ne justifie pas une page de tokens.
Vous pouvez lire ces notes dans le journal d’exécution, l’aspect que je n’espérais pas apprécier autant. Lorsqu’une réponse est erronée, les notes indiquent généralement si c’est la récupération qui était mauvaise ou le raisonnement.
Les dernières lignes du prompt système sont celles que je garderais si je ne pouvais en garder que deux. Répondre uniquement à partir du contenu du cours, et si une question sort de ce cadre, rediriger plutôt que répondre. Et si vous n’avez pas les informations nécessaires, dites-le plutôt que de répondre en utilisant vos connaissances générales.
Tout cela ne fonctionne que parce que la récupération est honnête lorsqu’elle revient vide. Une instruction demandant d’admettre son ignorance est inutile si chaque requête renvoie quatre chunks qui ressemblent à des preuves.
Ce que cela enseigne réellement
Chaque correction ici est la même. Quelque chose était décidé à ma place, je l’ai donc déplacé vers une étape que je maîtrise.
C’est plus précieux que le workflow lui-même. Désormais, quand je travaille avec Claude Code, les questions que je pose sont celles que cette configuration m’a forcé à me poser : qu’est-ce qui a été recherché exactement, quelle quantité de données est revenue, quelle part était utile, et qu’est-ce qui encombre la fenêtre de contexte inutilement. Un agent générique masque tout cela par défaut, et lira volontiers vingt fichiers pour répondre à une question qui n’en nécessitait que deux.
C’est en construisant soi-même la récupération des données, une fois, que l’on apprend à être attentif.