

Mapper un import CSV avec un seul appel au modèle (Jev)
- La question
- Quelle part du mappage de colonnes CSV peut être réglée par code, et un seul appel au modèle peut-il gérer tout le reste ?
- Le résultat
- Le mappage strict règle gratuitement jusqu'à 7 colonnes sur 10, et un seul appel score chaque paire restante en moins de 700 ms pour un dixième de cent.
Ce que je voulais découvrir
Tout produit permettant l’import de CSV possède cet écran. L’utilisateur télécharge un fichier, et quelque chose doit décider que son Lineitem sku correspond à votre sku.
On pouvait déjà faire cela avec un petit LLM, et cela fonctionnait assez bien. On obtenait une chaîne de caractères à laquelle il fallait faire confiance, après une attente perceptible pour l’utilisateur. Je voulais savoir si ce travail pouvait être divisé en trois : laisser le code simple régler tout ce qu’il peut régler correctement, interroger un modèle une seule fois pour tout le reste simultanément, puis ramener la décision dans le code où je peux la voir et la modifier.
Jev rend la partie centrale peu coûteuse. Il n’écrit pas de texte, il répond à des questions définies par mon code et renvoie une probabilité pour chacune. La question n’est donc pas vraiment « un modèle peut-il mapper des colonnes », mais plutôt quelle part du travail ne nécessite jamais de modèle, et si un seul appel peut absorber le reste.
Comment cela a été testé
Trois tables de destination, dix colonnes chacune, et neuf CSV d’échantillons choisis pour les cas complexes plutôt que les plus simples : un export HubSpot propre, un fichier entièrement en français avec deux colonnes d’e-mail différentes, un export Shopify où Name est le numéro de commande, un export d’entrepôt avec 23 colonnes dont 13 n’ont aucune correspondance.
Chaque colonne de destination possède une description d’une ligne, et cette description n’est pas décorative. C’est elle qui permet de distinguer deux champs adjacents.
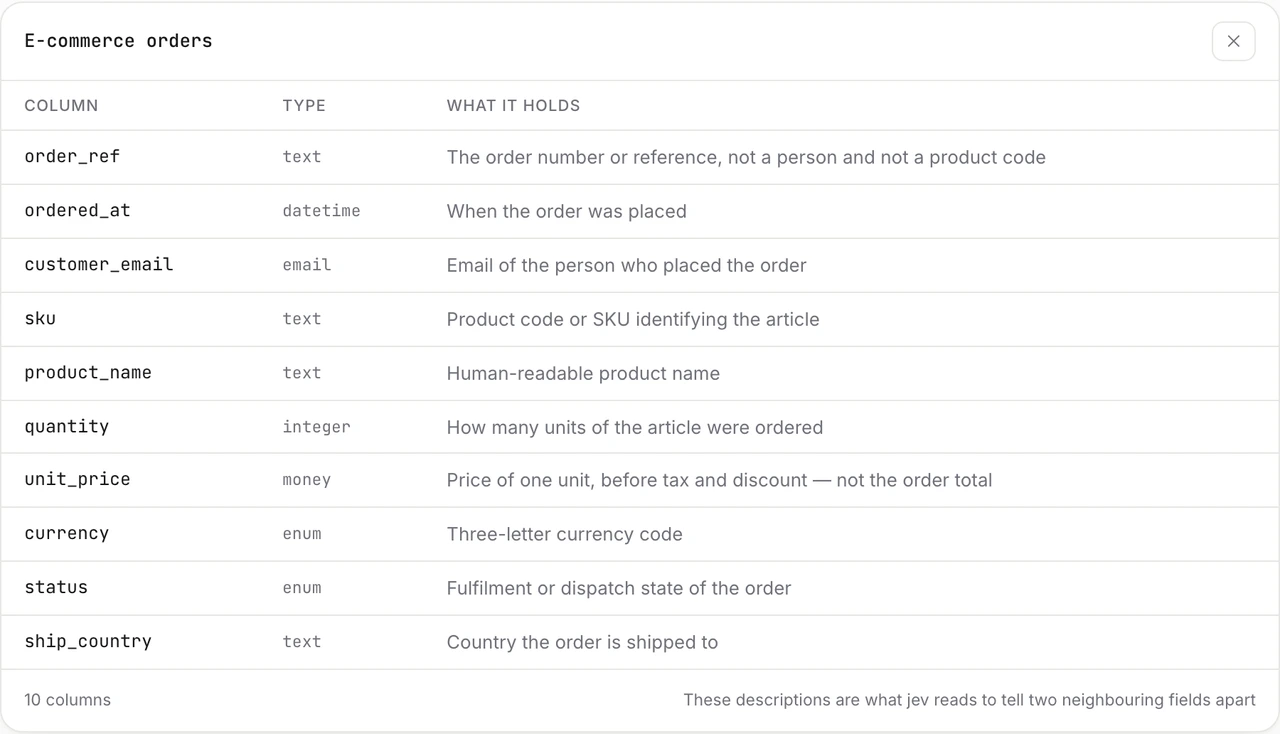
L’exécution se déroule en trois étapes, et seule l’étape centrale utilise un modèle.
Étape 1 · dans le code, gratuit et instantané
Étape 2 · un appel, toutes les paires restantes d’un coup
Étape 3 · à nouveau dans le code
La structure des questions est la seule décision de conception qui mérite un débat. Poser une seule question à choix multiples par colonne entrante serait le mouvement évident, et c’est la mauvaise approche.
Un choix par colonne entranteLa structure évidente
- Doit toujours choisir l'une des destinations
- Quand rien ne correspond, désigne quand même un élément, environ 0,85
- Rien dans la réponse ne dit « aucun de ceux-là »
Un oui/non par paire, plus un garde-fouCe qui a été construit
- Chaque paire a son propre score, indépendant des autres
- Une colonne peut avoir un score faible partout, ce qui correspond à « pas dans cette table »
- Le garde-fou demande directement si elle n'appartient à rien
Les résultats
Les neuf fichiers ont été traités en un seul appel.
| Fichier | Colonnes | Réglé dans le code | Questions | Temps Jev | Coût |
|---|---|---|---|---|---|
crm-hubspot-export.csv | 10 | 7 | 12 | 464 ms | $0.000077 |
hr-bamboo.csv | 8 | 5 | 18 | 374 ms | $0.000109 |
orders-minimal.csv | 5 | 0 | 55 | 409 ms | $0.000287 |
hr-payroll.csv | 10 | 2 | 72 | 484 ms | $0.000362 |
crm-eventbrite.csv | 7 | 0 | 77 | 514 ms | $0.000395 |
orders-shopify.csv | 10 | 1 | 90 | 437 ms | $0.000462 |
crm-french-crm.csv | 10 | 0 | 110 | 495 ms | $0.000549 |
hr-identity-provider.csv | 12 | 0 | 132 | 474 ms | $0.000658 |
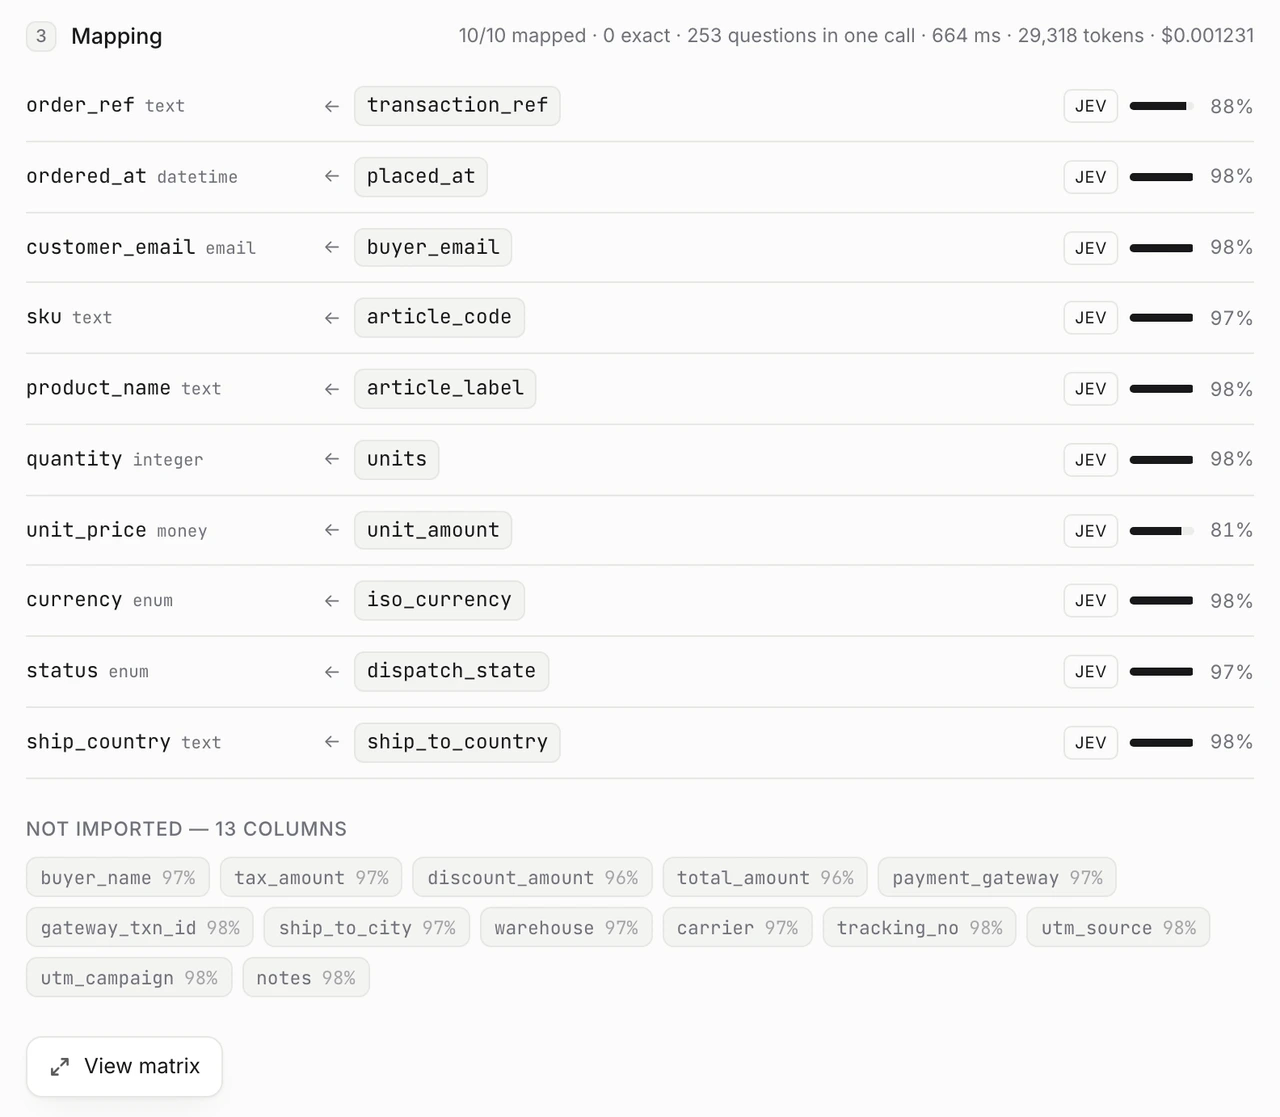
orders-warehouse-export.csv | 23 | 0 | 253 | 675 ms | $0.001231 |
Vingt et une fois le coût des questions équivaut à 1,45 fois l’attente. Douze questions prennent 464 ms et 253 prennent 675 ms. C’est sur cette propriété que repose toute la conception : si chaque question était un appel distinct, le fichier warehouse demanderait deux minutes d’attente au lieu de deux tiers de seconde, et la matrice serait inutilisable.
Sur l’export HubSpot, 7 des 10 colonnes n’atteignent même pas le modèle. Cette partie est gratuite, instantanée et ne peut pas être erronée.
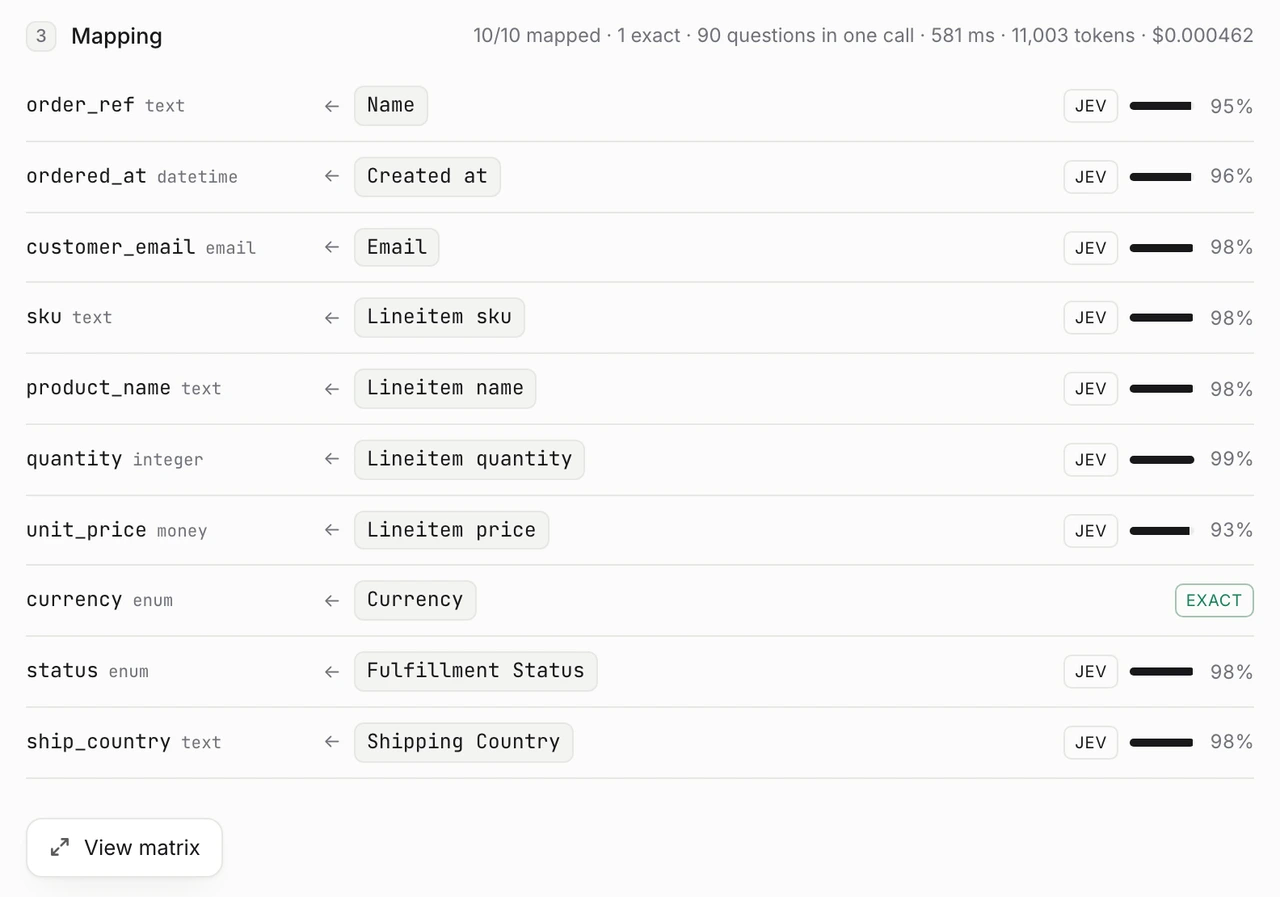
Les valeurs d’exemple font l’essentiel du travail. Chaque colonne est envoyée avec trois de ses valeurs, tronquées aux 100 premiers et derniers caractères. C’est ce qui indique au modèle que le Name de Shopify est une référence de commande, et c’est pourquoi un même nom de colonne est mappé différemment selon son contenu.
Un seul appel, et tous les chiffres sont à vous
L’appel renvoie la matrice complète, et non une décision. L’ouvrir offre la vision la plus claire de ce qui s’est réellement passé.
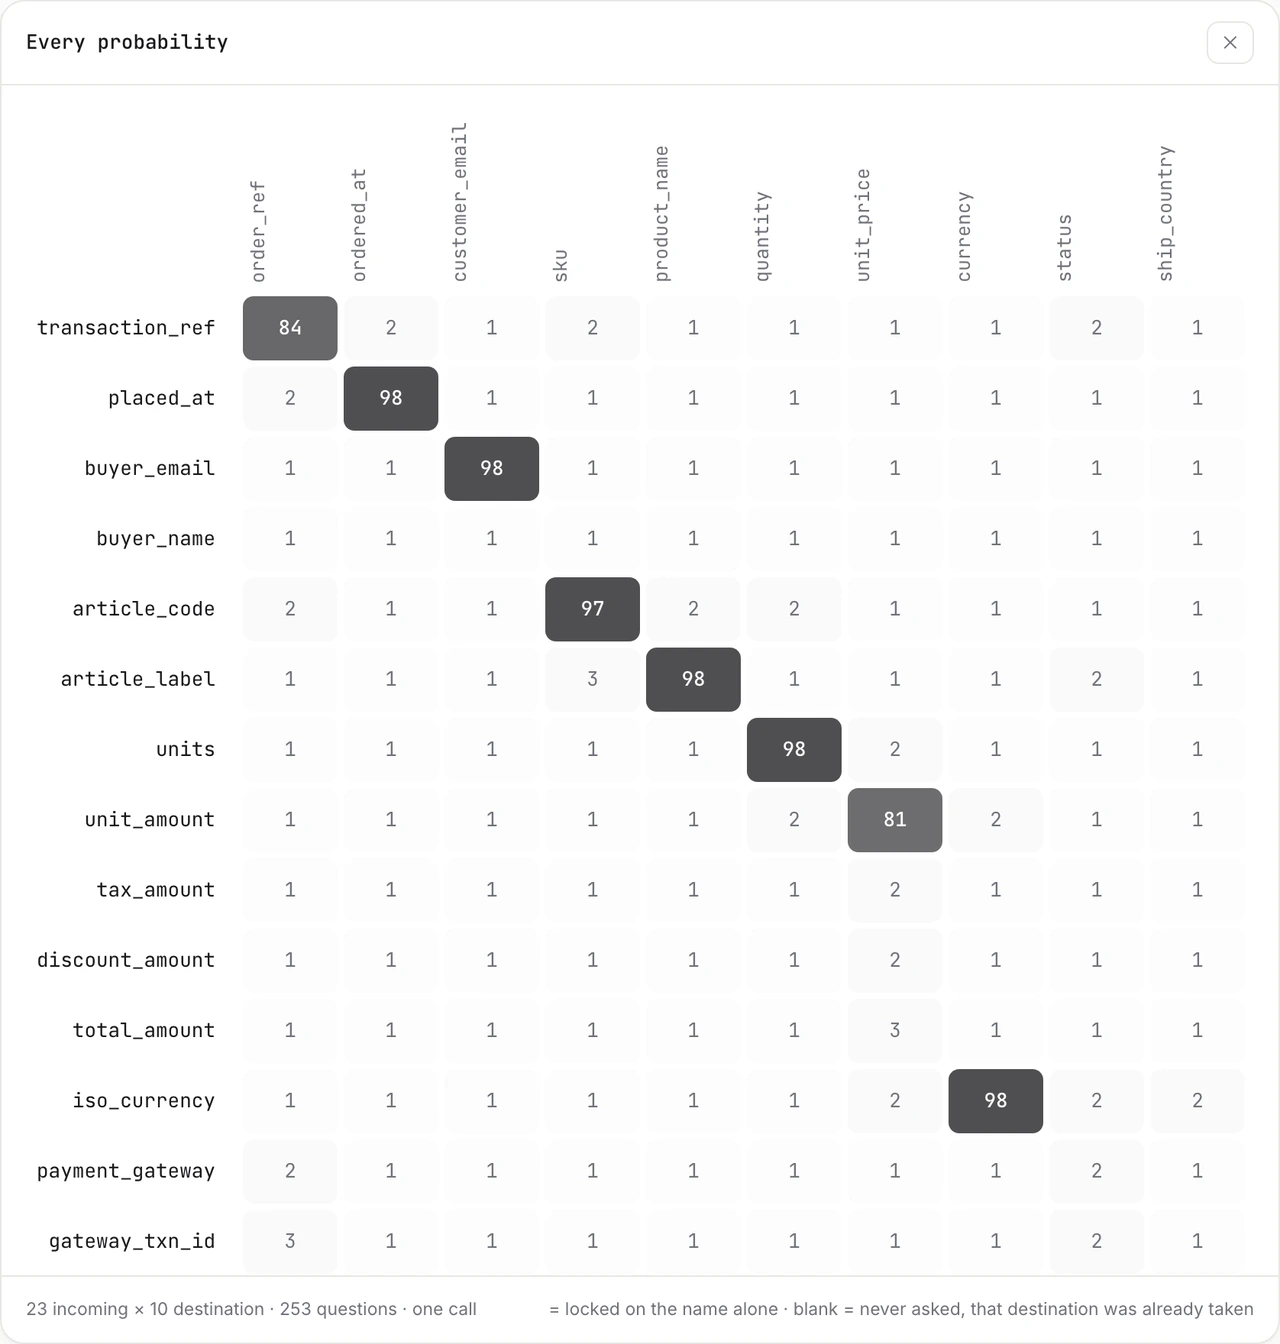
Comme le code conserve chaque chiffre, le seuil est une constante que je peux modifier plutôt qu’un comportement que je dois demander via un prompt. À 0,75, l’export warehouse mappe les dix destinations et ignore les treize colonnes concernées.
Le moment du relais
Le fichier Eventbrite est celui qu’il ne parvient pas à finaliser, et c’est là que l’écran devient intéressant.
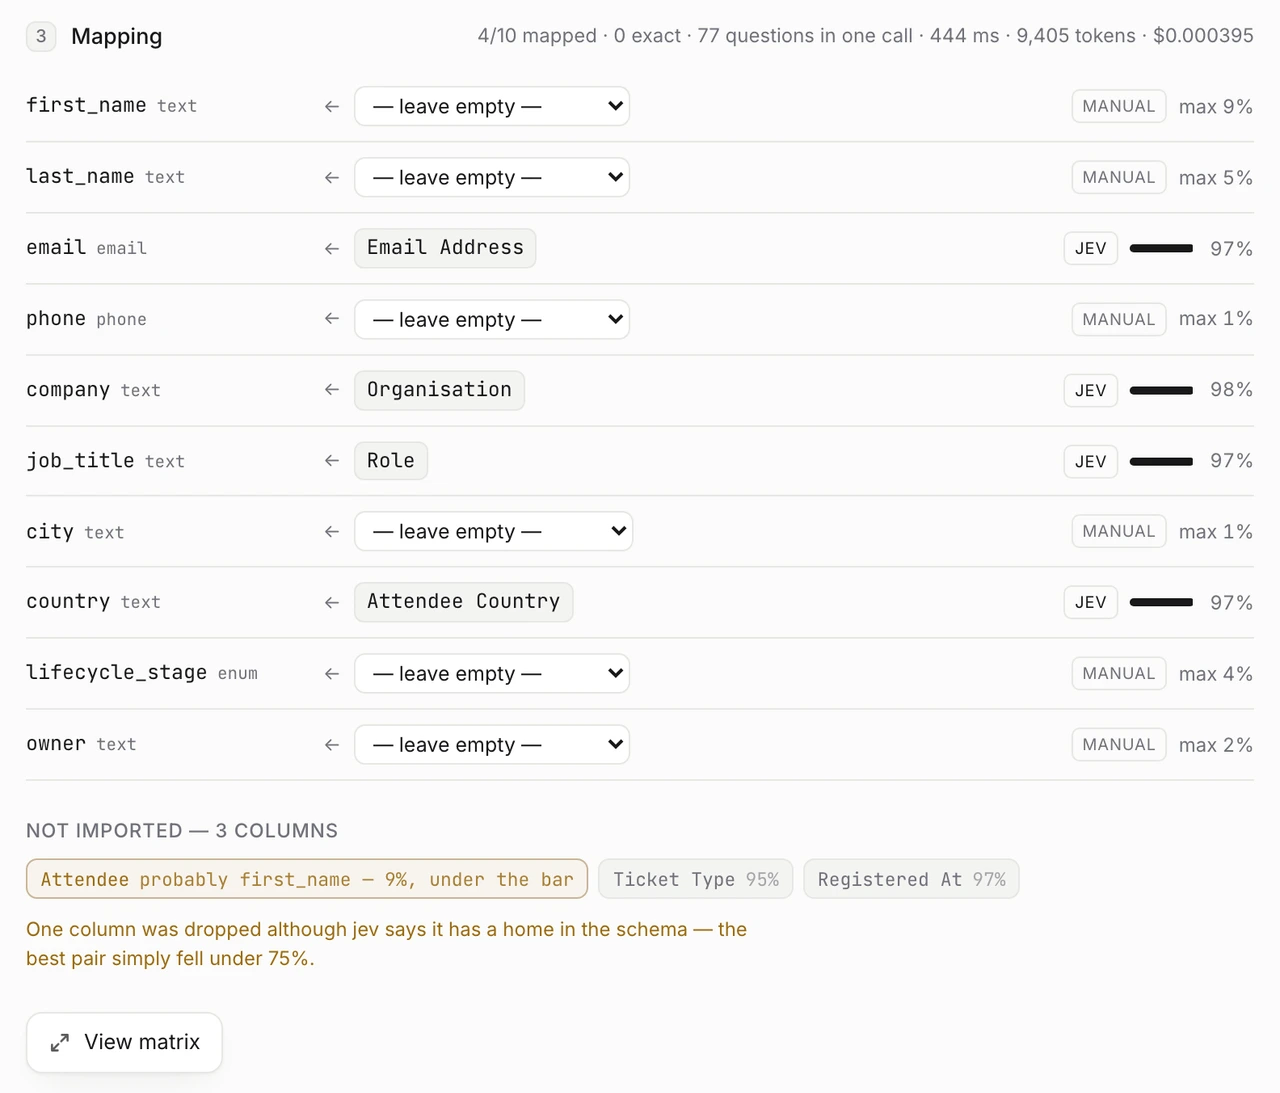
La question de garde mérite sa place au bas de cet écran. Attendee obtient un score de 9 % sur “est-ce que cela n’appartient à nulle part”, donc le modèle indique qu’il a bien une destination, mais que sa meilleure paire est tombée sous 0,75. L’interface le marque en orange au lieu de le supprimer discrètement. Ticket Type à 95 % et Registered At à 97 % sont supprimés sans commentaire, car ils n’appartiennent réellement à nulle part.
Ce que j’en retire
Faites la partie déterministe, et rien d’autre que la partie déterministe. La première version normalisait la casse, les accents et les séparateurs, et comprenait également une petite table d’alias : attendeecountry vers country, site vers location, team vers department. Ce sont des jugements déguisés en normalisation, et ils échouent deux fois. Un fichier contenant à la fois Attendee Country et Company Country produit deux correspondances exactes sur une seule destination, et le code verrouille la première venue selon l’ordre des colonnes, en silence. Et team n’est pas department, c’est une question. Supprimer les alias a fait disparaître le problème au lieu de m’obliger à arbitrer, car maintenant aucune colonne n’est exacte et le modèle les sépare grâce à leurs valeurs.
Demandez une fois, décidez après. Un seul appel renvoie 253 chiffres calibrés en 675 ms, et tout le reste n’est que de l’arithmétique lisible : le seuil, l’ordre de résolution, ce qui constitue un avertissement. Rien dans le résultat ne dépend d’un modèle qu’il aurait fallu convaincre de se comporter d’une certaine manière. Passer la barre de 0,75 à 0,80 est une modification de constante, pas un prompt.
Une probabilité vaut la peine d’être affichée. Puisque le chiffre existe déjà, l’interface l’affiche, et un mapping à 81 % se lit différemment d’un mapping à 98 %. Le modèle effectue un pré-passage, il ne prend pas la décision : l’utilisateur voit son degré de certitude sur quelle colonne, et reprend le contrôle sur celles qui comptent. C’est bien préférable à un menu déroulant affirmatif sans aucun chiffre.
Ceci a été testé sur neuf fichiers, trois tables et dix colonnes de destination chacun. Un schéma avec 40 colonnes nécessiterait plus d’un appel, et le second budget dans la fenêtre de contexte de jev ne se divise pas : une table de destination très large est donc une limite réelle plutôt qu’un simple ralentissement. Je ne l’ai pas encore essayé.