

Konkrete Tipps: Von einfachem RAG zu besserem RAG
queries: ["how do cells take in water"]
- Cell membrane transport0.71
- Osmosis and diffusion0.58
- Mitosis, phase timing0.19
- Photosynthesis, light cycle0.11
dropped below 0.4
Two chunks reach the agent. The other two never existed as far as it knows.
Fast jedes n8n RAG-Tutorial endet beim gleichen Canvas: ein AI Agent und ein daran hängender Vector Store Node, der direkt als Tool genutzt wird. Ich habe dieses Setup oft gebaut. Es funktioniert, und eine Zeit lang habe ich es nicht genauer hinterfragt.
Dann fing ich an, schwierigere Fragen zu stellen, und drei Dinge gingen schief, die alle dieselbe Ursache hatten: Der Agent steuert die Suche, und Sie haben keinerlei Kontrolle darüber.
Dies ist die schriftliche Version eines Videos, mit demselben Biologie-Kurs und denselben Zahlen.
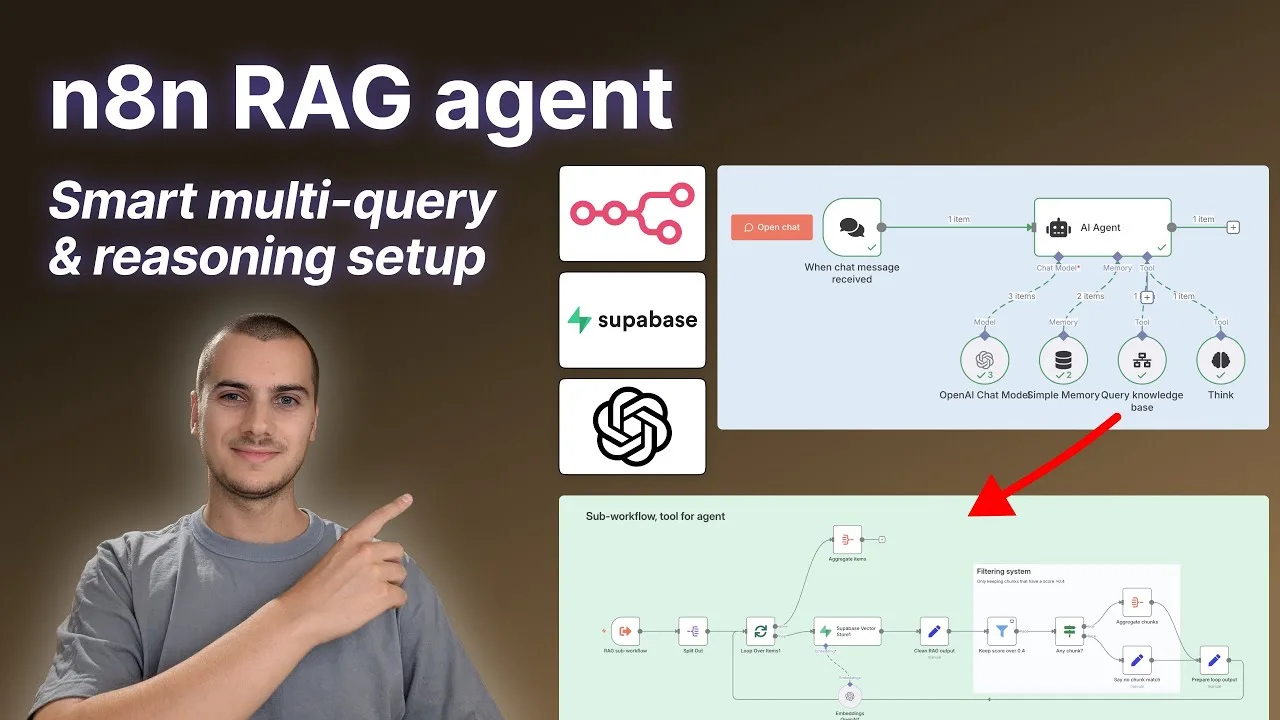
Der Canvas, mit dem alle starten
Meine Wissensbasis hierfür ist ein Biologie-Kurs, vektorisiert in Supabase. Fragt man “was ist eine Zelle”, antwortet er gut. Das ist die Demo, die jeder zeigt, und sie ist nicht gelogen: einfache Fragen funktionieren.
AI Agent
- Wenn Chat-Nachricht empfangen wird
- AI AgentChat ModelOpenAI Chat ModelMemorySimple MemoryToolSupabase Vector StoreDer Agent schreibt die Query, vier Chunks kommen zurück
Das ist alles, was Sie in diesem Setup steuern: eine Beschreibung des Tools, die dem Agenten sagt, wann er es einsetzen soll. Das ist die gesamte Konfigurationsoberfläche.
Was Sie festlegenEinmalig zur Build-Zeit
- Eine Tool-Beschreibung
- Anzahl der zurückzugebenen Chunks
Was der Agent entscheidetBei jedem Aufruf
- Der exakte Query-Text, der an den Vector Store gesendet wird
- Dass es eine Query gibt, niemals zwei
- Nichts darüber, wie nah ein Chunk beieinander liegen muss
Sie sehen die Query niemals
Der Agent schreibt die Query selbst und sendet sie ab. Sie können ihn über die Tool-Beschreibung in eine Richtung lenken und hoffen. Ob eine Frage umformuliert werden musste oder ob die Formulierung des Nutzers überhaupt nicht mit der Wortwahl in Ihren Dokumenten übereinstimmt, finden Sie erst hinterher im Execution Log heraus.
Eine Query pro Aufruf
Eine echte Frage besteht oft nicht aus nur einer Frage. Fragen Sie etwas, das erst eine Definition eines Begriffs erfordert und diesen Begriff dann mit einem anderen in Verbindung bringt, muss eine einzige Ähnlichkeitssuche beides gleichzeitig abdecken. Das Ergebnis sind Chunks, die für beides mittelmäßig sind, statt für eines der beiden gut.
Der Agent könnte das Tool zweimal aufrufen, aber das wären zwei volle Durchläufe des Modells, und meistens macht er sich die Mühe nicht.
Es kommen vier Chunks zurück, egal was Sie gefragt haben
Das war der Punkt, an dem ich das Setup geändert habe. Der Vector Store gibt die vier ähnlichsten Chunks zurück. Die ähnlichsten, nicht die tatsächlich ähnlichen.
Fragen Sie meinen Biologie-Kurs, wann wir heute Abend essen, und Sie erhalten trotzdem vier Chunks. Sie sind weit entfernt, aber sie sind die vier am wenigsten entfernten, also werden sie ausgegeben. Der Agent erhält sie ohne Hinweis darauf, dass sie wertlos sind, und da Modelle kooperativ sind, behandelt er sie als relevanten Inhalt.
Query: “wann essen wir heute Abend”
Die Scores existieren innerhalb des Vector Stores. Das Tool gibt sie nicht an Sie weiter.
Ersetzen Sie das Tool durch einen Sub-Workflow
Die Lösung besteht darin, dem Agenten nicht den Vector Store direkt zu geben, sondern stattdessen einen Sub-Workflow. In n8n ist das das Call n8n Workflow Tool: Der Agent ruft es auf, ein Workflow läuft auf seinem eigenen Canvas, und was der letzte Node ausgibt, erhält der Agent.
Auf der Seite des Agenten ändert sich kaum etwas. Gleicher Trigger, gleicher Agent, nur dass der Vector Store gegen zwei Tools getauscht wurde.
AI Agent
- Wenn Chat-Nachricht erhalten
- AI Agentgpt-5-miniChat ModelOpenAI Chat Modelgpt-5-miniMemorySimple MemoryDie letzten 8 TurnsToolWissensdatenbank abfragenDer Sub-Workflow. Nimmt ein Array von 1 bis 5 Queries entgegenToolThinkDirekt nach dem Retrieval genutzt, max. 50 Wörter
Im Sub-Workflow befindet sich die gesamte neue Konfigurationsfläche. Jede Box unten ist ein Schritt, den Sie selbst geschrieben haben und den Sie später im Execution Log einsehen können.
Sub-Workflow, Tool für Agent
- RAG Sub-WorkflowTrigger. Input: queries, ein Array
- Split OutEin Element pro Query
- Loop Over ItemsAlles danach läuft einmal pro Query
- Supabase Vector StoreAls Node, nicht als Tool. Sie mappen die Query, und jeder Chunk kommt mit seinem Score zurückEmbeddingEmbeddings OpenAI
- RAG-Ausgabe bereinigenBehält den Chunk-Text, den Kapitelnamen und den auf zwei Dezimalstellen gerundeten Score
- Score über 0,4 behaltenFilter. Gibt immer Daten aus, sodass eine Query ohne Treffer trotzdem fortgeführt wird
- Irgendwelche Chunks?IF, ob etwas übrig geblieben ist
true, etwas überstanden
- Chunks aggregieren
false, nichts überstanden
- Keine Chunk-Treffer melden"Keine Chunks haben den Relevanz-Schwellenwert erreicht, die Wissensdatenbank konnte keine Informationen liefern"
- Loop-Ausgabe vorbereitenDie Query, gepaart mit dem Ergebnis
↩ Prepare loop output geht zurück zu Loop Over Items. Wenn jede Query durchgelaufen ist, geht der Loop-Done-Output an einen Aggregate-Node und der Agent erhält ein einzelnes Feld: Knowledge base retrieval.
Ein Array von Queries in einem einzigen Tool-Aufruf
Der Trigger des Sub-Workflows akzeptiert ein Feld namens queries. Die Tool-Beschreibung teilt dem Agenten mit, dass es sich um ein Array von eins bis fünf handelt, und der System-Prompt sagt dasselbe in die andere Richtung: Je komplexer die Frage des Nutzers, desto mehr soll sie in Sub-Queries aufgeteilt werden, bis zu fünf.
Das ist der Multi-Query-Teil, und er kostet nur einen Tool-Aufruf statt drei.
- Der Nutzer stellt eine komplexe FrageZwei Begriffe und deren Interaktion
- Der Agent schreibt drei AbfragenDefinition des ersten Begriffs, des zweiten Begriffs und deren Beziehung1 Tool-Aufruf
- Der Unter-Workflow führt alle drei ausEine Schleife und ein Score für jedes Ergebnis
- Ein aggregiertes Element wird zurückgegebenGruppiert nach Abfrage
Der Score ist der entscheidende Punkt
Innerhalb des Unter-Workflows ist Supabase ein regulärer Node. Ich mappe die Abfrage selbst, und die Antwort enthält einen Similarity Score. Der Filter verwirft alles, was bei 0,4 oder darunter liegt.
Zwei Details, die mich Zeit gekostet haben: Der Filter muss so eingestellt sein, dass er immer Daten ausgibt. Andernfalls wird bei einer Abfrage, bei der nichts passt, gar kein Element erzeugt und der nachfolgende Branch wird nie ausgeführt. Zudem prüft das darauf folgende IF, ob überhaupt ein Chunk übrig geblieben ist. Das ist der Fall, den man explizit behandeln möchte, statt einfach zu schweigen: Der Agent erhält einen Satz, dass die Wissensdatenbank für diese Abfrage nichts Nützliches enthalten hat.
Dem Agenten die Quelle eines Chunks mitteilen
Der Bereinigungsschritt ist wichtiger, als es scheint. Supabase liefert Metadaten zurück, die ich nicht benötige, wie etwa den Content-Type der Quelldatei. Das verbraucht bei jedem Chunk jeder Abfrage unnötige Tokens.
Ich behalte den Chunk-Text plus zwei Felder: das Kapitel, aus dem er stammt, und den Relevance Score, gerundet auf zwei Dezimalstellen. Beides geht an den Agenten. Der Kapitelname ermöglicht es ihm, die Quelle zu nennen. Durch die Weitergabe des Scores sieht der Agent, ob eine seiner fünf Abfragen knapp bei 0,42 lag, während eine andere 0,81 erreichte, und kann diese entsprechend gewichten.
Rückgabewerte benennen
Die Aggregation am Ende erzeugt keinen anonymen Datenblock. Sie erzeugt ein Feld namens Knowledge base retrieval, in dem jeder Eintrag Query to the knowledge base mit Chunks returned verknüpft ist.
Diese Verknüpfung ist essenziell. Der Agent hat drei Abfragen gesendet, erhält drei beschriftete Gruppen zurück und kann so zuordnen, welche Chunks welchen Teil seiner eigenen Frage beantworten. Übergibt man ihm stattdessen ein flaches Array aus zwölf Chunks, muss er die Zuordnung selbst herleiten, was er zeitweise fehlerhaft tut.
Das Benennen der Felder erfordert einen Set-Node. Es ist die günstigste Maßnahme auf dieser Liste und diejenige, die ich am längsten ignoriert habe.
Ein Denk-Schritt vor der Antwort
Die andere Änderung betrifft den Agenten selbst. Ich habe ihm ein Think-Tool gegeben. Der System-Prompt weist ihn an, dieses Tool unmittelbar nach der Abfrage zu nutzen: Die Frage mit den Ergebnissen analysieren und prüfen, ob die Informationen tatsächlich ausreichen, um zu antworten.
Die Tool-Beschreibung begrenzt die Antwort auf 50 Wörter. Ohne diese Einschränkung schreibt er ganze Absätze, und ein laut gedachtes Protokoll über vier Chunks ist keine ganze Seite an Tokens wert.
Diese Notizen können im Execution Log eingesehen werden, was mir überraschenderweise sehr gefällt. Wenn eine Antwort falsch ist, verraten die Notizen meist, ob die Abfrage schlecht war oder die Logik.
Die letzten Zeilen des System-Prompts sind die wichtigsten für mich. Antworten Sie nur auf Basis der Kursinhalte; liegt eine Frage außerhalb davon, verweisen Sie darauf, statt zu antworten. Und wenn die benötigten Informationen fehlen, geben Sie dies zu, anstatt auf allgemeines Wissen zurückzugreifen.
Beides funktioniert nur, weil die darunterliegende Abfrage ehrlich kommuniziert, wenn sie leer zurückkehrt. Eine Anweisung, Unwissenheit zuzugeben, ist wertlos, wenn jede Abfrage vier Chunks liefert, die wie Beweise aussehen.
Was uns das wirklich lehrt
Jeder Fix hier ist im Grunde derselbe. Etwas wurde für mich entschieden, also habe ich es in einen Schritt verschoben, den ich selbst kontrolliere.
Das ist wertvoller als der Workflow selbst. Wenn ich jetzt mit Claude Code arbeite, stelle ich genau die Fragen, zu denen mich dieses Setup gezwungen hat: Was wurde genau gesucht, wie viel kam zurück, wie viel davon war lesenswert und was befindet sich im Kontextfenster, obwohl es niemand braucht. Ein generischer Agent verbirgt all das standardmäßig und liest bereitwillig zwanzig Dateien, um etwas zu beantworten, wofür zwei gereicht hätten.
Einmal die Retrieval-Logik von Hand zu bauen, ist der Weg, um ein Auge für diese Details zu entwickeln.