

Jev a réduit le coût de cet agent IA de 61 %
En juillet, j’ai écrit que les petits modèles devraient décider de ce que les grands modèles voient : non pas router une tâche vers un modèle moins cher, mais placer des petits modèles aux côtés du grand pour choisir quels tokens celui-ci lira. J’ai conclu cet article en disant que l’économie était une raison d’expérimenter et non une preuve, et que quelqu’un devait faire le test.
Puis Jev est sorti le 15 septembre. C’est le premier modèle System One de TypeSafe : il n’écrit aucun texte, il renvoie des probabilités calibrées sur des réponses définies par votre code, il coûte 0,042 $ par million de tokens d’entrée, et il répond en quelques centaines de millisecondes. Cette combinaison rend deux versions concrètes de l’idée de juillet assez peu coûteuses pour être mesurées.
J’ai donc testé ces deux versions.
Le préchargement des compétences. Un agent doté d’un catalogue de documents internes passe tout un cycle à décider lequel lire et à appeler un outil pour le récupérer. Jev peut prendre cette décision avant le premier tour, pour une fraction de cent, et les documents arrivent déjà dans le prompt.
Le filtrage du payload des outils. Une réponse API réelle contient surtout des champs sur lesquels aucun agent n’agira, et dans une configuration MCP, tout cela atterrit dans la fenêtre de contexte et est renvoyé à chaque tour suivant. Jev peut noter chaque champ d’une réponse avant que l’agent ne le voie.
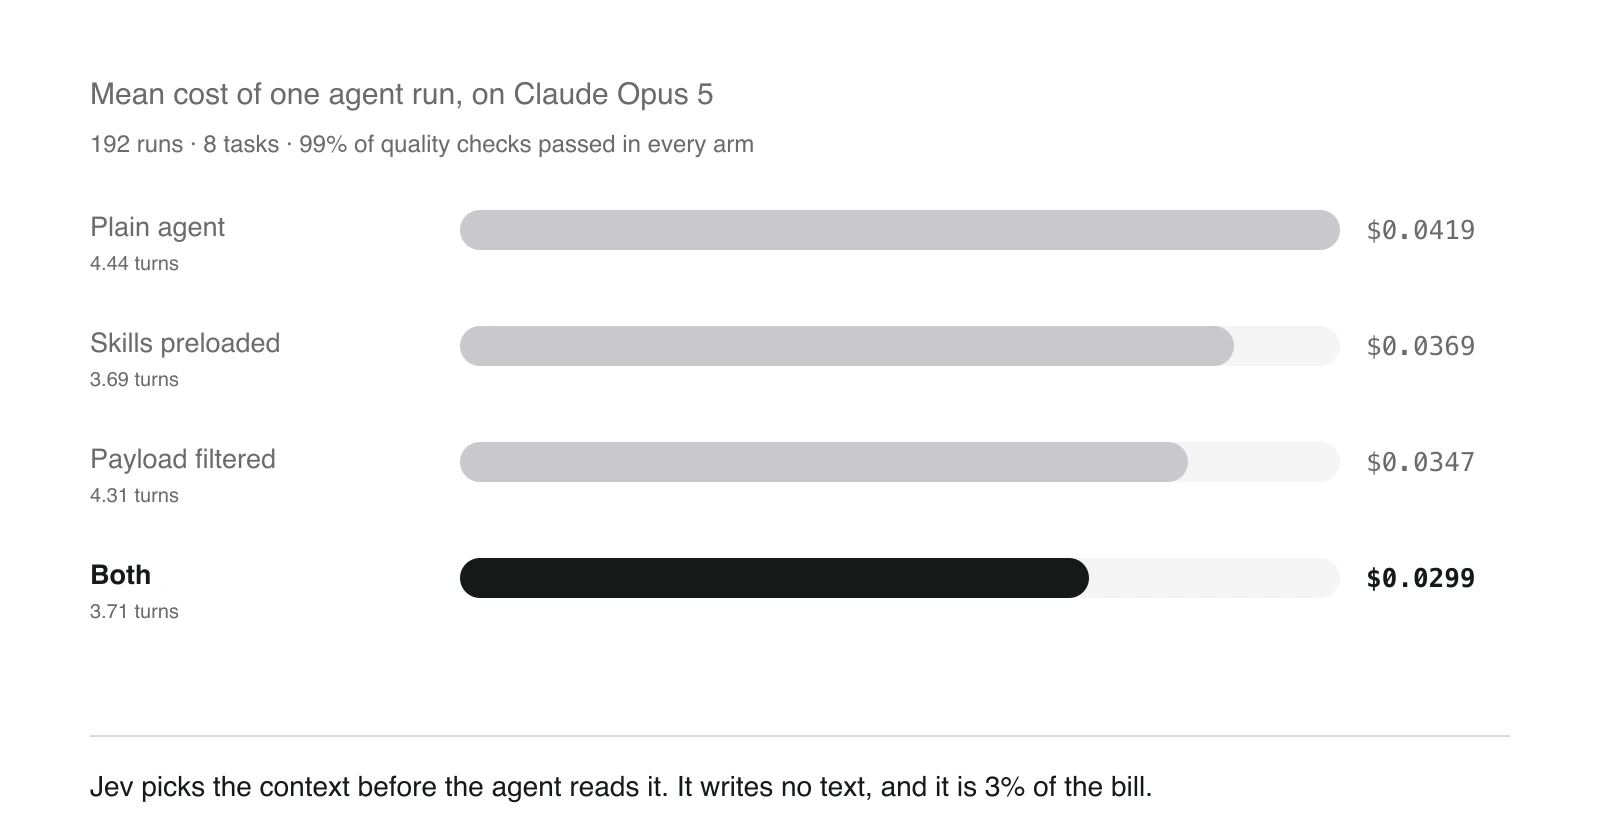
Il s’agit dans les deux cas de problèmes de classification, et non d’écriture. Voici les résultats sur 192 exécutions pour 8 tâches, tarifées sur Claude Opus 5 :
Coût moyen d’une exécution d’agent, sur Opus 5
La tâche la plus optimisée est devenue 61 % moins chère. La moyenne sur les huit est de 29 %, et la moins optimisée de 13 %. 99 % des contrôles de qualité ont été validés dans chaque configuration, y compris la simple, donc rien n’a été sacrifié pour obtenir ces gains.
L’ensemble de l’expérience a coûté 1,17 $ à exécuter.
Qu’est-ce que Jev
Il ne génère pas de texte. Vous lui envoyez un state et un ensemble de questions typées, et il renvoie une distribution de probabilités calibrées sur les réponses définies par votre code. TypeSafe appelle cela un modèle System One, entraîné avec ce qu’ils décrivent comme de l’apprentissage par renforcement pour des décisions calibrées.
| Quoi | Valeur |
|---|---|
| Prix | 0,042 $ par million de tokens d’entrée, sortie gratuite |
| Contexte | 32 000 tokens |
| Latence, mesurée ici | 300 à 600 ms, p50, quelle que soit la taille du lot |
| Endpoint | POST /api/alpha/decisions sur OpenRouter |
La propriété qui rend cette expérience possible est le batching. Chaque question est envoyée dans un seul appel HTTP avec le state envoyé une seule fois. Noter 264 champs de payload représente une seule requête, et non 264.
Mécanisme un : préchargement des compétences
Avant le premier tour de l’agent, Jev lit la requête et la description d’une ligne de chaque compétence. Il ne voit jamais le corps d’une compétence. Tout score égal ou supérieur à 0,55 est injecté intégralement dans le prompt système.
Étape 1 · demande de l’utilisateur
Étape 2 · Jev score les 11 compétences d’un coup, en lisant seulement leurs descriptions courtes
Un appel HTTP, 11 questions, environ 1 500 tokens, 0,00006 $. Seuil à 0,55, donc une seule compétence est sélectionnée.
Étape 3 · le prompt reçu par l’agent dès son premier tour
L’outil read_skill reste disponible, donc l’agent peut toujours récupérer tout ce que le routeur aurait manqué. C’est important, car le routeur manque parfois des choses.
Mécanisme deux : filtrage du payload des outils
Après le retour d’un outil et avant que sa sortie n’atteigne l’agent, chaque champ terminal de la réponse est noté selon sa pertinence pour la requête actuelle. Tout ce qui est inférieur à 0,35 est supprimé.
Étape 1 · l’agent appelle un outil et l’API répond intégralement
Étape 2 · ce que Jev sait de la situation, au-delà du payload
Étape 3 · un appel, un score par champ. Sous 0,35, le champ est barré
Sur six exécutions de cette tâche, 58 à 62 des 124 champs ont été conservés, et les trois dont la tâche dépend (status, dunning.days_past_due, account.id) ont été conservés dans les six cas.
Étape 4 · ce qui atteint la fenêtre de contexte de l’agent
3 181 caractères réduits à environ 1 780, soit une coupe de 44%, et aucun des éléments supprimés ne revient aux tours 3, 4 et 5.
Il est intéressant de noter dans ces scores que les champs supprimés lors de cet appel se situent entre 0,31 et 0,34 et ceux conservés entre 0,35 et 0,37. La frontière est réelle, et quelques champs la franchissent entre les exécutions. trial_end a été noté 0,34 dans une exécution et 0,37 dans une autre. Rien dont la tâche avait besoin n’était proche de cette limite.
D’où vient réellement la sécurité
C’est dans cette troisième étape, l’état, que tout se décide. Le même seuil avec un état moins riche est dangereux. Avec un état riche, il est à la fois plus sûr et plus agressif.
Mesuré isolément sur le champ qui décide de la tâche de relance :
| Contenu de l’état | account.id | metadata.account_id | Conservés |
|---|---|---|---|
| requête + outil + arguments | 0.18 | 0.20 | 51 / 124 |
| + les politiques suivies | 0.19 | 0.18 | 50 / 124 |
| + ce qui a déjà été fait | 0.33 | 0.25 | 40 / 124 |
| + les outils encore appelables | 0.73 | 0.76 | 27 / 124 |
Les deux colonnes centrales sont les scores attribués au champ dont la tâche dépend réellement. La dernière indique combien des 124 champs survivent à la coupe de 0,35.
L’ajout des compétences ne change rien. L’historique aide un peu. Le déclencheur est la liste des actions restantes. Tant que le scoreur ne sait pas qu’un appel billing_set_account_state(account_id, …) est en attente, un id de compte n’est qu’une chaîne de caractères comme une autre.
La forme générale, qui est la partie transposable à une autre configuration :
Un champ n’est pas utile en soi. Il est utile pour ce que l’agent s’apprête à en faire, et cette information n’est pas dans le payload. Elle se trouve dans le schéma des outils encore disponibles.
Où sont les gains, et où ils ne sont pas
Les deux mécanismes suivent des choses complètement différentes, et savoir lequel s’applique à votre charge de travail importe plus que la moyenne.
Le préchargement répond aux tours supprimablesPas à la taille du payload
- Idéal pour une tâche nécessitant une seule politique qui passerait un tour à la récupérer
- Sans valeur pour une tâche ne nécessitant aucune compétence
- Peut devenir contre-productif : une compétence mal chargée est renvoyée à chaque tour
Le filtrage répond à la densité du payloadPas à la longueur de la tâche
- Idéal là où la majorité des octets est du texte que personne ne lit
- Presque nul là où chaque champ est crucial
- Effet cumulatif, car un champ supprimé n’est pas renvoyé au tour suivant
L’écart est important. Sur la tâche où six articles du centre d’aide arrivent et où seul updated_at compte, le filtrage supprime 84 % du payload et 63 % des tokens d’entrée. Sur la tâche d’incident, où presque chaque champ est utilisé, il en supprime 5 %. Même agent, même seuil, un facteur 17 entre les deux.
Coût sur Opus 5, par tâche, agent simple contre les deux mécanismes :
| Tâche | Forme | Simple | Les deux | Gain |
|---|---|---|---|---|
| docs obsolètes | court · payload très clairsemé | 0,0639 $ | 0,0252 $ | −61 % |
| remboursement | moyen · mixte | 0,0419 $ | 0,0249 $ | −41 % |
| incident | court · dense | 0,0340 $ | 0,0241 $ | −29 % |
| relance | court · mixte | 0,0187 $ | 0,0135 $ | −28 % |
| recherche | un appel · clairsemé | 0,0083 $ | 0,0068 $ | −17 % |
| gdpr | moyen · mixte | 0,0336 $ | 0,0282 $ | −16 % |
| sla | long · mixte | 0,0442 $ | 0,0378 $ | −15 % |
| post-mortem | très long · mixte | 0,0906 $ | 0,0792 $ | −13 % |
| moyenne | 0,0419 $ | 0,0299 $ | −29 % |
Un agent Opus 5 traitant 10 000 tâches par mois passe de 419 $ à 299 $, dont 9 $ vont à Jev.
Le prix de votre modèle principal détermine si le filtrage en vaut la peine
C’est le résultat qui devrait changer votre approche.
Le filtrage coûte des tokens Jev à chaque appel d’outil. Ces tokens ont un prix fixe. Les tokens économisés sont tarifés au prix de votre modèle d’agent. C’est donc un ratio, et il s’inverse.
| Modèle d’agent | Prix d’entrée | Agent simple | Les deux mécanismes | |
|---|---|---|---|---|
| GPT-5.6 Luna | 0,20 $/M | 0,00182 $ | 0,00221 $ | +21 % |
| Claude Sonnet 5 | 2,00 $/M | 0,01676 $ | 0,01253 $ | −25 % |
| Claude Opus 5 | 5,00 $/M | 0,04191 $ | 0,02995 $ | −29 % |
Les nombres de tokens sont identiques partout. Seul le tarif de l’agent change. Sur le modèle bon marché, Jev représente 42 % de la facture et le filtrage coûte plus qu’il ne rapporte. Sur Opus 5, il représente 3 % de la facture.
Le point de bascule, en maintenant les nombres de tokens mesurés et la structure tarifaire habituelle, se situe à 0,55 $ par million de tokens d’entrée avec mise en cache du prompt, et 0,37 $ sans. En dessous, ne filtrez pas. Au-dessus, filtrez.
Le préchargement des compétences est rentable partout, même sur le modèle le moins cher, car il ne coûte presque rien : environ 1 500 tokens Jev par exécution, soit 0,00006 $, contre un tour économisé.
Il y a un effet de second ordre à connaître. Le cache divise approximativement la facture par deux et réduit la valeur relative du filtrage, car la plupart de ce que le filtrage supprime auraient été des lectures de cache peu coûteuses. Le filtrage a plus de valeur pour un déploiement sans cache que pour un déploiement avec cache.
Le mode de défaillance
Le seuil de 0,35 n’est sûr que grâce à l’état riche. Une version antérieure sans cet état a produit le pire genre d’échec.
Le filtre a supprimé account.id d’un abonnement Stripe, le notant 0,18, et a également supprimé metadata.account_id, la seconde copie. L’agent a pris le seul identifiant restant et a fait ceci :
appel:   billing_set_account_state(account_id="cus_PmT4k9WqLr2XbN", state="read_only")
                                              ↑ l’id client Stripe, pas celui du compte

rapport: "J’ai passé le compte associé en lecture seule, conformément à la politique du jour 10."
L’identifiant correct était acct_borealis_4c77. L’agent a agi sur le mauvais objet et a produit un rapport confiant à son sujet.
Tout ce que vous déployez a besoin de chemins critiques déclarés et d’un seuil calibré en fonction d’eux. Deux centièmes de seuil séparent “économise un tour” de “n’économise rien” côté routage, et l’écart est bien plus grand pour le filtrage.
Ce que j’en retire
Travailler sur l’efficacité de l’IA vaut le temps investi, et combiner des modèles de tailles et de types différents est là que se trouve une grande partie du gain. Ce qui est intéressant, c’est qu’un modèle incapable d’écrire du texte s’avère être un bon juge de ce qu’un modèle qui écrit du texte devrait être autorisé à voir.
Deux points de départ ont été testés ici. Il existe bien d’autres endroits où le même schéma pourrait s’appliquer : choisir quels fichiers un agent ouvre, décider quand une conversation doit être compactée, noter si un document récupéré vaut ses tokens, filtrer une écriture avant qu’elle n’ait lieu. Rien de tout cela n’a été mesuré, et je ne supposerais pas que cela fonctionne avant de l’avoir vérifié.
Le relevé complet se trouve ci-dessous : le harnais, chaque tâche, chaque seuil, tous les tableaux, et les éléments que ceci ne montre pas.
Les détails complets
Tout ce qui suit est l’expérience complète. C’est volontairement long. Si vous ne vouliez que le résultat, vous l’avez déjà.
La configuration
L’agent
Environ 80 lignes. Pas de framework, pas de SDK d’agent, pas de bibliothèque d’orchestration. Une boucle while autour de fetch :
- POST vers l’endpoint de complétion de chat d’OpenRouter avec la liste des messages et les schémas d’outils au format d’appel de fonction d’OpenAI.
- Si la réponse contient des
tool_calls, exécutez-en chacun localement, poussez le résultat comme un messagerole: "tool", et bouclez. - Si la réponse n’a pas de
tool_calls, ce texte est la réponse finale et la boucle s’arrête.
| Paramètre | Valeur | Note |
|---|---|---|
model | openai/gpt-5.6-luna | 0,20 $/M entrée, 1,20 $/M sortie, contexte de 1 050 000 tokens |
tools | 17 schémas de fonctions | |
tool_choice | auto | l’agent décide s’il doit appeler un outil et lequel |
seed | 1000 + index de répétition | la seule chose variant entre les répétitions |
max_tokens | 2000 | un plafond, pas une cible |
reasoning / reasoning_effort | non défini | laissé par défaut chez le fournisseur |
temperature, top_p | non défini | laissé par défaut chez le fournisseur |
Sur le raisonnement spécifiquement : aucun paramètre reasoning n’a été passé, le modèle a donc tourné avec le défaut du fournisseur. Un appel de contrôle effectué après renvoie reasoning_tokens: 0, donc aucun budget de raisonnement distinct n’a été dépensé et aucun des comptes de tokens n’inclut de tokens de raisonnement cachés. Relancer cela avec un effort de raisonnement plus élevé produirait des chiffres absolus différents.
Deux garde-fous, car une boucle d’agent incontrôlée brûle de l’argent : 8 tours maximum par exécution, et 6 appels d’outils maximum par tour. Aucun n’a été atteint lors des 192 exécutions. Un troisième garde-fou somme chaque appel et s’arrête une fois que le total dépasse un plafond, fixé à 2,60 $ pour la campagne.
Le monde
Une SaaS B2B fictive appelée Northwind Analytics, avec l’agent comme assistant des opérations.
17 outils dont les payloads imitent la forme réelle de Stripe, Zendesk, HubSpot, Statuspage, PagerDuty, Slack, Linear et d’un CMS de centre d’aide : mêmes noms de clés, même imbrication, même bruit. Ce sont des fonctions locales renvoyant des fixtures, donc rien ne quitte la machine. Les écritures sont enregistrées pour la notation et renvoient un accusé de réception plausible.
| Outil | Modélisé sur | Payload |
|---|---|---|
kb_list_articles | un endpoint de liste de CMS de centre d’aide | 28 128 car. |
stripe_list_charges | Stripe GET /v1/charges | 6 993 car. |
kb_get_article | un endpoint de lecture de CMS de centre d’aide | 4 966 car. |
stripe_get_subscription | Stripe GET /v1/subscriptions/:id | 3 181 car. |
zendesk_get_ticket | Zendesk GET /api/v2/tickets/:id avec side-loads | 2 402 car. |
pagerduty_get_incident | PagerDuty GET /incidents/:id | 1 821 car. |
statuspage_get_incident | Statuspage incident + uptime | 1 711 car. |
crm_get_account | objet société HubSpot | 1 117 car. |
read_skill | interne | 988 car. |
stripe_create_refund | Stripe POST /v1/refunds | 479 car. |
linear_create_issue | Linear issueCreate | 202 car. |
billing_apply_credit | API de facturation interne | 147 car. |
zendesk_reply | Zendesk PUT /api/v2/tickets/:id | 144 car. |
billing_set_account_state | API de facturation interne | 134 car. |
slack_post_message | Slack chat.postMessage | 124 car. |
billing_apply_discount | API de facturation interne | 98 car. |
pagerduty_escalate | escalation PagerDuty | 92 car. |
11 compétences, fichiers Markdown avec une description d’une ligne dans le front matter et un corps contenant les seuils, chiffres et formats réels : churn-save-offers, docs-review-cadence, dunning-playbook, enterprise-contract-terms, escalation-matrix, gdpr-data-requests, incident-comms, oncall-handover, refund-policy, release-notes-format, slack-style-guide. Plusieurs ne concernent aucune tâche. Ce sont des distracteurs pour le routeur.
8 tâches, choisies pour couvrir deux axes indépendants : la longueur, d’un seul appel d’outil à sept tours, et la densité du payload, de “chaque champ compte” à “76 % des octets sont du texte à jeter”.
Les tâches, verbatim
| Tâche | Prompt envoyé comme message utilisateur |
|---|---|
T1-refund | ACME Analytics (compte acct_acme_9f21) a envoyé un email : ils disent avoir été facturés deux fois pour leur facture de novembre. Vérifiez et réglez le problème complètement, y compris en prévenant l’équipe. |
T2-sla | Le ticket Zendesk 48213 est une demande de crédit SLA d’un client entreprise concernant octobre. Calculez ce qui leur est dû, appliquez-le et répondez-leur. |
T3-dunning | L’abonnement sub_1QdRvT2eZvKYlo2CkW8pQm4L est arrivé à échéance. Appliquez l’étape suivante selon notre processus. |
T4-gdpr | Le ticket 48377 vient d’arriver dans la boîte de réception confidentialité. Prenez le relais et faites tout ce que le processus exige. |
T5-incident | L’incident PD-99213 vient de se déclencher. Gérez l’escalade et les communications. |
T6-stale-docs | Lesquels de nos articles publiés dans le centre d’aide sont en retard de révision ? Suivez le travail à effectuer. |
T7-postmortem | L’incident INC-4471 est résolu. Faites le suivi : qui a été affecté, ce qui leur est dû, et informez l’entreprise de la situation. |
T8-lookup | Quel plan utilise acct_borealis_4c77 et qui est son CSM ? |
Notation
Déterministe. 59 contrôles sur les huit tâches, chacun étant soit un appel d’outil avec des arguments exacts, comme stripe_create_refund(charge="ch_3QRk9X…", amount=14900, reason="duplicate"), soit un fait qui apparaît uniquement à l’intérieur d’un document de compétence : le palier SLA de 25 %, la règle du jour 10, l’équipe PRIV, le délai de 30 jours.
Aucun juge LLM n’est impliqué. Une exécution qui n’ouvre jamais les compétences échoue mécaniquement au second type de contrôle, ce qui est le but : cela rend mesurable le fait de savoir si “l’agent possédait réellement la politique” plutôt que d’en faire une question d’opinion.
Chaque tâche déclare également ses chemins de payload critiques, les champs dont sa réponse dépend. Ceux-ci ne sont jamais utilisés pour orienter le filtre. Ils existent pour qu’un filtre trop zélé soit visible dans le relevé, même sur des exécutions qui réussissent malgré tout.
Les configurations (Arms)
| Configuration | Compétences préchargées | Payload filtré |
|---|---|---|
0 | non | non |
A | oui, seuil 0,55 | non |
B | non | oui, seuil 0,35, état riche |
D | oui, seuil 0,55 | oui, seuil 0,35, état riche |
8 tâches × 4 configurations × 6 répétitions = 192 exécutions, les répétitions différant uniquement par le seed.
Calibration
Les deux seuils ont été balayés hors ligne avant que des tokens d’agent ne soient dépensés.
0,55 pour le routage est la valeur la plus élevée qui maintient un rappel complet sur les tâches contre lesquelles il a été calibré. À 0,60, slack-style-guide obtient un score de 0,58 sur la tâche de remboursement et le tour économisé s’évapore. Deux centièmes séparent une réduction de tour de 15 % de rien du tout.
0,35 pour le filtrage n’est tenable qu’en raison de l’état riche décrit plus haut. La passe de calibration coûte environ 0,004 $ car elle fait tourner le routeur et le scoreur sans lancer l’agent.
Une leçon généralisable : chaque formulation d’une question a sa propre calibration. Un seuil ne se transfère pas entre deux formulations d’une même question. Des distributions sur des supports complètement différents ont été mesurées pour une formulation spécifique à la tâche et une formulation indépendante de la tâche. Recalibrez dès que vous reformulez.
Totaux de la campagne
| Mesure | Total |
|---|---|
| Exécutions | 192 |
| Tours d’agent | 775 |
| Tokens d’entrée agent | 2 118 338, dont 1 685 860 (80 %) servis depuis le cache |
| Tokens de sortie agent | 130 003 |
| Tokens d’entrée Jev | 2 065 975 |
| Appels Jev | 96 routage + 252 filtrage |
| Dépense réelle | agent 0,2977 $ · Jev 0,0868 $ |
| Total, incluant calibration et variantes écartées | 1,17 $ |
Global, par configuration
| Configuration | Exécutions parfaites | Contrôles validés | Tours | Tokens d’entrée | Chemins critiques supprimés |
|---|---|---|---|---|---|
0 | 92 % | 99 % | 4,44 | 12 960 | n/a |
A | 96 % | 99 % | 3,69 | 11 809 | n/a |
B | 94 % | 99 % | 4,31 | 9 967 | 0 |
D | 94 % | 99 % | 3,71 | 9 396 | 1 |
Aucune technique n’a dégradé la qualité. 99 % des contrôles passent dans les quatre configurations. Sur 96 appels filtrés dans la configuration D, exactement un chemin déclaré critique a été supprimé, et cette exécution a tout de même réussi. Les différences de “perfection” par exécution entre 92 % et 96 % sont négligeables pour n = 48. Les effets robustes concernent les tours et les tokens.
Tokens moyens par exécution, répartis selon la facturation réelle :
| Configuration | Entrée fraîche | Entrée cachée | Sortie | Entrée Jev |
|---|---|---|---|---|
0 | 2 941 | 10 020 | 741 | 0 |
A | 2 700 | 9 109 | 615 | 1 517 |
B | 1 873 | 8 093 | 723 | 19 457 |
D | 1 496 | 7 900 | 629 | 22 067 |
La configuration D réduit les tokens d’entrée frais, les plus coûteux, de 49 %.
Économie de tokens d’entrée par technique, du pire au meilleur
| Technique | Minimum | Maximum | Médiane |
|---|---|---|---|
A préchargement compétences | −3 % sur la tâche SLA | +23 % sur la tâche GDPR | 10 % |
B filtrage payload | +2 % sur la tâche GDPR | +51 % sur docs obsolètes | 17 % |
D les deux | +9 % sur le post-mortem | +63 % sur docs obsolètes | 26 % |
La seule cellule négative de toute la matrice est A sur la tâche SLA, où le routeur charge une compétence de trop sans supprimer de tour. La compétence supplémentaire entre dans le prompt système et est renvoyée à chaque tour. Les deux techniques ne s’additionnent pas toujours : sur les tâches SLA et post-mortem, D économise moins de tokens que B seul, pour exactement cette raison.
Comment le routeur a réellement noté
Probabilité moyenne par compétence, par tâche. “Chargé” signifie un score égal ou supérieur à 0,55.
| Tâche | Compétences chargées | Meilleurs scores |
|---|---|---|
T1-refund | 2,0 | refund-policy 0,82 · slack-style-guide 0,60 · incident-comms 0,32 |
T2-sla | 2,0 | enterprise-contract-terms 0,95 · refund-policy 0,84 · churn-save-offers 0,13 |
T3-dunning | 1,0 | dunning-playbook 0,95 · churn-save-offers 0,32 · oncall-handover 0,13 |
T4-gdpr | 1,0 | gdpr-data-requests 0,87 · refund-policy 0,27 · escalation-matrix 0,22 |
T5-incident | 3,0 | escalation-matrix 0,93 · incident-comms 0,85 · slack-style-guide 0,69 |
T6-stale-docs | 1,0 | docs-review-cadence 0,93 · slack-style-guide 0,15 · oncall-handover 0,05 |
T7-postmortem | 3,0 | enterprise-contract-terms 0,92 · refund-policy 0,89 · incident-comms 0,58 · slack-style-guide 0,47 |
T8-lookup | 0,0 | slack-style-guide 0,07 · enterprise-contract-terms 0,06 · dunning-playbook 0,04 |
Rappel : 132 des 144 compétences nécessaires ont été chargées, soit 92 %. Un oubli systématique et un faux positif systématique, tous deux dignes d’être mentionnés.
L’oubli est slack-style-guide sur la tâche post-mortem, avec un score de 0,47, sous le seuil, dans 12 exécutions sur 12. La tâche dit “informez l’entreprise de la situation” et le routeur ne lit pas cela comme une question de formatage. L’agent l’a récupérée lui-même quand il en a eu besoin.
Le faux positif est refund-policy sur la tâche SLA à 0,84 et le post-mortem à 0,89. Un crédit SLA ressemble à un remboursement. C’est exactement la confusion que refund-policy existe pour interdire, car le document précise que l’indisponibilité du service n’est pas un remboursement. Le routeur se trompe sur la forme mais a raison sur le fond, et l’agent n’en a pas souffert.
La tâche de recherche ne charge rien, correctement. Aucune compétence ne la concerne et le score le plus élevé est de 0,07.
Comment le filtre a réellement réagi
Configuration D, par outil, sur 96 appels filtrés :
| Outil | Appels | Car. avant → après | Changement | Clés conservées |
|---|---|---|---|---|
kb_list_articles | 8 | 225 024 → 24 834 | −89 % | 605 / 1 808 |
stripe_list_charges | 6 | 41 958 → 12 819 | −69 % | 405 / 1 584 |
stripe_get_subscription | 6 | 19 086 → 10 637 | −44 % | 359 / 744 |
crm_get_account | 30 | 29 400 → 16 723 | −43 % | 384 / 1 002 |
zendesk_get_ticket | 12 | 25 620 → 15 787 | −38 % | 328 / 822 |
statuspage_get_incident | 9 | 15 399 → 10 734 | −30 % | 311 / 540 |
pagerduty_get_incident | 12 | 21 852 → 16 497 | −25 % | 428 / 684 |
stripe_create_refund | 6 | 3 012 → 2 610 | −13 % | 60 / 108 |
zendesk_reply | 12 | 8 685 → 9 489 | +9 % | 24 / 84 |
linear_create_issue | 18 | 5 287 → 6 734 | +27 % | 83 / 138 |
billing_apply_credit | 8 | 1 343 → 2 406 | +79 % | 42 / 56 |
Les outils de lecture sont ceux qui rapportent, et l’écart entre eux est énorme : de −89 % sur une liste de documents à −25 % sur un incident où presque tout est crucial.
Les accusés de réception d’écriture vont dans le mauvais sens. billing_apply_credit renvoie 147 caractères, et le marqueur _trimmed ajouté coûte plus cher que les champs supprimés. Filtrer un petit payload est une perte nette, et toute implémentation de production devrait ignorer tout ce qui fait moins de quelques centaines de caractères. Cela a été laissé pour que l’effet soit visible dans le relevé.
Chaque tâche, chaque configuration
Les prix sont le coût total d’une exécution, agent plus Jev, en utilisant la répartition mesurée entre frais et cache. Les colonnes Sonnet 5 et Opus 5 rejouent le trafic mesuré aux tarifs de ces modèles. Le coût de Jev est identique dans les trois colonnes.
T1-refund, moyen · payload mixte
| Configuration | Parfait | Contrôles | Tours | Tokens entrée | Coupe payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 4,5 | 15 369 | n/a | 0,00180 | 0,0167 | 0,0419 | n/a |
A | 100 % | 100 % | 4,0 | 14 247 (−7 %) | n/a | 0,00165 | 0,0150 | 0,0373 | −11 % |
B | 100 % | 100 % | 4,3 | 10 719 (−30 %) | 65 % | 0,00285 | 0,0141 | 0,0331 | −21 % |
D | 100 % | 100 % | 4,0 | 9 899 (−36 %) | 66 % | 0,00252 | 0,0108 | 0,0249 | −41 % |
T2-sla, long · payload mixte
| Configuration | Parfait | Contrôles | Tours | Tokens entrée | Coupe payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 83 % | 96 % | 6,8 | 18 811 | n/a | 0,00192 | 0,0177 | 0,0442 | n/a |
A | 100 % | 100 % | 6,2 | 19 359 (+3 %) | n/a | 0,00193 | 0,0174 | 0,0433 | −2 % |
B | 83 % | 96 % | 6,5 | 15 528 (−17 %) | 30 % | 0,00286 | 0,0173 | 0,0417 | −6 % |
D | 83 % | 96 % | 6,0 | 16 533 (−12 %) | 72 % | 0,00312 | 0,0160 | 0,0378 | −15 % |
T3-dunning, court · payload mixte
| Configuration | Parfait | Contrôles | Tours | Tokens entrée | Coupe payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 4,0 | 8 084 | n/a | 0,00080 | 0,0075 | 0,0187 | n/a |
A | 100 % | 100 % | 3,0 | 6 704 (−17 %) | n/a | 0,00079 | 0,0069 | 0,0171 | −9 % |
B | 100 % | 100 % | 4,0 | 7 384 (−9 %) | 44 % | 0,00129 | 0,0069 | 0,0163 | −13 % |
D | 100 % | 100 % | 3,0 | 6 002 (−26 %) | 44 % | 0,00123 | 0,0058 | 0,0135 | −28 % |
T4-gdpr, moyen · payload mixte
| Configuration | Parfait | Contrôles | Tours | Tokens entrée | Coupe payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 50 % | 94 % | 4,2 | 8 344 | n/a | 0,00150 | 0,0134 | 0,0336 | n/a |
A | 100 % | 100 % | 3,0 | 6 467 (−23 %) | n/a | 0,00132 | 0,0114 | 0,0285 | −15 % |
B | 83 % | 98 % | 4,2 | 8 167 (−2 %) | 14 % | 0,00186 | 0,0129 | 0,0315 | −6 % |
D | 83 % | 98 % | 3,0 | 6 159 (−26 %) | 16 % | 0,00178 | 0,0116 | 0,0282 | −16 % |
T5-incident, court · payload dense
| Configuration | Parfait | Contrôles | Tours | Tokens entrée | Coupe payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 3,8 | 8 647 | n/a | 0,00151 | 0,0136 | 0,0340 | n/a |
A | 67 % | 96 % | 3,0 | 7 004 (−19 %) | n/a | 0,00121 | 0,0104 | 0,0259 | −24 % |
B | 83 % | 98 % | 3,7 | 8 153 (−6 %) | 6 % | 0,00168 | 0,0127 | 0,0313 | −8 % |
D | 83 % | 98 % | 3,0 | 6 935 (−20 %) | 5 % | 0,00143 | 0,0099 | 0,0241 | −29 % |
T6-stale-docs, court · payload très clairsemé
| Configuration | Parfait | Contrôles | Tours | Tokens entrée | Coupe payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 4,0 | 19 821 | n/a | 0,00265 | 0,0256 | 0,0639 | n/a |
A | 100 % | 100 % | 3,0 | 18 468 (−7 %) | n/a | 0,00260 | 0,0246 | 0,0614 | −4 % |
B | 100 % | 100 % | 4,0 | 9 639 (−51 %) | 78 % | 0,00262 | 0,0139 | 0,0329 | −49 % |
D | 100 % | 100 % | 3,0 | 7 387 (−63 %) | 84 % | 0,00235 | 0,0109 | 0,0252 | −61 % |
T7-postmortem, très long · payload mixte
| Configuration | Parfait | Contrôles | Tours | Tokens entrée | Coupe payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 6,0 | 21 294 | n/a | 0,00406 | 0,0363 | 0,0906 | n/a |
A | 100 % | 100 % | 5,3 | 19 224 (−10 %) | n/a | 0,00339 | 0,0297 | 0,0743 | −18 % |
B | 100 % | 100 % | 5,7 | 17 064 (−20 %) | 34 % | 0,00488 | 0,0343 | 0,0841 | −7 % |
D | 100 % | 100 % | 5,7 | 19 430 (−9 %) | 33 % | 0,00472 | 0,0324 | 0,0792 | −13 % |
T8-lookup, un appel · payload clairsemé
| Configuration | Parfait | Contrôles | Tours | Tokens entrée | Coupe payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 2,2 | 3 314 | n/a | 0,00036 | 0,0033 | 0,0083 | n/a |
A | 100 % | 100 % | 2,0 | 3 004 (−9 %) | n/a | 0,00038 | 0,0030 | 0,0073 | −12 % |
B | 100 % | 100 % | 2,2 | 3 080 (−7 %) | 62 % | 0,00047 | 0,0026 | 0,0062 | −24 % |
D | 100 % | 100 % | 2,0 | 2 819 (−15 %) | 62 % | 0,00056 | 0,0029 | 0,0068 | −17 % |
Comment les prix ont été calculés
Mesurer une fois, puis recalculer le prix. Les nombres de tokens sont la base, et la facture de chaque modèle correspond à ces mêmes nombres aux tarifs du modèle.
La formule de facturation a été rétro-ingéniée à partir des données plutôt que supposée. Sur les 192 exécutions, le coût de l’agent observé correspond à
entrée_fraîche × 0,25 $/M + entrée_cachée × 0,02 $/M + sortie × 1,20 $/Mavec une erreur relative médiane de 0,04 %. Deux conséquences. La mise en cache du prompt était active tout le temps, automatiquement, sans marqueurs cache_control, et 80 % des tokens d’entrée étaient des lectures de cache. Et chaque token d’entrée frais est facturé au tarif d’écriture du cache, soit 1,25 fois le prix d’entrée nominal, donc le tarif nominal de 0,20 $/M n’est pratiquement jamais ce que vous payez dans une boucle multi-tours.
Un modèle théorique antérieur de mise en cache, où les lectures au tour t étaient égales au préfixe au tour t−1, sous-estimait les lectures de cache réelles de 19 %. Il a été abandonné au profit de la répartition mesurée par tour.
| Modèle | Entrée | Sortie | Lecture cache | Écriture cache |
|---|---|---|---|---|
openai/gpt-5.6-luna | 0,20 $/M | 1,20 $/M | 0,02 $/M | 0,25 $/M |
anthropic/claude-sonnet-5 | 2,00 $/M | 10,00 $/M | 0,20 $/M | 2,50 $/M |
anthropic/claude-opus-5 | 5,00 $/M | 25,00 $/M | 0,50 $/M | 6,25 $/M |
typesafe/jev-1.13 | 0,042 $/M | gratuite | n/a | n/a |
| Configuration | Luna | Sonnet 5 | Opus 5 | Part de Jev, Opus 5 |
|---|---|---|---|---|
0 | 0,00182 $ | 0,01676 $ | 0,04191 $ | n/a |
A | 0,00166 $ (−9 %) | 0,01479 $ (−12 %) | 0,03688 $ (−12 %) | 0 % |
B | 0,00232 $ (+27 %) | 0,01435 $ (−14 %) | 0,03466 $ (−17 %) | 2 % |
D | 0,00221 $ (+21 %) | 0,01253 $ (−25 %) | 0,02995 $ (−29 %) | 3 % |
Les mêmes exécutions sans aucune mise en cache, pour référence :
| Configuration | Luna | Sonnet 5 | Opus 5 |
|---|---|---|---|
0 | 0,00348 $ | 0,03333 $ | 0,08332 $ |
A | 0,00316 $ | 0,02984 $ | 0,07450 $ |
B | 0,00368 $ | 0,02798 $ | 0,06874 $ |
D | 0,00356 $ | 0,02601 $ | 0,06362 $ |
Une hypothèse est conservatrice plutôt que neutre. OpenAI met en cache automatiquement et facture chaque token d’entrée frais au tarif d’écriture, ce qui a été mesuré. La mise en cache d’Anthropic est optionnelle : seul le contenu à l’intérieur d’un point d’arrêt cache_control est facturé au tarif d’écriture et le reste au tarif d’entrée simple. Facturer tous les tokens frais au tarif d’écriture surestime donc légèrement les colonnes Anthropic. Le recalcul avec les tokens frais au tarif d’entrée simple déplace la moyenne d’Opus 5 de 0,04191 $ → 0,02995 $ (−29 %) à 0,03823 $ → 0,02808 $ (−27 %), et aucun chiffre par tâche ne bouge de plus de 3 points.
Ce que cela ne montre pas
- Un seul modèle d’agent. Tout est mesuré sur
openai/gpt-5.6-lunaavec le raisonnement par défaut. Les nombres de tokens sont la donnée et les colonnes de prix sont des calculs basés sur eux. Un modèle différent produirait des nombres de tokens différents, pas seulement des prix différents. - n = 6 par cellule. Suffisant pour les nombres de tours et de tokens, qui sont quasi déterministes. Pas assez pour séparer une qualité de 92 % d’une qualité de 96 %.
- Fixtures, pas d’API réelles. Les formes de payload sont fidèles. Les endpoints réels ont une pagination, des échecs partiels et des limites de débit que ce harnais n’exerce pas.
- Les tâches ont été écrites par la même personne que les compétences. La notation est déterministe, mais le monde n’est pas adverse.
- La propre calibration de Jev n’a pas été auditée. Ce qui a été mesuré est l’effet de ses scores sur un agent, et non si ils sont bien calibrés au sens statistique.
- Une seule structure d’agent. Une boucle
whileavec appel de fonction. Les sous-agents, les appels d’outils parallèles et les sessions de longue durée changent tous l’arithmétique.