

La plupart des agents IA ne devraient pas être des agents
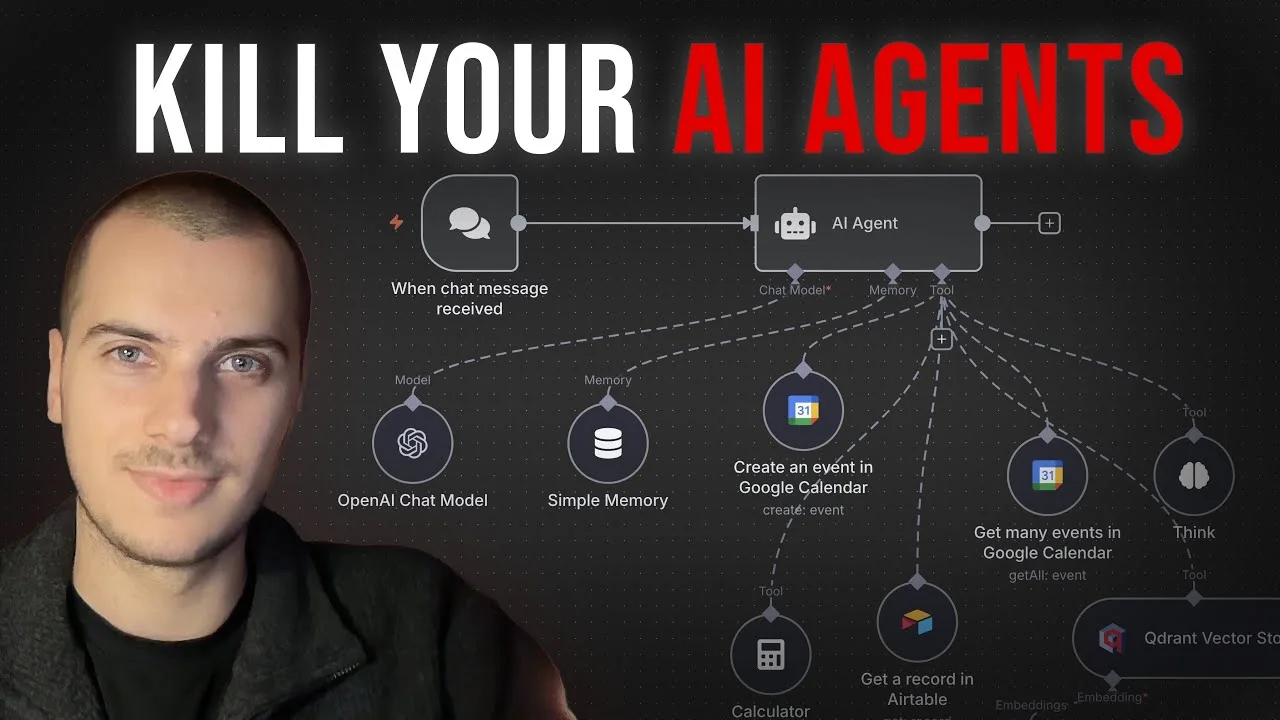
Quand les agents sont arrivés dans n8n, j’en ai créé beaucoup. Il suffit d’ajouter un nœud Agent, de lui connecter trois outils, et il choisit lequel appeler. On avait l’impression que tout était devenu facile.
Au cours des mois suivants, j’en ai retiré la plupart. Dans les workflows qui devaient passer à l’échelle et fonctionner réellement en production, il ne me reste qu’environ un cinquième des agents que j’avais.
Pas parce que les agents sont mauvais. Mais, pour la plupart des tâches que je faisais, l’agent prenait à l’exécution des décisions que je connaissais déjà au moment de la conception, et me facturait ce privilège à chaque tour.
Le workflow que je prends pour exemple
Un chatbot d’assistance. Un déclencheur de chat, un agent exécuté sur un grand modèle, et un seul outil : une requête HTTP vers un point de terminaison de recherche qui répond aux questions à partir de mes documents. Quelqu’un pose une question sur le produit, l’agent appelle l’outil, lit la réponse et rédige son message.
Agent de connaissances IA
- À la réception d’un message de chat
- Agent de connaissances IAgpt-4.1Modèle de chatModèle de chat OpenAIgpt-4.1MémoireMémoire simpleOutilInterroger la base de connaissancesRequête HTTP. L’agent rédige la requête et décide quand l’envoyer
Quelqu’un dit bonjour, et vous payez pour un modèle de pointe
Envoyez « hi » à cet agent. En environ 1.3 seconde, vous obtenez une réponse aimable, rédigée par l’un des plus grands modèles disponibles.
Aucun outil n’a été appelé. Rien n’a été recherché. Tout le prompt système a été envoyé comme jetons d’entrée, y compris chaque ligne décrivant des outils qui n’ont jamais servi.
- Le message arrive"hi"1 jeton
- Le prompt système complet est envoyéChaque description d’outil, chaque règle indiquant quand appeler quoila totalité
- Le grand modèle prend une décisionIl décide de ne rien appeler
- Le grand modèle répond"Hey, how can I assist you today?"
Le bonjour est un cas facile à comprendre, mais il n’a rien d’exceptionnel. Dans un chatbot, une grande partie des messages ne nécessite ni recherche ni consultation.
La même chose, écrite noir sur blanc
Voici la version de remplacement. Elle comporte plus de nœuds, mais chacun correspond à une décision que j’ai prise une fois, plutôt qu’à une décision qu’un modèle prend à chaque message.
Chatbot RAG intelligent et efficace
- À la réception d’un message de chat
- Rechercher les messages précédentsGestionnaire de mémoire, mode chargementChat ModelMémoire simple
- Routeur d’intentionClassificateur de texte, deux catégoriesChat ModelTrès petit modèlegpt-4.1-nano
aucune récupération de connaissances nécessaire
- Réponse simpleChaîne LLM de base avec le même tout petit modèle
récupération de connaissances nécessaire
- Préparer la requête de récupérationChaîne LLM de base, gpt-4.1-mini
- RAG via LookioSimple requête HTTP. Aucun modèle à cette étape
- Rédiger la réponse finaleChaîne LLM de base, gpt-4.1. Le seul grand modèle du canevas
- Répondre dans le chat
- Stocker les messagesGestionnaire de mémoire, mode insertion
D’abord, orienter avec un modèle gratuit
Le seul rôle du classificateur de texte est de choisir le parcours du message. Deux catégories, chacune accompagnée d’une description :
- Aucune récupération de connaissances nécessaire. Salutations, confirmations, bavardage. Tout ce à quoi on peut répondre sans rien consulter.
- Récupération de connaissances nécessaire. Le message nécessite des informations tirées des documents pour pouvoir y répondre.
La classification est une tâche légère, que les petits modèles accomplissent très bien. Elle est assez rapide pour que son effet sur la latence totale soit à peine perceptible, et assez peu coûteuse pour que je n’y pense même plus.
Pour le parcours économique, une chaîne LLM de base utilise ce même tout petit modèle avec un court prompt système. « Salut » obtient maintenant une réponse en deux secondes environ, qui se lit exactement de la même façon, avec un modèle dont le coût par jeton représente une fraction de celui qu’il remplace.
Un seul nœud de modèle alimente à la fois le routeur et la réponse simple. Ce sont des tâches différentes, mais de même envergure. Et comme le modèle se change à un seul endroit, il m’arrive vraiment d’en essayer un autre, au lieu de modifier deux nœuds et d’oublier le second.
J’applique la même approche à la barre latérale du chat : générer les titres des conversations à intervalles réguliers avec un petit modèle au lieu de générer un titre à chaque message.
Configurer le déclencheur pour répondre depuis un nœud
Un petit détail qui peut bloquer toute la conception si on le rate. Par défaut, un déclencheur de chat répond à partir du dernier nœud, alors que ce workflow comporte deux parcours qui doivent tous deux répondre.
Réglez le mode de réponse du déclencheur sur « répondre depuis un nœud », puis placez un nœud Répondre dans le chat à la jonction des branches. Sans cela, impossible de proposer à la fois un parcours économique et un parcours coûteux qui répondent tous les deux. Or, c’est précisément l’intérêt du routage.
Le parcours de récupération, en trois nœuds
Regardez ce que l’agent a fait pour une vraie question. Le grand modèle a été appelé, a passé 600ms à traiter la demande et a décidé d’appeler l’outil. Bonne décision. Mais le résultat de toute cette intelligence se résume à une courte chaîne de requête, à peu près une version nettoyée de ce que l’utilisateur venait de saisir. Et pour la rédiger, il a fallu renvoyer tout le prompt système.
Tâches du tourToutes exécutées par le grand modèle
- Décider si une récupération est nécessaire
- Rédiger une courte requête de recherche
- Rédiger la réponse finale à partir des résultats obtenus
Besoins de chaque tâcheEn choisissant un modèle par étape
- Un classificateur, petit modèle
- Une reformulation, modèle léger
- Un grand modèle, qui se justifie ici
Le parcours se compose donc de trois nœuds plutôt que d’un seul agent.
Préparer la requête de récupération est une chaîne LLM de base qui utilise un modèle mini. Son prompt système : à partir du message de l’utilisateur, formuler une requête courte et concise à envoyer à l’outil de récupération de connaissances, puis la fournir directement sous forme de question. Lors de mes tests, le petit modèle a formulé la même requête que le grand.
RAG via Lookio est une simple requête HTTP. La requête est placée dans le corps, tandis que l’identifiant de l’assistant et le mode sont des valeurs fixes que j’ai choisies, et non des paramètres qu’un modèle pourrait faire varier. La plupart des outils ajoutés à un agent reposent sur une API, et la plateforme fournit généralement un nœud prêt à l’emploi, qu’il suffit d’insérer.
L’étape « Rédiger la réponse finale » reçoit le message d’origine et le contenu récupéré, clairement identifiés, puis rédige la réponse. Elle reste sur le grand modèle, car c’est dans la formulation de la réponse finale que la qualité se voit.
La mémoire est désormais à votre charge
C’est ce que l’agent faisait pour vous, et ce qu’il vous faut maintenant réintégrer.
Un nœud d’agent prend en charge un sous-nœud de mémoire. Si vous découpez l’agent en étapes, plus rien ne s’en occupe : la conversation est donc chargée une fois au début et enregistrée une fois à la fin.
- Rechercher les messages précédentsGestionnaire de mémoire en mode chargement, juste après le déclencheurune fois
- Chaque prompt l’ajouteLe routeur, la réponse simple et les deux étapes de récupération reçoivent chacun l’historique×4
- Répondre dans le chatLa réponse est renvoyée à l’utilisateur
- Enregistrer les messagesGestionnaire de mémoire en mode insertion : le message de l’utilisateur et la réponseune fois
C’est plus de travail. Mais c’est aussi là qu’on réalise qu’un agent transmettait toute la conversation à chaque étape, alors qu’une étape de réécriture de requête n’a besoin que des deux derniers messages, pas des vingt derniers.
Ce que l’on y gagne
AgentDécidé à l’exécution
- Grand modèle à chaque étape, même pour une salutation
- Instructions système et descriptions des outils à chaque appel
- Peut ignorer un outil et répondre de mémoire
- Peut modifier l’ordre, et vous ne le découvrez qu’en production
Étapes explicitesDécidées à la conception
- Grand modèle dans un seul nœud sur cinq
- Aucune description d’outil
- La récupération s’exécute toujours, puisqu’elle constitue une étape
- L’ordre est celui que vous avez défini
La troisième ligne est celle qui compte le plus à mes yeux. Quand un agent ignore un outil et répond en fonction de ce qu’il sait, c’est un échec impossible à reproduire et à tester. Un workflow ne peut pas faire ça. Le nœud est là, il s’exécute.
Quand je fais encore appel à un agent
Quand je ne connais vraiment pas l’ordre des étapes. Pour une recherche ouverte, par exemple, où la deuxième requête dépend des résultats de la première. Ou pour tout ce dont le nombre d’étapes est impossible à prévoir.
C’est le critère que j’utilise maintenant : est-ce que je peux dessiner le processus sur papier avant son exécution ? Si oui, l’agent fait payer un modèle pour qu’il redécouvre mon schéma à chaque requête.
La même question, à un autre niveau
C’est cette habitude que l’on peut transposer. Dans Claude Code ou Codex, beaucoup de choses que je fais suivent le même schéma que ce bot d’assistance, et les postes coûteux sont les mêmes : renvoyer tout le contexte pour une étape qui n’en avait besoin que d’une fraction, ou laisser un modèle redécouvrir quelque chose que je savais déjà.
Savoir ce que coûte un appel d’outil, parce qu’on en a configuré un manuellement et observé le nombre de jetons, permet de repérer ce qui se passe dans un environnement d’exécution qui ne montre presque rien.
Ouvrez vos propres agents et examinez leurs exécutions. Pour chacune, demandez-vous si vous auriez pu en dessiner les étapes avant qu’elle ne démarre. Pour la plupart des miens, la réponse est oui.