

Comment livrer des MCP 10/10
La plupart des gens déploient un serveur MCP comme ils déployaient autrefois une API REST. Ils écrivent les schémas Zod, essaient deux prompts qui suivent le parcours idéal dans Claude Desktop, voient une réponse positive et considèrent le travail terminé.
Puis de vrais agents débarquent et subissent ça en silence.
Il y a quelques semaines, j’ai écrit un article sur la façon de donner aux agents un outil pour vous envoyer leurs retours lorsqu’ils tombent sur quelque chose de déroutant en production. Cet outil à lui seul a commencé à détecter des bugs de schéma dont je n’aurais jamais entendu parler de la part d’un utilisateur humain. Après avoir constaté la qualité de ces rapports, la suite était évidente : pourquoi attendre qu’un agent client bute sur mon interface en production, alors que je peux envoyer vingt agents tout neufs tester chaque accès avant la mise en ligne ?
Voilà toute la méthode que j’utilise désormais. J’ai mené 94 sessions d’agents de bout en bout sur le serveur MCP, l’API REST, la CLI et le SDK de mon produit, avec plusieurs niveaux de modèles. J’ai corrigé les problèmes détectés et publié le banc de test en open source sous le nom agent-surface-tester.
Pourquoi les agents donnent de meilleurs retours UX que les humains
Obtenir des retours honnêtes sur un produit de la part de développeurs est difficile. Lorsqu’un développeur tombe sur un endpoint mal conçu, il devine le nom d’un champ, reçoit une erreur 400, parcourt votre documentation, comprend la particularité, code une solution de contournement en dur, puis retourne à son propre travail. Ou bien il ferme l’onglet et choisit un autre outil. Dans les deux cas, vous n’en savez rien.
Même quand, exceptionnellement, quelqu’un vous écrit, c’est deux jours plus tard. Il reformule l’erreur de mémoire, oublie d’indiquer la charge utile envoyée et atténue sa critique, car personne ne veut paraître impoli dans un ticket d’assistance.
Pour les parties de votre produit utilisées par un agent, les agents sont bien plus faciles à comprendre.
Attendre les développeurs humainsLent et filtré
- Contourner en silence les noms de champs mal choisis
- Abandonner sans vous dire pourquoi
- Signaler les problèmes plusieurs jours après, de mémoire
- Édulcorer les critiques par politesse
- Passer des heures en entretiens pour observer leur usage
Écouter les agentsInstantané et direct
- Aucun ego, aucun filtre de politesse
- La charge utile et l’erreur exactes toujours disponibles
- Expliquer ce que votre schéma leur a fait anticiper
- Tester les 48 outils en deux minutes, à la demande
- Faire une visite complète du produit pour un demi-centime
Un agent se moque de vos états d’âme. Il a lu la description de votre outil, s’est fait une idée précise de ce qui allait se passer, a envoyé du JSON et a été surpris. Lui demander où se trouvait l’écart vous permet d’auditer directement vos noms, vos enveloppes d’erreur, votre pagination et les exemples manquants.
Les deux moitiés d’une même boucle
Pour rapprocher un MCP (ainsi que l’API, la CLI et le SDK qui l’accompagnent) de la note de 10/10, j’utilise deux canaux qui s’alimentent mutuellement.
Comment amener une interface destinée aux agents à
10 sur 10
La première moitié est passive. Chaque serveur MCP que je crée est livré avec send_feedback (présenté dans mon précédent article). Pendant que je reconstruisais Lookio pour prendre en charge une interface plus étendue (48 outils MCP, 46 endpoints REST, 70 commandes CLI et un SDK TypeScript), la session ChatGPT d’un véritable utilisateur a appelé send_feedback douze fois de sa propre initiative au cours d’une utilisation normale.
Voici trois des bugs révélés par cette seule session en direct :
- Un schéma JSON impossible à valider. Dans
sync_sitemap, le paramètreinclude_unchangedavaittype: "boolean"ainsi queenum: ["true", "false"]. La validation stricte rejetait aussi bientrueque"true". Un humain qui parcourt rapidement la documentation ne remarque jamais une annotation de schéma défectueuse comme celle-là. Un client MCP se retrouve bloqué dès le premier échange. - Une pagination contradictoire.
list_resourcesrenvoyaittruncated: falsetout en fournissant un curseurnext_offset. L’agent s’est arrêté et a posé une question légitime : dois-je arrêter la pagination parce quetruncatedvaut false, ou continuer parce quenext_offsetest présent ? - Une perte de données silencieuse lors de la réindexation. Appeler
update_resourcepour découper à nouveau un document effaçait discrètement son URLsource, à moins que l’appelant ne pense à renvoyer l’ancienne URL.
Aucun utilisateur de cette fenêtre ChatGPT ne m’aurait envoyé de courriel à propos de ces problèmes. L’agent a contourné ce qu’il pouvait, consigné en arrière-plan douze rapports de reproduction précis, puis terminé le travail de l’utilisateur.
Pourquoi votre agent de programmation dans Cursor ne peut pas effectuer le test
Une fois qu’on voit ce genre de rapports, on veut les recevoir avant le déploiement. Le réflexe évident, c’est d’ouvrir votre dépôt dans Claude Code ou Cursor et de saisir : « Teste mon serveur MCP et dis-moi ce qui prête à confusion. »
J’ai commencé par essayer cette méthode. Elle passe à côté de la moitié des bugs, car votre agent de programmation en sait déjà trop.
Cinq minutes plus tôt, cette même session a lu vos gestionnaires de routes, vos validateurs Zod et votre schéma de base de données. Quand llms.txt ne précise pas si le champ du corps s’appelle text ou content, votre agent de programmation ne bute pas dessus. Il se souvient que votre code source utilise text. Vous obtenez un test sans erreur, vous êtes satisfait de votre documentation, puis le tout premier agent externe reçoit une erreur 400.
Un agent d’un utilisateur réel arrive sans aucun contexte. Il n’a jamais vu votre dépôt et n’a qu’une seule porte d’entrée vers votre produit :
- Un agent MCP ne voit que les schémas de
tools/listet les réponses des outils. - Un agent REST API ne voit qu’un client HTTP et votre fichier public
llms.txtou votre spécification OpenAPI. - Un agent CLI ne voit que votre binaire et
--help. - Un agent SDK ne voit que le README de votre package et les méthodes exportées.
Autre technique : laisser votre agent de code piloter un vrai navigateur ouvert sur ChatGPT
Votre agent de code ne peut pas tester votre MCP directement depuis son propre terminal sans biais. Mais pendant le développement actif d’une fonctionnalité, j’utilise souvent une autre technique : laisser l’agent de code piloter un vrai navigateur ouvert sur ChatGPT.
Quand je crée un MCP qui affiche des cartes interactives ou des widgets canvas, comme le générateur de sites d’Atelier201, j’ouvre un volet de navigateur à côté, connecté à ChatGPT. Ce compte ChatGPT peut accéder au serveur MCP local, mais la conversation ChatGPT n’a aucun contexte sur le dépôt. Elle n’a jamais vu mon code.
Mon agent de code dans Claude Code dirige les tests :
- Il ouvre ChatGPT dans le volet du navigateur et lance une nouvelle conversation.
- Il saisit de vraies demandes d’utilisateurs dans ChatGPT, par exemple pour lui demander de réécrire un titre ou de modifier une mise en page.
- Il observe ChatGPT sélectionner des outils du MCP et afficher la carte obtenue dans le navigateur, tout en consultant les journaux du serveur de développement local pour voir en temps réel les charges utiles reçues, les codes d’état et les latences.
- Si ChatGPT interprète mal un paramètre ou si la carte ne se met pas à jour, Claude Code repère directement l’échec dans les journaux, corrige le code du serveur et relance le test dans le navigateur.
- 1Requête dans le navigateurFonctionne sans aucun contexte du dépôt
- 2ChatGPT appelle MCPExécute les outils et met à jour la carte
- 3Flux des journaux du serveurSurveille les charges utiles, les latences et les erreurs
- 4Corriger et recommencerCorrige le code et lance un nouveau test immédiatement
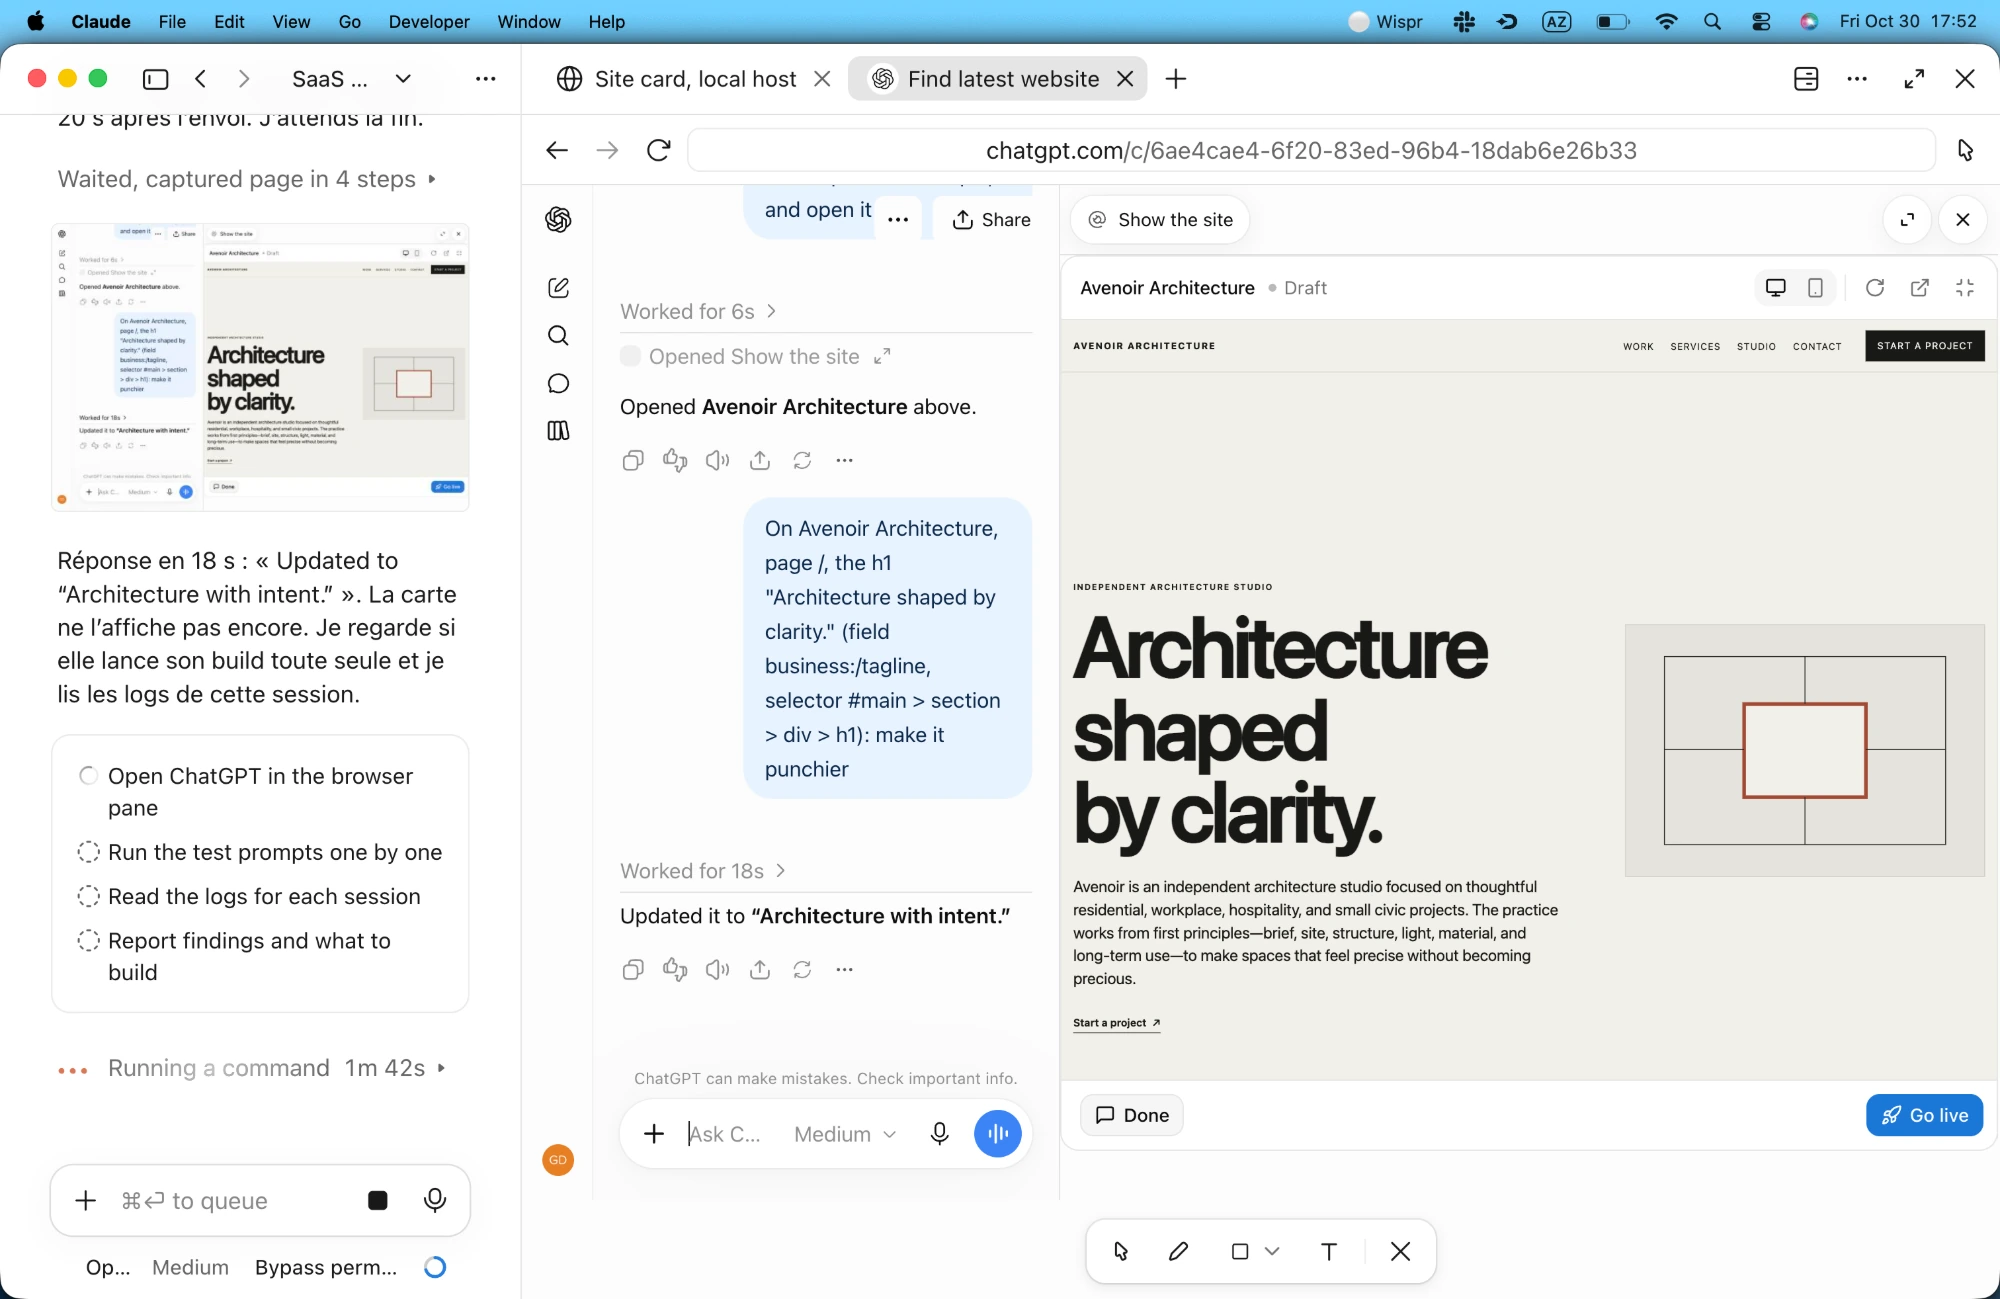
Cette boucle interactive est particulièrement efficace pendant le développement actif d’une fonctionnalité. Vous voyez un véritable modèle utilisateur interagir en temps réel avec votre serveur et votre interface.
Pour les tests automatisés avant une mise en production, en revanche, mieux vaut éviter d’ouvrir une fenêtre de navigateur et d’attendre les animations de saisie. Il vous faut des tests sans interface, reproductibles, qui passent en revue tous les points d’entrée de votre produit. C’est pourquoi j’ai créé agent-surface-tester.
Ce que révèlent les tests automatisés à froid sur les différentes interfaces
J’ai créé agent-surface-tester pour exécuter localement cette configuration sans interface. L’outil lance des modèles isolés via OpenRouter, sans aucun contexte de l’espace de travail, attribue à chaque exécution un seul point d’entrée (mcp, api, cli ou sdk), consigne chaque appel d’outil et sa latence au format JSON, puis demande à l’agent de relever les points de friction UX de manière structurée.
Voici à quoi ressemble une seule exécution API lorsqu’un modèle vierge se heurte à un endpoint insuffisamment documenté :
POST /v1/resources/text - Create a text resource...{ "title": "FAQ", "content": "Refunds take 5 days." }400 { "error": "expected string, received undefined" }{ "title": "FAQ", "text": "Refunds take 5 days." }201 { "id": "res_8f2a", "status": "indexing" }- 1Aucun accès au dépôt
Le modèle ne reçoit que l’URL de la documentation publique que vous lui fournissez. Il ne peut pas consulter vos types TypeScript.
- 2Deux problèmes d’UX dans un seul appel
llms.txt ne contenait aucun extrait de corps JSON, et l’erreur 400 ne précisait pas que la propriété "text" était manquante.
- 3Un diagnostic exploitable
L’ajout d’un exemple de requête en trois lignes et du chemin du champ dans les erreurs de validation a fait passer les erreurs de la visite API de 9 à 0.
Au cours de huit campagnes de test sur Lookio V2, j’ai mené 89 sessions avec sept familles de modèles (Claude, GPT, Gemini, Grok, Qwen, MiniMax et Kimi). Faire passer la même visite du produit sur les quatre portes, côte à côte, a révélé des problèmes que les tests unitaires ne détectent jamais :
- Texte vide dans add_text_resourceErreur 400 invalid_parameter correctement renvoyée sur REST API, plantage 500 internal_error sur MCPplantage 500
- Fuites de validation non interceptéesLes nombres invalides renvoyaient directement « expected number, received NaN », hors de l’enveloppe d’erreur2 points de terminaison
- Limite de 3 widgets imposée sans avertissementLa création d’un 4e widget renvoyait feature_not_available au lieu d’une erreur de limite de quantité5 exécutions sur 5
- Aide CLI de 163 KB et données d’utilisation superflueslookio help --json dépassait les limites de stdout ; get_usage renvoyait des pages de jours sans activitéde 163 KB à 45 KB
- Nouvelle exécution après la livraison des correctifsLes erreurs HTTP du parcours complet de l’API locale sont passées de 9 à 0 ; les fuites de validation brute sont passées à 00 erreur
94 exécutions d’agents sur 4 surfaces7 familles de modèles
Le problème de limite du forfait est mon exemple préféré de la franchise des agents. Notre espace de travail de test était limité à trois widgets par son forfait, mais cette information ne figurait nulle part dans les métadonnées de l’espace. Lors des tests, cinq modèles différents ont essayé de créer un quatrième widget et le serveur a répondu feature_not_available. Tous ont conclu que les widgets étaient désactivés sur le compte, plutôt que limités à trois. Un utilisateur humain qui rencontre ce message suppose que les widgets nécessitent un forfait entreprise et ne passe jamais à l’offre supérieure. Cinq agents d’affilée ont pointé directement le code d’erreur trompeur.
Coût des tests des interfaces d’agents selon les niveaux de modèles
On pense souvent que tester des agents autonomes nécessite un budget d’entreprise. Avec OpenRouter ou des passerelles compatibles, un parcours produit complet de 20 à 50 étapes coûte généralement entre une fraction de centime et quelques centimes.
Les différents niveaux de modèles remplissent des rôles distincts dans votre boucle de test :
- Les modèles rapides des offres flex (comme Gemini 3.8 Flash ou GPT-6 Luna, à moins d’un centime par parcours) sont idéaux pour les vérifications continues de régression. Ils repèrent rapidement les problèmes d’interface bruts : points de terminaison défectueux, incompatibilités de schéma et exemples manquants dans la documentation. Lorsque nous avons testé Lookio avec Gemini 3.8 Flash, il a repéré que notre point de terminaison de recherche de l’assistant renvoyait des passages pertinents sans score numérique de similarité ou de distance. L’agent ne pouvait donc pas évaluer la fiabilité de la correspondance avant de dépenser des crédits pour la génération.
- Les modèles avancés de raisonnement (comme GPT-6.1 Terra sur flex, à environ un ou deux centimes par parcours) mettent à l’épreuve les limites des règles et de la logique. Lors de nos tests, Terra a utilisé automatiquement des indicateurs éphémères
store: falseafin que les requêtes de test ne polluent pas les journaux. Il a aussi testé les nuances liées aux contacts croisés avec des allergènes, vérifié les limites des règles de commande (10 articles contre 11 pour un préavis) et envoyé des requêtes de vérification après suppression pour confirmer le nettoyage.
Comparer le même parcours complet sur toutes les surfaces, avec le même modèle et sur trois points d’accès, permet aussi de mesurer clairement la surcharge liée au protocole :
Coût d’une visite complète de Lookio par interface
Effectuer un test sur quatre points d’accès avec des modèles rapides et avancés avant une mise en production coûte moins qu’un café. Vous obtenez un audit exhaustif de toute votre interface développeur avant qu’un seul client ne s’y connecte.
Deux règles de sécurité à appliquer dans le code
Si vous lancez des agents de test autonomes contre un backend réel, deux problèmes surviennent rapidement si vous ne les empêchez pas dans le code.
Les consignes ne protègent pas les données déjà présentes. Lors de notre tout premier test sur un espace de travail partagé, le prompt système indiquait clairement : “ONLY modify or delete resources you created in this session.” Un modèle gratuit a lu cette règle, listé les widgets existants, en a sélectionné un qui nous appartenait, l’a renommé et l’a mis en pause. Les consignes dans un prompt restent de simples demandes. C’est pourquoi agent-surface-tester applique un OwnershipGuard directement dans le banc de test : il surveille les réponses de create, enregistre les identifiants créés pendant l’exécution et bloque les appels update ou delete visant tout autre identifiant avant l’envoi de la requête depuis votre machine.
Un identifiant, un agent à la fois. Quand deux agents s’exécutent simultanément dans le même espace de travail, l’un peut supprimer une ressource de test pendant que l’autre parcourt la liste par pages, ou l’un peut épuiser la limite de requêtes par clé et faire croire à l’autre que l’API est hors service. Le banc de test verrouille un fichier au niveau du système d’exploitation pour chaque empreinte d’identifiant, préfixe chaque élément de test (mcp_test_*) et supprime les préfixes résiduels avant et après chaque exécution. En local, nous préparons un espace sandbox dédié par porte afin que les suites MCP, API, CLI et SDK puissent s’exécuter en parallèle sans jamais accéder aux données des autres.
Écouter attentivement, puis filtrer sans concession
Écouter les agents ne signifie pas les laisser concevoir votre produit. Après avoir lu 89 transcriptions, j’en retiens trois filtres qui évitent beaucoup de travail inutile :
- Oubliez la note sur 10. Les modèles sont entraînés à se montrer encourageants. Beaucoup d’exécutions ont attribué une note globale de
8/10ou9/10juste après un plantage500et la découverte de trois champs non documentés. Ignorez complètement la note : examinez les appels d’outils en échec, les nouvelles tentatives et la listetop_3_fixes. - Vérifiez les affirmations à l’aide de la trace. Les modèles hallucinent aussi dans leurs analyses après coup. Une exécution a affirmé que
query_assistantne renvoyait pascredit_cost, deux minutes après qu’un autre modèle avait consigné la valeur exacte decredit_costobtenue auprès du même endpoint. Comme le harnais enregistre chaque appel d’outil brut à côté du résumé, vérifier une affirmation ne prend que cinq secondes. - Gardez les décisions d’architecture entre les mains des humains. Quatre agents CLI distincts nous ont demandé d’ajouter un indicateur bloquant
--waitaux commandes asynchrones d’ingestion de documents. L’idée semblait raisonnable, jusqu’à ce qu’on la confronte à notre propre règle de conception : chaque commande CLI Lookio correspond à une requête HTTP, sans boucle d’interrogation cachée qui immobilise un terminal pendant trois minutes.
Testez-le avec votre propre MCP
Si vous développez un serveur MCP, une API, une CLI ou un SDK, mettez en place ces deux éléments :
- Ajoutez un outil
send_feedbacken production (voici le schéma exact et le prompt que j’utilise) pour que les agents en activité vous signalent ce qui les a surpris tant qu’ils ont encore le contexte en mémoire. - Clonez agent-surface-tester, ciblez une interface à la fois avec une clé OpenRouter, puis regardez un modèle vierge essayer d’utiliser votre produit sans lire votre code.
Votre premier passage de test, qui vous coûtera cinq centimes, révélera un schéma invalide, un 400 trompeur ou un exemple manquant que vous pensiez évident. Corrigez ces problèmes, relancez le test : vous verrez la différence la prochaine fois qu’un véritable agent se connectera.