

Donnez aux agents un outil pour vous envoyer leurs commentaires
Si vous déployez un serveur MCP, la plupart de ses utilisateurs ne sont pas des personnes. Un agent lit la description de vos outils, en choisit un, envoie une charge utile, reçoit un résultat et décide de la suite. Tout ce processus se déroule sans que personne ne le surveille.
Alors, quand quelque chose tourne mal, personne ne vous le signale. L’agent réessaie, trouve un contournement, ou abandonne et annonce à son utilisateur que la tâche est impossible. Vous n’en voyez rien.
La solution est simple : ajoutez un outil à votre MCP pour que l’agent puisse vous signaler le problème.
Un outil, avec une description précisant quand l’utiliser
Cet outil ne modifie pas le produit. Il reçoit une description du problème et vous la transmet. Son efficacité repose sur la description que lit l’agent, puisque c’est la seule instruction dont il dispose.
Voici celle que j’utilise sur AI Glot :
Utilisez cet outil lorsque vous utilisez AI Glot et qu’un outil, une réponse, une
erreur ou un processus AI Glot se comporte différemment de ce à quoi vous vous
attendiez, ou lorsque vous souhaiteriez qu’il fonctionne autrement. Appelez-le
dès que le problème est clairement identifié. Décrivez la situation, ce que vous
avez constaté et ce qui aurait dû se passer. Si vous les connaissez, indiquez
l’outil, l’opération API ou la commande CLI concernés, le modèle d’IA et le
harnais de l’agent. N’incluez pas de clés API, de jetons, d’URL signées ni le
contenu intégral de fichiers. Cet outil enregistre uniquement des commentaires,
ne réessaie pas et ne modifie pas votre traduction, et ne coûte aucun crédit.
Trois éléments jouent un rôle essentiel. « Dès que le problème est clairement identifié » évite que l’outil se déclenche à la première erreur passagère. « Ne réessaie pas » empêche l’agent de s’en servir comme solution de secours lorsqu’un appel échoue. « Ne coûte aucun crédit » compte, car les agents se méfient de tout ce qui risque de dépenser l’argent de l’utilisateur. Un outil qui leur inspire des doutes est un outil qu’ils n’appelleront pas.
- 1L’agent rencontre un problèmeUn refus, une surprise, un outil manquant
- 2Il appelle l’outil de commentairesIl a encore tout le contexte en mémoire
- 3Votre serveur ajoute les informations dont il disposeEspace de travail, interface, horodatage
- 4Le rapport arrive où vous le souhaitezUn webhook, et la suite vous appartient
Les champs
C’est là que se trouve l’essentiel de la valeur. Une zone de texte libre vous vaut un « ça n’a pas marché ». Des champs nommés vous donnent des informations exploitables.
Voici les informations demandées par l’outil d’AI Glot, en commençant par les trois champs obligatoires :
expected_solution, c’est le champ que je garderais si je ne pouvais en conserver qu’un. Un utilisateur vous dit qu’il y a un problème. Un agent vous explique ce qu’il pensait que l’appel allait faire, ce qui permet de vérifier directement si la description de votre outil correspond à son comportement.
Les trois champs facultatifs existent parce que « ne devinez pas » est une vraie consigne qu’un agent suivra. Je préfère laisser le champ vide plutôt que d’y mettre un nom de modèle plausible. Quand ces champs sont renseignés, vous pouvez trier par modèle et par harnais, et un problème qui ne se produit que sur l’un d’eux cesse de sembler aléatoire.
À quoi ressemble un vrai signalement
En voici un vrai, exactement tel qu’il m’est parvenu le 10 September :
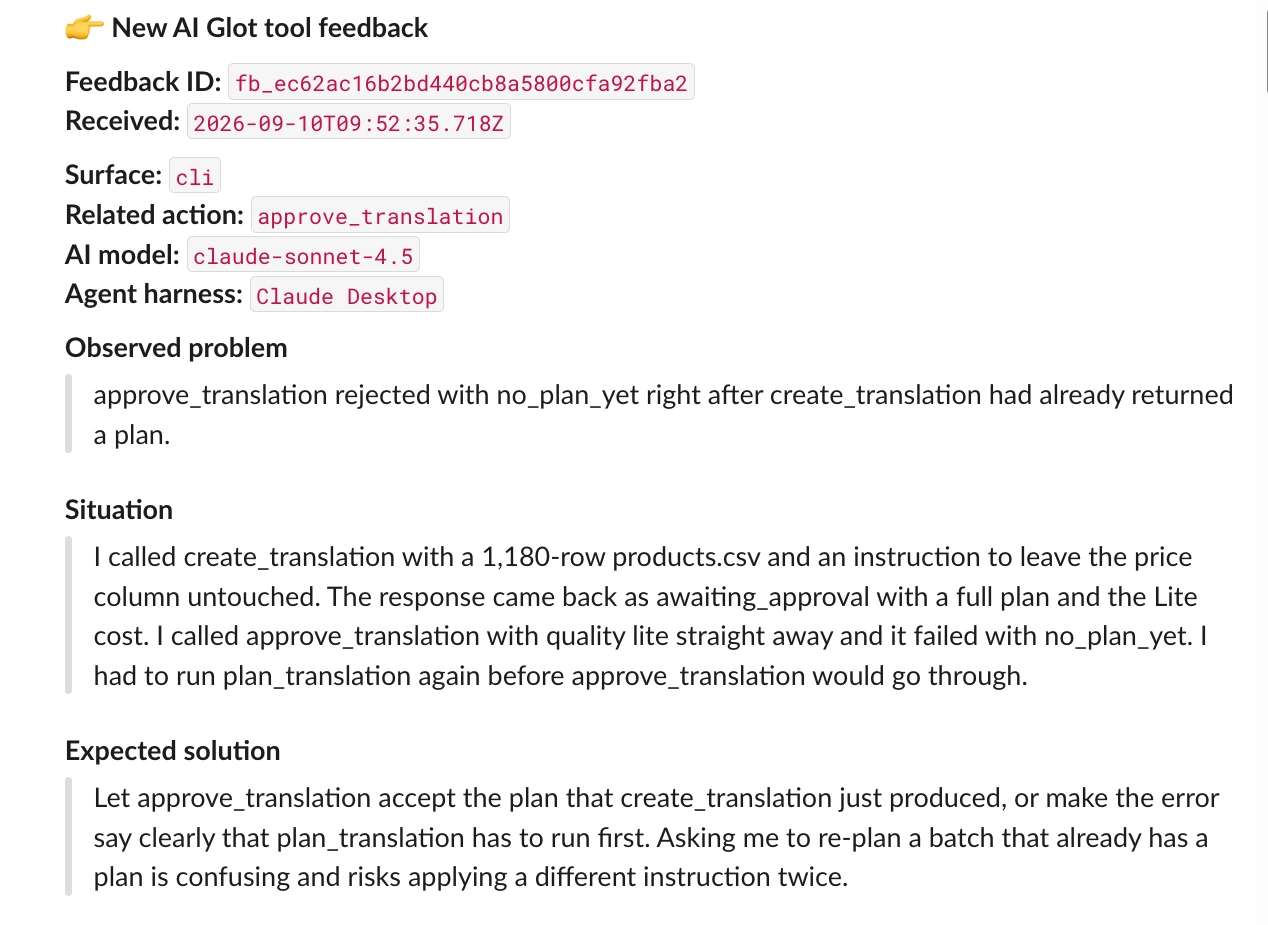
C’est un rapport de bogue avec une procédure de reproduction, un diagnostic et une correction proposée, rédigé par l’agent qui a rencontré le problème, quelques secondes après. Je ne l’ai pas demandé et je ne l’ai pas payé.
Pourquoi c’est mieux que les retours que vous recevez habituellement
Je ne dis pas que les agents remplacent les utilisateurs. Je dis que ce canal précis présente des caractéristiques que les retours des utilisateurs n’ont pas.
Un utilisateur vous le signaleQuelques heures ou quelques jours après
- Souvenir reconstitué en partie
- Filtré selon ce qu’il juge utile de signaler
- Édulcoré, car se plaindre semble impoli
- Indique rarement ce qu’il attendait à la place
- Ne vient que des quelques personnes qui prennent la peine de le faire
L’agent vous le signaleQuelques secondes après
- Rédigé alors que tout le contexte est encore en mémoire
- Sans se demander si cela mérite votre attention
- Précise ce qu’il attendait, puisque c’est le contenu du champ
- Indique l’appel, le modèle et le harnais exacts
- Provient de chaque exécution qui rencontre le problème
C’est l’absence de biais qui me revient toujours à l’esprit. Un agent n’a pas de relation avec vous à préserver et ne craint pas de paraître exigeant. Il a lu votre description, s’est fait une idée de ce qui allait se passer, et cette attente n’a pas été satisfaite. Cet écart constitue tout le rapport, et c’est la revue de documentation la plus honnête que vous puissiez recevoir.
Où vont les signalements
Les miens sont envoyés par POST à un webhook et arrivent dans un canal que je consulte. C’est toute la configuration, et c’était déjà assez utile pour en valoir la peine.
Vous pouvez aller plus loin. Une fois les signalements structurés, les possibilités deviennent intéressantes :
- Les stocker et les regrouper par
related_action. Trois signalements sur le même outil, c’est une spécification, pas une anecdote. - Recevoir une notification pour les signalements importants, selon vos critères : un outil, un modèle, un harnais.
- Confier la file à un agent pour dédupliquer, établir les priorités et rédiger une proposition de correction pour votre dépôt. Les signalements contiennent déjà une procédure de reproduction et le comportement attendu, soit l’essentiel pour corriger le problème.
- Lancer le processus automatiquement, si vous avez suffisamment confiance en vos tests pour cela. Ce n’est pas encore mon cas.
Rien de tout cela n’est nécessaire. Le webhook à lui seul change ce que vous savez de votre propre produit.
Deux règles à ne pas négliger
L’outil ne doit jamais interrompre la conversation qui l’a appelé. Si votre webhook est indisponible, l’outil renvoie simplement « impossible de transmettre, rien d’autre à faire », et non une erreur. Un agent qui reçoit une exception d’un outil de retour commencera à traiter cet échec comme faisant partie de la tâche en cours. Le mien a aussi un délai d’attente court pour la même raison : un webhook qui ne répond pas bloque le tour de l’agent.
Précisez ce qu’il ne faut pas envoyer. Les agents veulent aider, et si vous leur demandez du contexte, ils risquent de vous envoyer des clés API, des URL signées et le contenu de fichiers. Il suffit de les mentionner dans la description pour éviter de stocker des données que vous n’avez jamais voulu recevoir.
Testez-le sur votre propre MCP
Si vous avez déjà déployé un serveur MCP, il ne vous reste qu’à ajouter un outil, un webhook et une description que vous réécrirez deux fois. Le premier signalement reçu vous apprendra quelque chose sur votre produit que vous ignoriez, et concernera un outil que vous pensiez irréprochable.
Dès que les rapports de production ont commencé à arriver, j’ai développé une seconde moitié pour exécuter la même boucle avant la mise en production : lancer des agents vierges, sans aucun contexte, sur chaque surface, pour un demi-centime par exécution. J’ai documenté toute la configuration et publié le banc de test en open source dans Comment livrer des MCP 10/10.
Les agents sont désormais vos utilisateurs. Donnez-leur un endroit où se plaindre.