

Les petits modèles devraient décider de ce que voient les grands
Il est de plus en plus courant de laisser un puissant modèle d’IA orchestrer des modèles plus petits. Le grand modèle planifie le travail, puis délègue la classification, l’extraction ou les modifications prévisibles à des modèles plus rapides et moins coûteux.
C’est logique. Mais cela optimise uniquement le modèle qui exécute chaque tâche.
Je pense qu’il est possible d’obtenir un gain d’efficacité encore plus important : utiliser de petits modèles non seulement sous le grand modèle, mais aussi autour de lui.
Ils pourraient préparer son contexte avant qu’il ne raisonne, filtrer les résultats de ses outils et préserver les informations utiles au fil de la session.
Le grand modèle continuerait à prendre les décisions difficiles. Mais comme il est intelligent, lent et coûteux, chaque jeton qu’il traite doit justifier sa présence.
Préparer le contexte plutôt que l’accumuler
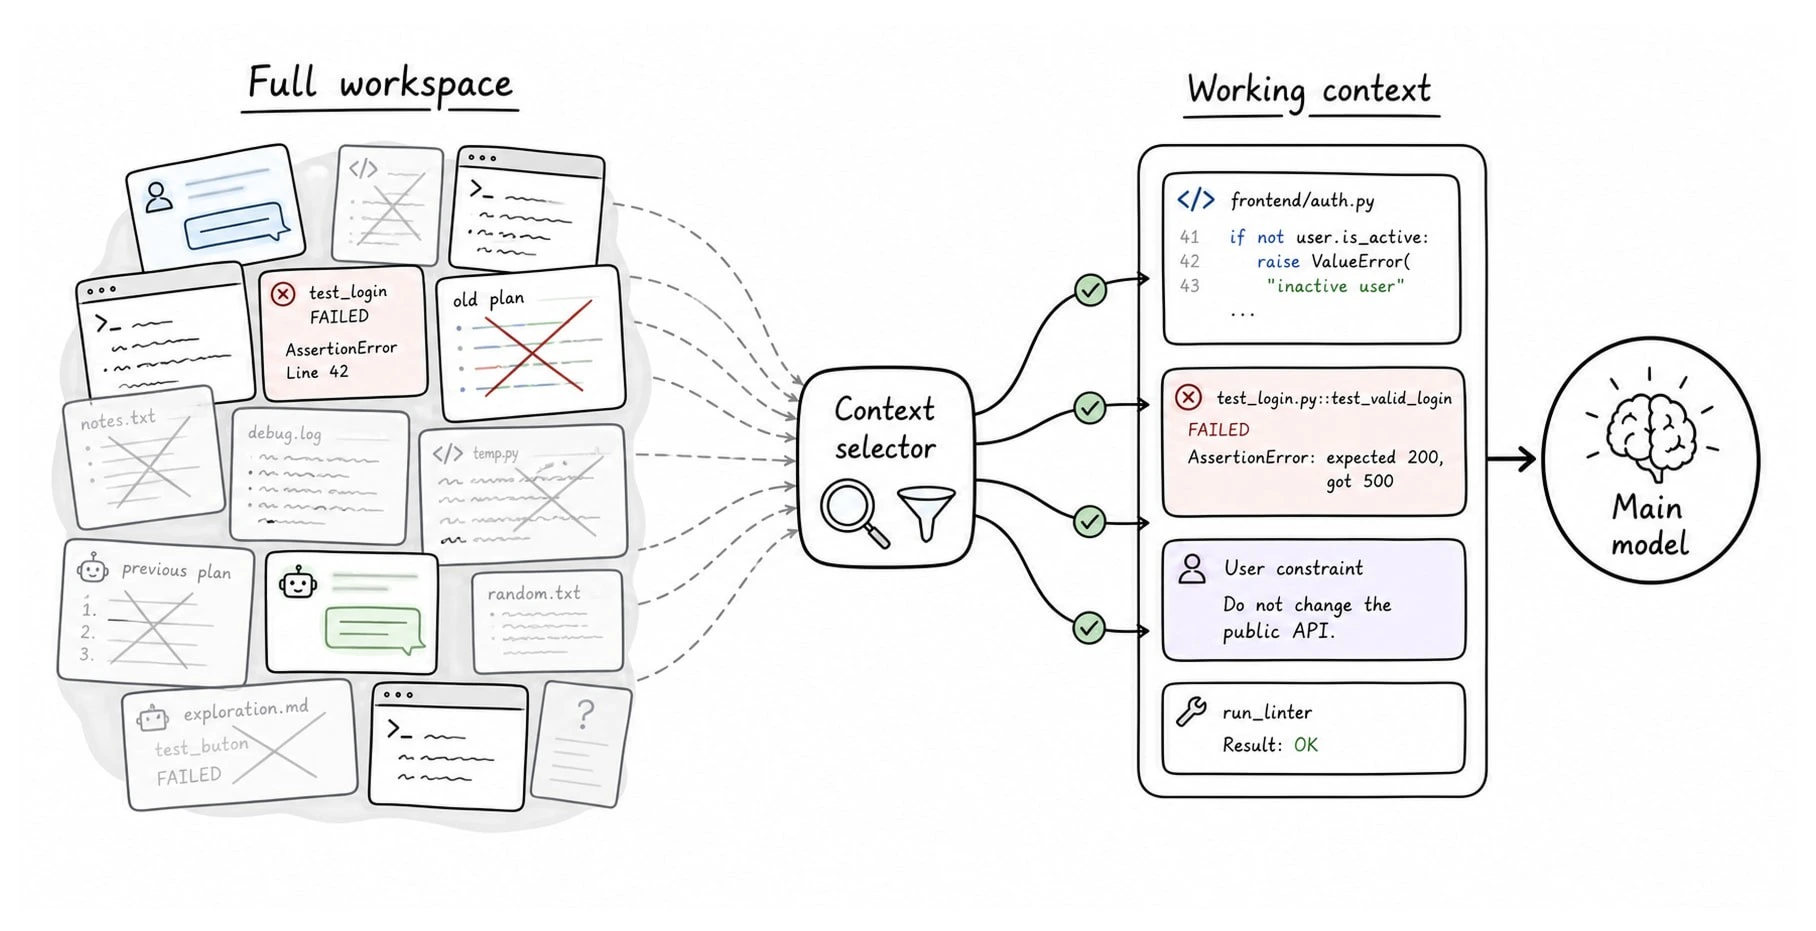
Les agents de programmation accumulent un long historique de travail : messages, plans, résultats de commandes, fichiers, erreurs et versions obsolètes d’une même information. Chaque élément a pu être utile à un moment donné. Mais peu le restent pour toutes les décisions suivantes.
Les systèmes actuels accumulent souvent ces éléments jusqu’à ce qu’ils effacent les résultats des outils, enregistrent des souvenirs ou condensent la conversation. La documentation d’Anthropic considère le contexte non pertinent comme une menace pour la concentration du modèle, et pas seulement pour la capacité de sa fenêtre de contexte.
Un petit modèle pourrait sélectionner le contexte avant chaque étape de raisonnement importante. Il pourrait produire quelque chose comme ceci :
{
  "include_messages": [2, 7, 11],
  "include_files": [
    { "path": "src/auth.ts", "lines": "48-126" },
    { "path": "tests/auth.test.ts", "match": "refresh token" }
  ],
  "include_tool_results": ["call_184"],
  "durable_notes": ["The user rejected cookie-based sessions."],
  "omit_reason": "Unrelated build logs and superseded files"
}
Le grand modèle recevrait les passages sources sélectionnés, et non un vague résumé de tout l’historique. Il s’agit de rechercher dans l’espace de travail évolutif de l’agent lui-même.
Filtrer les sorties des outils avant leur lecture par le modèle principal
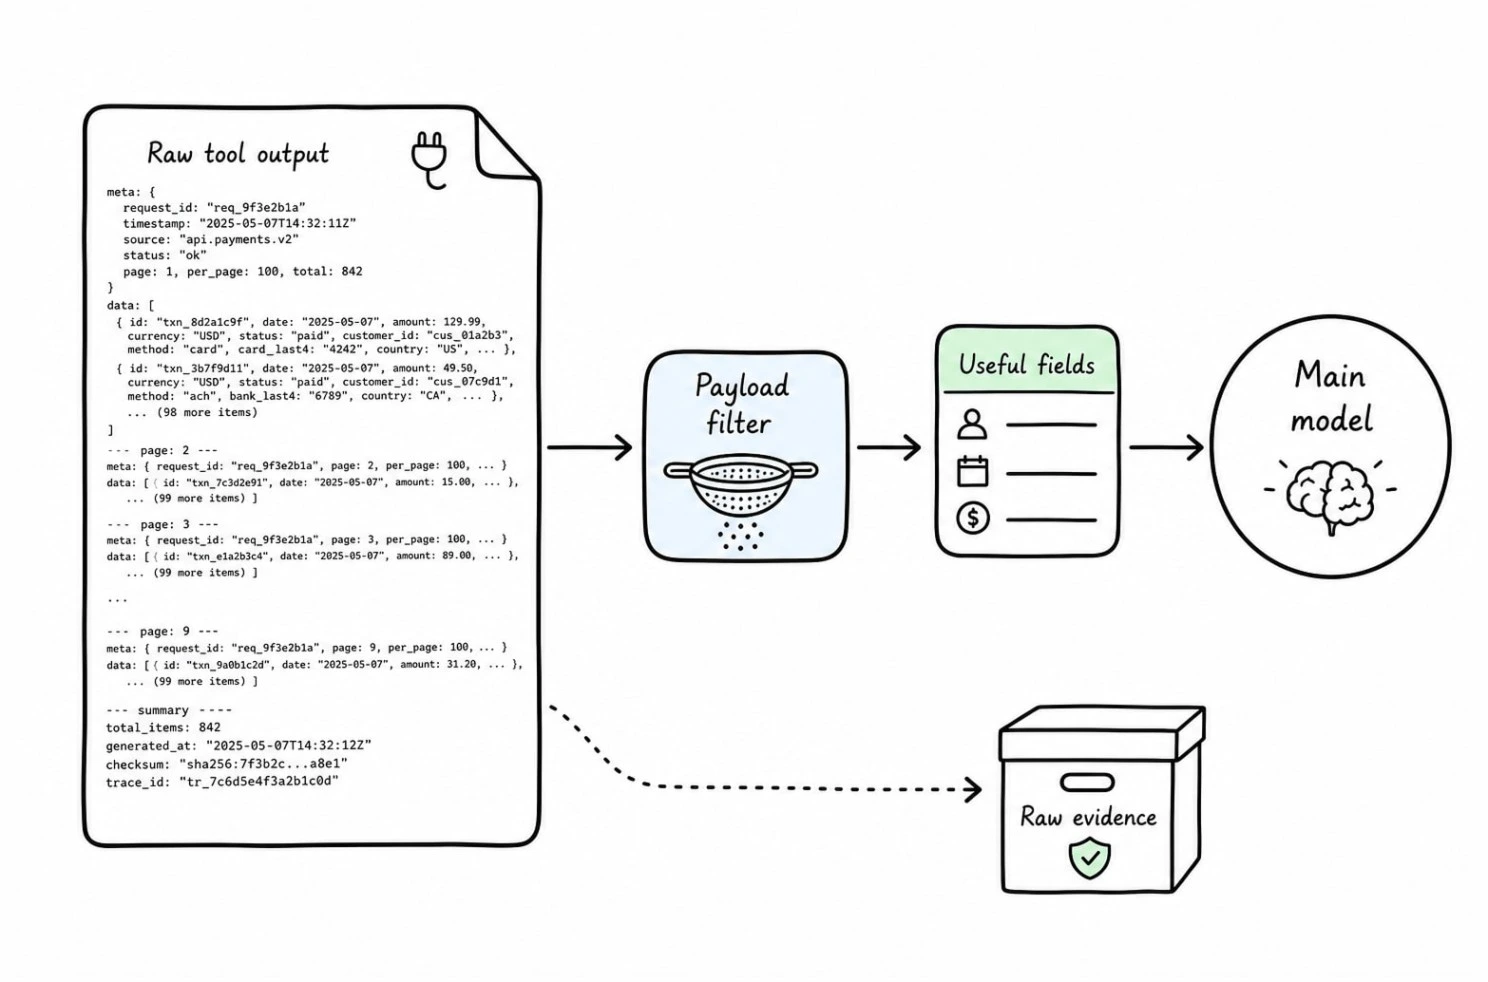
Une API ou un serveur MCP peut renvoyer des dizaines de champs alors que l’agent n’en a besoin que de trois. Les identifiants, horodatages, métadonnées de pagination et descriptions répétées restent alors dans la transcription, où ils peuvent être traités de nouveau aux tours suivants.
Un petit modèle pourrait s’intercaler entre la réponse de l’outil et le modèle principal. Il filtrerait la sortie brute en fonction de l’objectif en cours, renverrait un sous-ensemble typé et conserverait une référence vers le résultat intact. C’est particulièrement utile lorsque le développeur de l’agent ne peut pas modifier l’outil externe.
Cette même couche pourrait classer les fichiers, repérer les sections pertinentes et exclure le contenu généré avant que le grand modèle ne les lise.
Compresser l’information tant qu’elle est encore récente
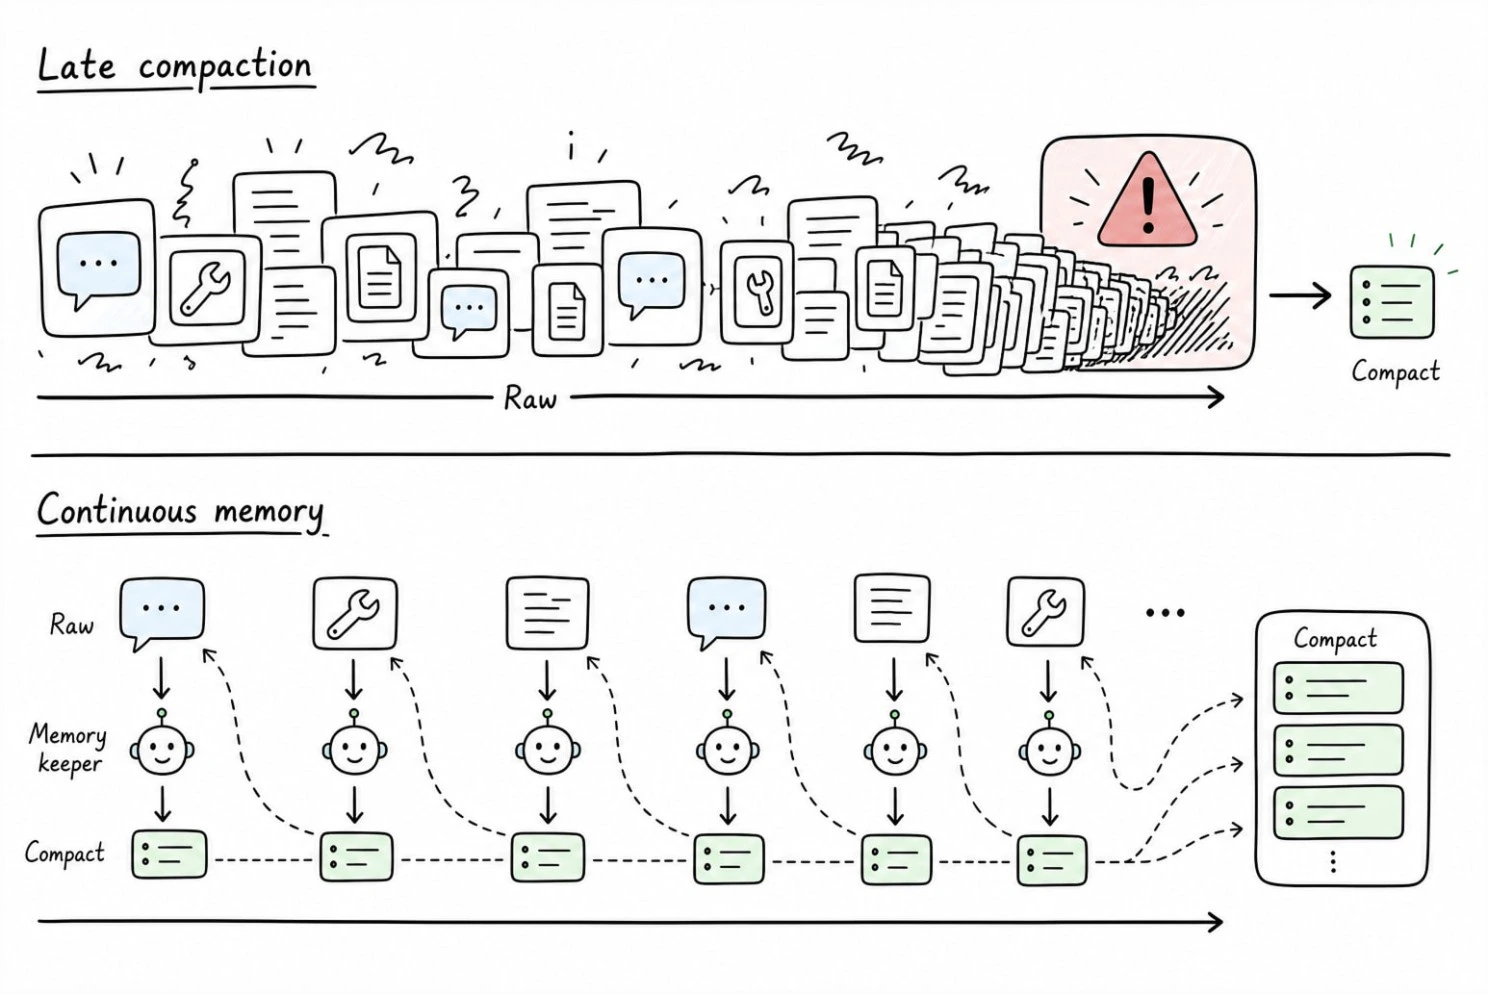
La compaction est généralement réactive : lorsque le contexte atteint un seuil, un long historique est réduit à un court résumé. À ce stade, le modèle principal a peut-être déjà relu plusieurs fois de nombreux contenus verbeux. Un résumé tardif doit aussi préserver des détails issus de plusieurs étapes, dont la pertinence future est difficile à prévoir.
L’historique d’un agent a deux types de lecteurs, aux besoins différents. Les humains ont besoin des messages complets et du langage naturel pour comprendre et auditer ce qui s’est passé. Les modèles d’IA ont besoin des mêmes faits, exprimés avec le moins de jetons possible sans perdre en fiabilité.
Un petit modèle pourrait maintenir les deux versions au fil de l’arrivée des informations : la transcription complète, lisible par les humains, et une représentation compacte lisible par machine, chargée dans le contexte actif. Chaque élément compressé renverrait à son original.
La version destinée aux machines n’aurait pas besoin d’une prose soignée. Elle pourrait s’inspirer de la récente tendance « Caveman » chez les agents de programmation : des formulations télégraphiques qui éliminent les articles, les politesses, les précautions de langage et les transitions superflues, tout en préservant les détails techniques. L’idée n’est pas de faire parler les humains ainsi, mais d’éviter de payer de gros modèles pour relire un langage conçu pour les humains.
Un journal de tests de 2,000 jetons pourrait devenir :
14 tests réussis. Échec de
refreshes expired token, carexpiresAtvalaitundefineddansauth.test.ts:88. Résultat complet : artefacttest-run-184.
Le résultat, l’échec, la valeur pertinente, l’emplacement et le chemin permettant de retrouver les éléments de preuve sont préservés. Le bruit, lui, disparaît.
Il s’agit d’un entretien continu, et non d’une compaction d’urgence.
Le modèle économique tient la route
L’inférence supplémentaire n’est intéressante que si les économies réalisées dépassent son coût en argent, en latence et en erreurs. Un modèle simple montre que le seuil de rentabilité peut être bas.
Prenons une session de programmation hypothétique de 20 étapes. Le grand modèle reçoit au total 1.45 million de jetons en entrée. Un modèle de contexte lit le même historique, génère 10,000 jetons d’instructions de sélection et réduit à 560,000 jetons les entrées du grand modèle. Dans les deux cas, le grand modèle génère 40,000 jetons en sortie.
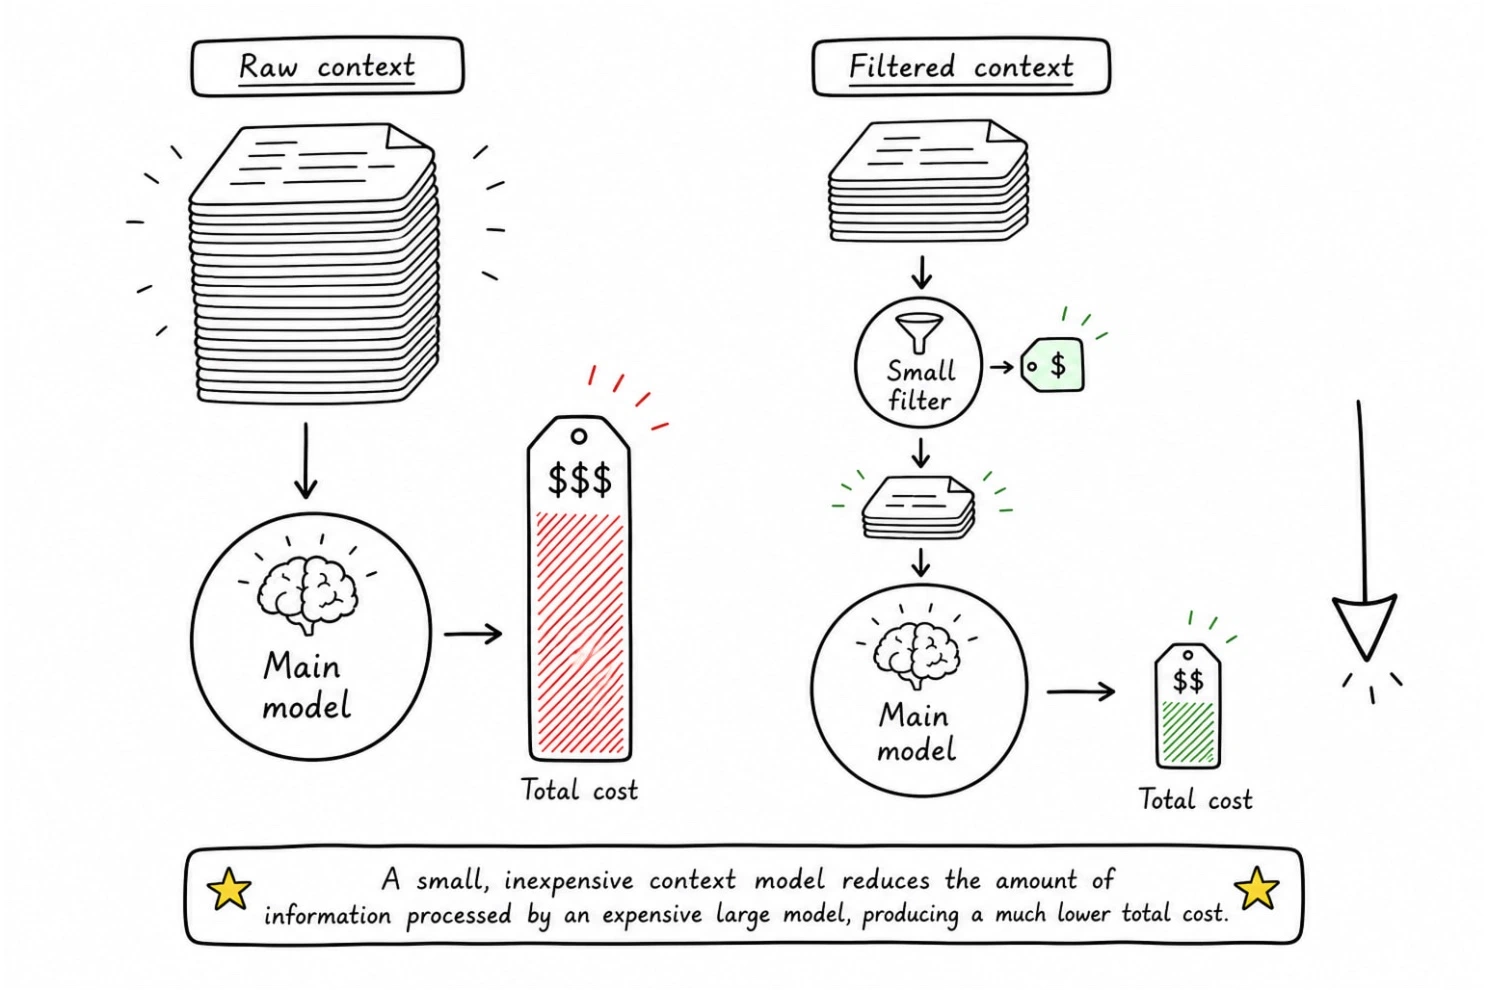
Avec les tarifs API standard publiés le 4 July 2026, l’association de Gemini 3.1 Flash-Lite ($0.25 en entrée et $1.50 en sortie par million de jetons) et de Claude Fable 5 ($10 en entrée et $50 en sortie) donne :
| Sans filtrage | Avec filtrage | |
|---|---|---|
| Entrée du grand modèle | 1.45M jetons | 0.56M jetons |
| Coût du grand modèle | $16.50 | $7.60 |
| Coût du modèle de contexte | aucun | $0.38 |
| Total | $16.50 | $7.98 |
Coût total d’une session de 20 étapes
Le filtrage devient rentable après avoir éliminé 37,750 jetons d’entrée de Fable, soit 2.6% des données brutes en entrée.
Le filtrage peut échouer
Supprimer du contexte peut aussi éliminer l’indice qui permet de résoudre la tâche. Un petit modèle risque d’écarter une ligne de journal inhabituelle, de déformer une contrainte de l’utilisateur ou d’omettre un identifiant nécessaire au prochain appel d’outil.
L’architecture doit donc respecter quelques règles strictes :
- garder les entrées brutes accessibles ;
- structurer les décisions de filtrage pour qu’elles puissent être auditées ;
- ne jamais compresser les consignes de l’utilisateur ni les contraintes de sécurité ;
- inclure les informations incertaines ;
- permettre au modèle principal de demander les éléments d’origine ;
- mesurer la réussite des tâches, et pas seulement les économies de jetons.
Les petits modèles doivent gérer l’accès aux éléments probants, pas devenir une source de vérité invisible.
L’expérience compte plus que l’estimation
Il faut comparer cette idée à trois solutions : le contexte brut accumulé, la compaction par seuil et le filtrage sémantique continu.
Chaque système doit exécuter les mêmes tâches de programmation. L’évaluation doit mesurer le coût total en jetons, la latence, l’utilisation du cache et la réussite des tâches. Elle doit aussi consigner chaque cas où le filtrage supprime un élément dont le modèle principal a ensuite besoin.
- 1Un ensemble de tâchesLes mêmes tâches de programmation pour chacun
- 2Trois systèmesContexte brut, compaction par seuil, filtrage continu
- 3Quatre mesuresCoût, latence, accès au cache, réussite
- 4Un verdictUne baisse des coûts ne compte que si le système fonctionne toujours
L’architecture ne l’emporte que si elle réduit les coûts sans dégrader la qualité d’exécution. Tant qu’un tel test n’a pas été mené, les gains économiques justifient une expérimentation, mais ne prouvent pas que le système fonctionne.
Un nouveau rôle pour les petits modèles
Le routage des modèles pose la question : quel modèle doit effectuer cette tâche ?
Cette architecture pose une autre question : que mérite l’attention du meilleur modèle ?
Routage des modèlesQui fait le travail
- Lit la tâche et choisit un modèle
- Le modèle économique s’occupe des tâches faciles
- Le contexte correspond à tout ce qui s’est accumulé
Des petits modèles autour du grandSur quoi porte le travail
- Le meilleur modèle garde les décisions difficiles
- Les petits modèles choisissent ce qu’il lit
- Le contexte est sélectionné avant chaque étape
Les petits modèles pourraient devenir des documentalistes du contexte, des éditeurs de données transmises et des gestionnaires de mémoire. Ils prépareraient l’espace de travail avant que le modèle principal ne raisonne, puis préserveraient les résultats utiles après son intervention.
Cette idée est particulièrement pertinente pour les agents de programmation, qui génèrent beaucoup de contenu intermédiaire. Elle s’applique aussi à la recherche, à l’assistance et à d’autres flux de travail de longue durée combinant conversations, outils et données externes.
Le modèle le plus performant ne devrait pas lire chaque ligne simplement parce que le système peut la lui transmettre.
Chaque jeton doit avoir une raison d’être.
Sources
- Anthropic : édition du contexte
- Anthropic : ingénierie du contexte avec mémoire, compression et suppression des outils
- Caveman : communication économe en jetons pour les agents de programmation
- Google : Gemini 3.1 Flash-Lite
- Anthropic : tarifs de l’API Claude
- Model Context Protocol : spécification des outils