

Consejos concretos para pasar de un RAG simple a uno mejor
queries: ["how do cells take in water"]
- Cell membrane transport0.71
- Osmosis and diffusion0.58
- Mitosis, phase timing0.19
- Photosynthesis, light cycle0.11
dropped below 0.4
Two chunks reach the agent. The other two never existed as far as it knows.
Casi todos los tutoriales de RAG en n8n terminan en el mismo lienzo: un agente de IA y, conectado a él, un nodo de vector store usado directamente como herramienta. He montado esa configuración muchas veces. Funciona, y durante un tiempo no profundicé más.
Luego empecé a hacerle preguntas más difíciles y surgieron tres problemas que tienen la misma causa: el agente es el dueño de la recuperación, y tú no controlas nada.
Esta es la versión escrita de un vídeo, con el mismo curso de biología y las mismas cifras.
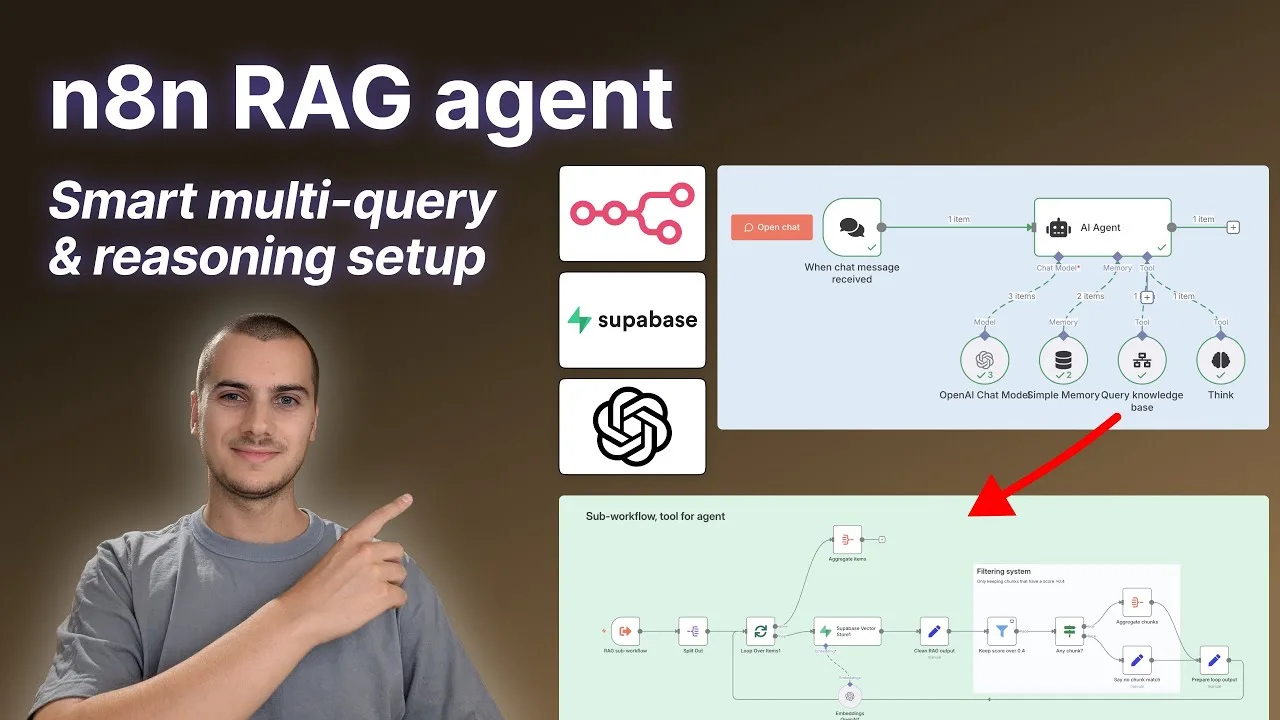
El lienzo por el que todos empiezan
Mi base de conocimientos para esto es un curso de biología, vectorizado en Supabase. Si le preguntas “qué es una célula”, responde bien. Esa es la demo que todo el mundo muestra, y no es mentira: las preguntas sencillas funcionan.
Agente de IA
- Cuando se recibe mensaje de chat
- Agente de IAModelo de ChatModelo de chat de OpenAIMemoriaMemoria simpleHerramientaVector Store de SupabaseEl agente escribe la consulta, se devuelven cuatro fragmentos
Esto es lo que controlas en esa configuración: una descripción de la herramienta que indica al agente cuándo usarla. Esa es toda la superficie de control.
Lo que definesUna sola vez, al compilar
- Una descripción de la herramienta
- Cuántos fragmentos devolver
Lo que decide el agenteEn cada llamada
- El texto exacto de la consulta enviada al almacén de vectores
- Que haya una sola consulta, nunca dos
- Nada sobre qué tan cercano debe estar un fragmento
Nunca ves la consulta
El agente redacta la consulta y la envía. Puedes intentar guiarlo con la descripción de la herramienta y esperar que funcione. Si se trata de una pregunta que requería reformularse, o donde el fraseo del usuario no se parece en nada al de tus documentos, te enterarás revisando el registro de ejecución después.
Una consulta por llamada
Una pregunta real a menudo no es una sola pregunta. Si pides algo que requiere definir un término y luego relacionar ese término con otro, una única búsqueda de similitud debe cubrir ambos a la vez. El resultado son fragmentos mediocres para ambos casos en lugar de buenos para cualquiera de los dos.
El agente puede llamar a la herramienta dos veces, pero eso implica dos turnos completos del modelo y, por lo general, no se molesta en hacerlo.
Devuelve cuatro fragmentos sin importar lo que pidas
Esto fue lo que me hizo cambiar la configuración. El almacén de vectores devuelve los cuatro fragmentos más cercanos. Los más cercanos, no necesariamente cercanos.
Pregunta a mi curso de biología a qué hora cenamos hoy y seguirás recibiendo cuatro fragmentos. Están lejos, pero son los cuatro menos lejanos, así que aparecen. El agente los recibe sin indicación alguna de que son basura, y como los modelos son complacientes, los trata como material relevante.
Consulta: “cuándo cenamos hoy”
Las puntuaciones existen dentro del almacén de vectores. La herramienta no te las entrega.
Sustituye la herramienta por un subflujo de trabajo
La solución es dejar de darle al agente el almacén de vectores y darle, en su lugar, un subflujo de trabajo. En n8n, esa es la herramienta Call n8n Workflow: el agente la llama, se ejecuta un flujo de trabajo en su propio lienzo y el agente recibe lo que el último nodo devuelva.
La parte del agente apenas cambia. El mismo activador, el mismo agente y el almacén de vectores sustituido por dos herramientas.
Agente de IA
- Cuando se recibe mensaje de chat
- Agente de IAgpt-5-miniModelo de chatOpenAI Chat Modelgpt-5-miniMemoriaMemoria simpleLos últimos 8 turnosHerramientaConsultar base de conocimientosEl subflujo. Acepta una matriz de 1 a 5 consultasHerramientaPensarUsado justo después de la recuperación, máx. 50 palabras
El subflujo de trabajo es donde reside toda la nueva superficie de control. Cada recuadro a continuación es un paso que has escrito y que puedes abrir en el registro de ejecución posteriormente.
Subflujo de trabajo, herramienta para el agente
- Subflujo RAGActivador. Entrada: consultas, una matriz
- Split OutUn elemento por consulta
- Bucle sobre elementosTodo lo siguiente se ejecuta una vez por consulta
- Supabase Vector StoreComo nodo, no como herramienta. Mapeas la consulta y cada fragmento vuelve con su puntuaciónEmbeddingEmbeddings OpenAI
- Limpiar salida RAGMantiene el texto del fragmento, el nombre del capítulo y la puntuación redondeada a dos decimales
- Mantener puntuación > 0,4Filtro. Siempre devuelve datos, por lo que una consulta sin coincidencia sigue adelante
- ¿Algún fragmento?IF, sobre si algo sobrevivió
true, algo pasó
- Agregar fragmentos
false, nada pasó
- Indicar que no hay coincidencia"Ningún fragmento alcanzó el umbral de relevancia, la base de conocimientos no pudo proporcionar información"
- Preparar salida del bucleLa consulta emparejada con lo que devolvió
↩ Preparar salida del bucle vuelve a Bucle sobre elementos. Cuando cada consulta se haya ejecutado, la salida final del bucle va a un nodo de Agregación y el agente recibe un único campo: Recuperación de la base de conocimientos.
Una matriz de consultas en una sola llamada a la herramienta
El activador del subflujo acepta un campo llamado queries. La descripción de la herramienta indica al agente que es una matriz de una a cinco, y el prompt del sistema dice lo mismo en la otra dirección: cuanto más compleja sea la pregunta del usuario, más debes dividirla en subconsultas, hasta un máximo de cinco.
Esa es la parte de la multiconsulta, y cuesta una sola llamada a la herramienta en lugar de tres.
- El usuario hace una pregunta complejaDos términos y cómo interactúan
- El agente escribe tres consultasDefinir la primera, definir la segunda y cómo se relacionan1 llamada a herramienta
- El subflujo ejecuta las tresUn bucle y una puntuación para cada resultado
- Se devuelve un elemento agregadoAgrupado por consulta
La puntuación es la clave
Dentro del subflujo, Supabase es un nodo normal, por lo que yo mismo mapeo la consulta y la respuesta incluye una puntuación de similitud. El filtro descarta cualquier cosa que esté en 0.4 o por debajo.
Dos detalles que me costaron tiempo. El filtro debe configurarse para emitir siempre datos; de lo contrario, una consulta en la que nada superó el filtro no produce ningún elemento y la rama siguiente nunca se ejecuta. Y el IF posterior comprueba si sobrevivió algún fragmento, ya que es el caso que quieres gestionar explícitamente en lugar de devolver silencio: el agente recibe una frase indicando que la base de conocimientos no tenía nada útil para esa consulta.
Indica al agente de dónde proviene el fragmento
El paso de limpieza es más importante de lo que parece. Supabase devuelve metadatos que no me sirven, como el tipo de contenido del archivo original, y eso supone tokens en cada fragmento de cada consulta.
Lo que conservo es el texto del fragmento más dos campos: el capítulo del que proviene y su puntuación de relevancia redondeada a dos decimales. Ambos pasan al agente. El nombre del capítulo le permite indicar de dónde proviene la información, y pasar la puntuación permite que el agente vea que una de sus cinco consultas alcanzó el 0.42 mientras que otra llegó al 0.81, y pueda ponderarlas en consecuencia.
Nombra lo que devuelves
El agregado final no produce un bloque anónimo. Produce un campo llamado Knowledge base retrieval y, dentro de él, cada entrada empareja Query to the knowledge base con Chunks returned.
Ese emparejamiento es fundamental. El agente envió tres consultas, recibe tres grupos etiquetados y puede saber qué fragmentos responden a qué parte de su propia pregunta. Si le entregas un array plano de doce fragmentos, tendrá que inferir el mapeo, algo que hará mal en algunas ocasiones.
Nombrar los campos requiere un nodo Set. Es lo más barato de esta lista y lo que más tiempo tardé en implementar.
Un paso de reflexión antes de la respuesta
El otro cambio es en el propio agente. Le he dado una herramienta de reflexión y el prompt del sistema le indica que la use justo después de recibir la recuperación: analizar la pregunta frente a lo obtenido y cuestionar si realmente tiene lo necesario para responder.
La descripción de la herramienta lo limita a 50 palabras. Sin esto, escribe párrafos enteros, y reflexionar en voz alta sobre cuatro fragmentos no merece gastar una página de tokens.
Puedes leer esas notas en el registro de ejecución, que es la parte que no esperaba que me gustara tanto. Cuando una respuesta es incorrecta, las notas suelen indicarte si el fallo estuvo en la recuperación o en el razonamiento.
Las últimas líneas del prompt del sistema son las que conservaría si solo pudiera mantener dos. Responder únicamente basándose en el contenido del curso y, si una pregunta queda fuera de este, redirigir en lugar de responder. Y si no tienes lo necesario, dilo en lugar de responder usando conocimientos generales.
Ambas instrucciones solo funcionan porque la recuperación inferior es honesta cuando vuelve vacía. Una instrucción para admitir ignorancia no sirve de nada cuando cada consulta devuelve cuatro fragmentos que parecen evidencias.
Lo que esto enseña realmente
Cada corrección aquí es la misma corrección. Algo se decidía por mí, así que lo moví a un paso que yo controlo.
Eso vale más que el flujo de trabajo. Ahora, cuando trabajo en Claude Code, las preguntas que hago son las que esta configuración me obligó a plantear: qué se buscó exactamente, cuánto se recuperó, cuánto valía la pena leer, qué hay en la ventana de contexto que nadie necesitaba. Un agente genérico oculta todo esto por defecto y leerá encantado veinte archivos para responder algo que solo requería dos.
Construir la recuperación a mano una vez es la forma de aprender a fijarse en los detalles.