

Votre chatbot n'a pas besoin d'un nouveau titre après chaque message
Si vous créez une fonctionnalité de chat AI, vous voudrez afficher un titre pour chaque conversation dans une barre latérale. Par exemple, “Demande pour pare-brise cassé” au lieu de “Nouvelle discussion”.
Il existe deux manières simples de le faire, et toutes deux sont imparfaites.
La première consiste à générer le titre une seule fois, à partir du premier message. C’est économique, mais le premier message est souvent le moins utile. Dans l’app Claude, par exemple, le titre est fixé au début et ne change plus. Si vous commencez par “salut, j’ai une question”, votre conversation pourra s’appeler “Salutations” indéfiniment, même après 30 messages sur un sujet totalement différent.
La seconde consiste à réécrire le titre après chaque message. Le titre reste précis, mais vous payez un appel au modèle à chaque tour pour une fonction quasi cosmétique. De plus, le sujet d’une conversation ne change pas à chaque message.
La règle
Je ne régénère le titre qu’aux messages 1, 2, 3 et 5, puis à chaque multiple de 5.
C’est lors des premiers messages que le sujet devient clair, le titre est donc réécrit souvent au début. Ensuite, une mise à jour tous les 5 messages suffit pour suivre une conversation qui aurait dérivé.
Dans n8n, il s’agit d’un seul nœud If placé devant le générateur de titres (voir la capture du workflow ci-dessous). Voici la condition :
[1, 2, 3, 5].includes(messages.length)
  || (messages.length > 5 && messages.length % 5 === 0)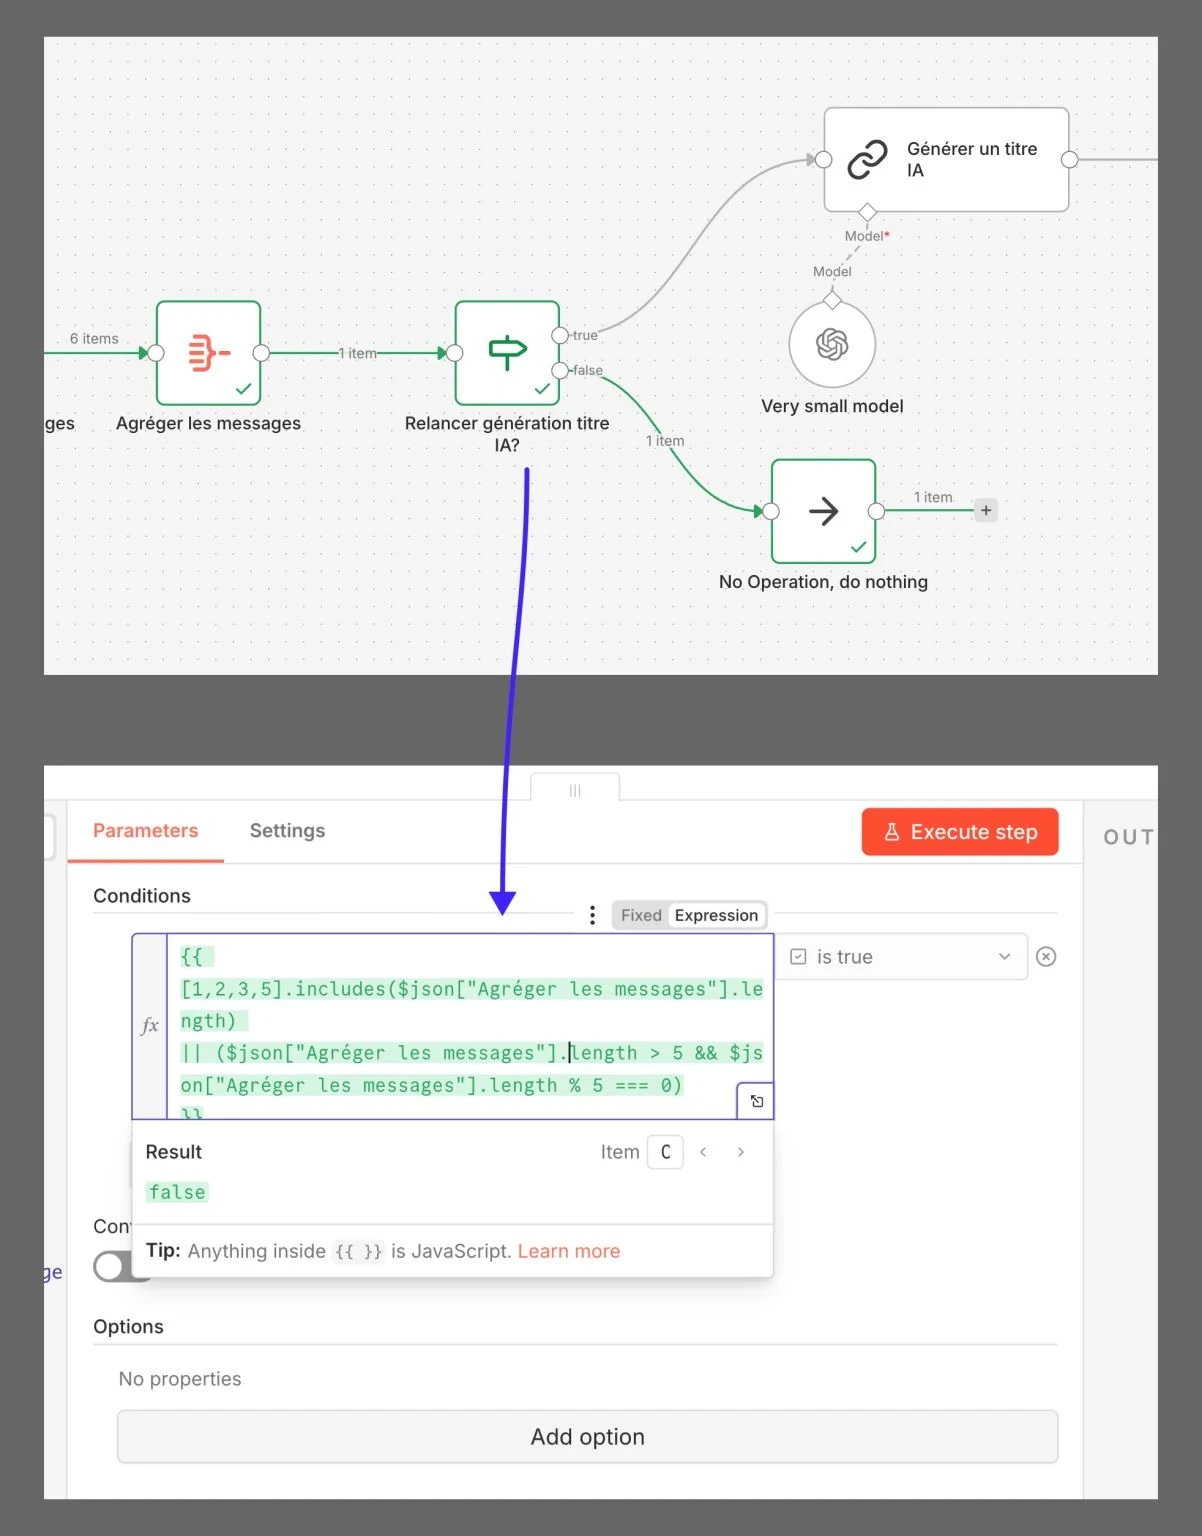
J’ai demandé à une AI d’écrire cette expression une fois, et elle fonctionne parfaitement depuis.
Pour une conversation de 20 messages, cela représente 7 générations au lieu de 20. À 40 messages, 11 au lieu de 40. À 60, 15 au lieu de 60. On réduit donc les appels de 75%, et l’économie augmente avec la longueur de la conversation.
N’envoyez pas toute la conversation
Le nombre d’appels représente la moitié du coût. L’autre moitié dépend de ce que chaque appel doit lire.
Si vous envoyez chaque message au modèle de titre, chaque appel devient plus coûteux à mesure que la conversation s’allonge. À la place, j’envoie les 5 derniers messages plus le titre actuel. C’est largement suffisant pour générer un titre de 8 mots, et le titre actuel conserve le contexte des messages précédents.
Voici ce que le modèle de titre lit sur une conversation de 40 messages, compté en nombre de messages et en supposant qu’ils aient tous la même longueur :
Messages lus par le modèle de titre sur une conversation de 40 messages
Utilisez le modèle le plus léger possible
Rédiger un titre est une tâche simple, et ce n’est pas le cœur du produit. Cela ne nécessite pas un modèle imposant. Dans ce flux de travail, c’est Ministral 14B qui s’en charge, avec un petit modèle GPT en secours. Les deux répondent rapidement et coûtent très peu.
Le prompt consiste principalement en des règles de sortie: 6 à 8 mots, casse de phrase, pas de guillemets, pas de “Voici un titre”, et une ligne indiquant que le titre actuel peut être conservé ou amélioré si les derniers messages n’ont pas changé le sujet.
C’est une fonctionnalité mineure. Mais elle s’exécute pour chaque conversation de chaque utilisateur, et de petites économies comme celle-ci s’accumulent à l’échelle d’un produit.
Mise à jour, septembre 2026: laisser un modèle de décision trancher
La règle ci-dessus régénère le titre selon un calendrier, que le sujet ait changé ou non. Si quelqu’un parle de la même chose pendant 40 messages, 10 des 11 régénérations ont été inutiles.
Depuis septembre, il existe un moyen moins coûteux de décider. Jev est un modèle de décision: il n’écrit aucun texte, il renvoie une probabilité basée sur des réponses que vous définissez, et il coûte 0,042 $ par million de tokens d’entrée. Je l’ai utilisé pour choisir ce qu’un agent lit avant de commencer, et la vérification d’un titre est le même type de question.
- 1Tous les 5 messagesOu tout autre calendrier choisi
- 2Demander à JevTitre actuel + derniers messages
- 3Obsolète au-dessus de 70 % ?Sinon, on s’arrête ici
- 4Réécrire le titreLe petit modèle, comme auparavant
Vous choisissez toujours le contexte transmis à Jev, de la même manière que pour le modèle de titre: le titre actuel et les derniers messages sont généralement suffisants.
Il existe également une méthode qui ne coûte absolument rien:
AutomatiqueRègle, ou règle + Jev
- Fonctionne sans action de l'utilisateur
- Coûte un petit appel périodique
- Peut manquer un changement entre deux vérifications
Bouton de régénérationUn clic, à côté du titre
- S'exécute uniquement sur demande
- L'utilisateur sait mieux quand le titre est erroné
- Nécessite un bouton supplémentaire dans l'interface
D’après ce que je vois, aucune des grandes applications d’IA ne procède ainsi aujourd’hui. Si vous créez votre propre produit d’IA, un SaaS ou un outil interne, il est utile de connaître les options et de choisir celle qui correspond à vos coûts et à vos utilisateurs.