

Dejar que un agente anote mis capturas de pantalla para la documentación
- La pregunta
- ¿Puedo entregar a un agente una carpeta de capturas sin nombre, que deduzca qué muestran y obtener las figuras anotadas que necesita una página de documentación?
- El resultado
- Sí en cuanto a leerlas y dibujar sobre ellas. La ubicación del pie de foto sigue siendo una cuestión de criterio, y depende de si la interfaz tiene espacio en blanco.
Lo que quería averiguar
Cuando escribo documentación, voy haciendo capturas de pantalla sobre la marcha y estas acaban en mi escritorio con nombres como Screenshot 2026-09-14 at 18.03.12.png. Entonces empieza la parte lenta: abrir cada una, deducir a qué paso pertenece, recortarla, dibujar un cuadro alrededor del botón y escribir el pie de foto en un lugar donde no tape el elemento al que hace referencia.
La pregunta era si podía saltarme todo eso. Entregar la carpeta al agente, dejar que analice las imágenes para entender de qué está escribiendo, que ayude con el texto y que luego genere las figuras marcadas. Sin Figma, sin ir y volver sobre dónde colocar un cuadro.
La parte que esperaba que fuera difícil era el dibujo. Resultó que no lo fue.
Cómo se probó
Una anotación es un módulo de JavaScript, no un dibujo. Define una imagen de origen y una lista de formas en porcentajes del marco, y un renderizador las superpone a la captura en Chrome y vuelve a fotografiar la página con Playwright.
Chrome es el truco maestro. Las esquinas redondeadas, las sombras, el renderizado de texto y el desenfoque son del navegador, por lo que no hay que reimplementar nada, y el resultado es un PNG con las dimensiones exactas del original.
- 1Subir la capturaSea cual sea el nombre que le haya dado la herramienta
- 2Renderizar la cuadrículaUna superposición de porcentajes sobre la imagen
- 3Leer las coordenadasMirar una vez, anotarlas
- 4Escribir la especificaciónUn archivo JS: cuadros, flechas, notas, recortes
- 5RenderizarChrome compone, Playwright dispara
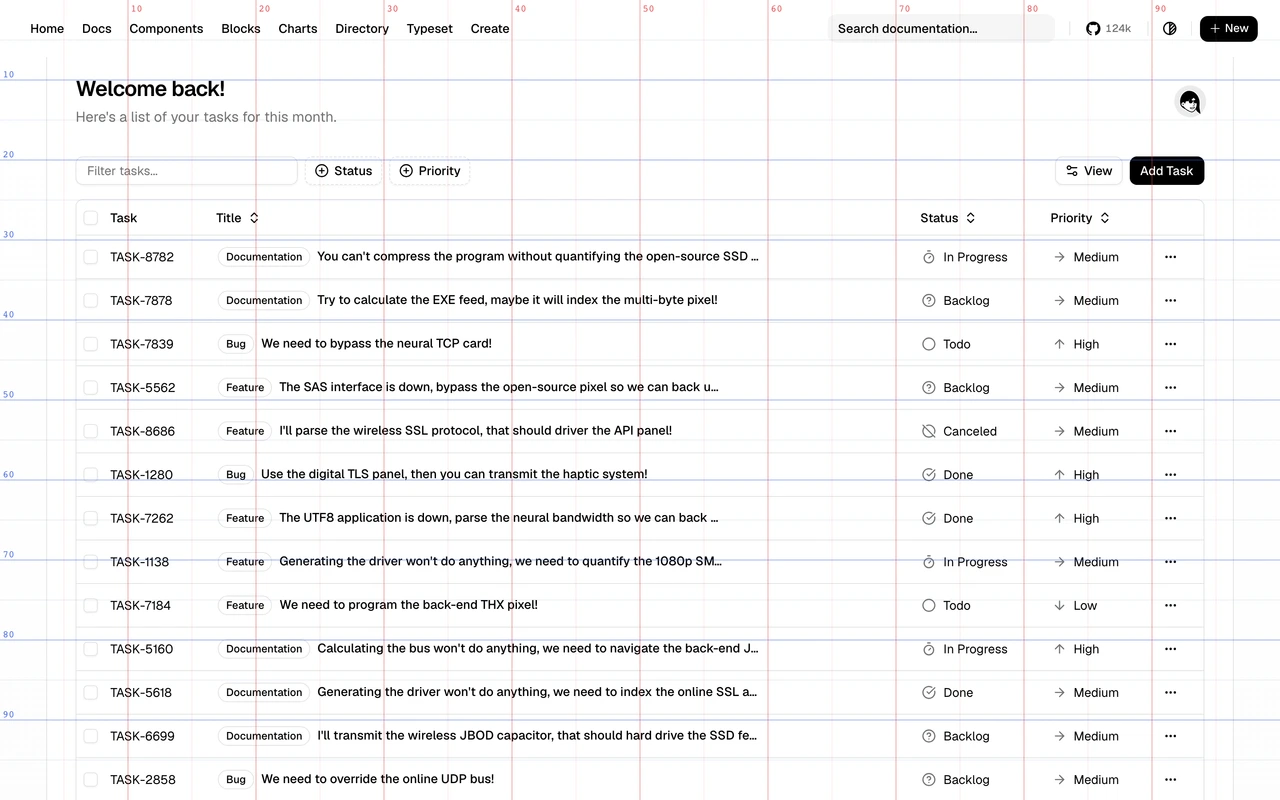
El paso tres fue donde el experimento casi falla. Al pedirle que colocara un cuadro alrededor de un botón a ojo, el agente fallaba por un 2%, que parece poco sobre el papel pero es obvio en la imagen. La solución es dejar de pedirle que estime: primero se renderiza una cuadrícula de porcentajes sobre la captura, el agente lee los números de esa cuadrícula una sola vez y, a partir de ahí, cada cuadro cae exactamente en el píxel.
Seis primitivas cubren lo que necesita una figura de documentación.
| Primitiva | Función |
|---|---|
box | El marco redondeado y su halo, con número y pie de foto opcionales |
arrow | Una flecha curva, orientada al punto, para un simple “haz clic aquí” |
note | Una tarjeta de texto: un título y una línea de cuerpo |
spotlight | Oscurece todo excepto los huecos recortados |
zoom | Una lupa: un recorte ampliado, colocado donde haya espacio |
redact | Desenfoca una región |
El resultado
La lectura de capturas funciona. Dada la carpeta sin nombres de archivo útiles, el agente identificó qué producto mostraba cada captura, qué pantalla y cuál ilustraba cada paso, lo suficiente como para redactar el texto a su alrededor.
El dibujo también funciona y es rápido: como la especificación es código, una captura repetida tras un cambio en la interfaz se reanota ejecutando un comando, siempre que nada se haya movido más de un 1% aproximadamente.
La parte que no se reduce a un comando es dónde colocar el pie de foto, y eso lo decide la captura y no la herramienta.
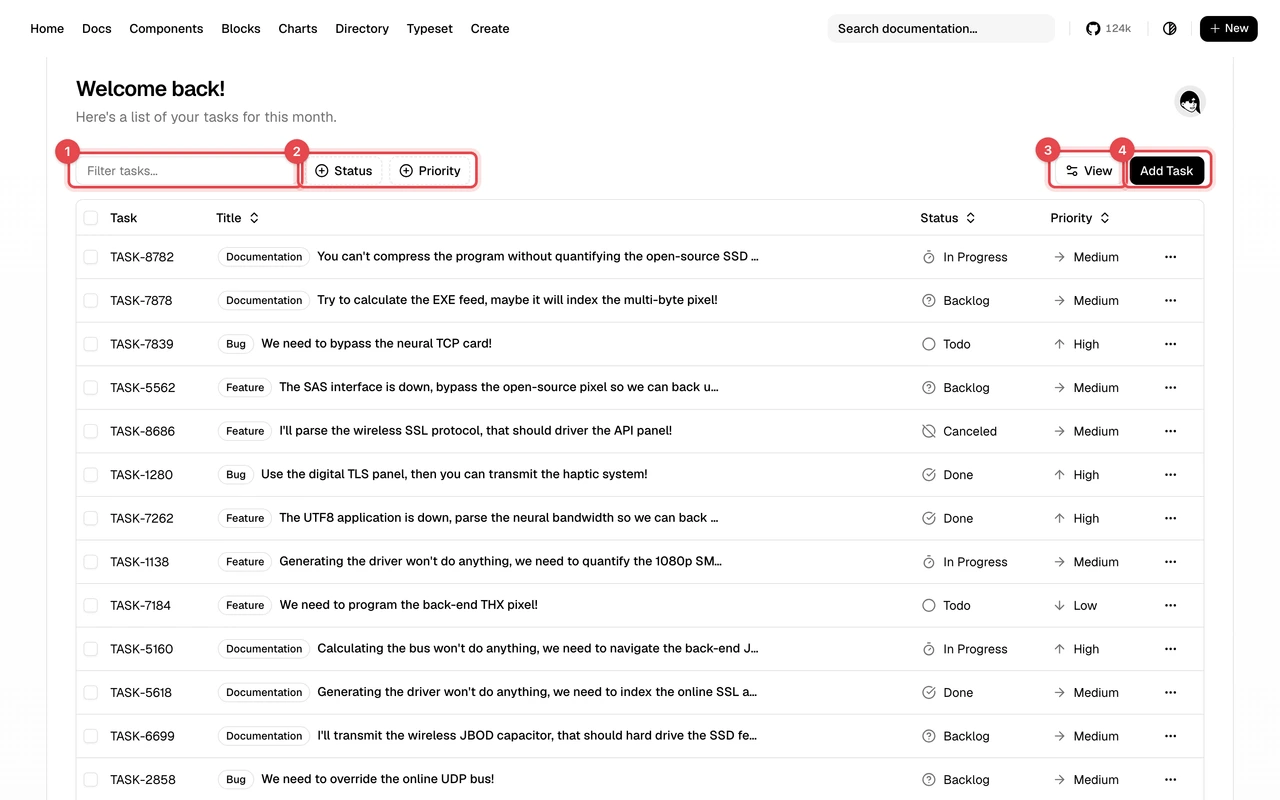
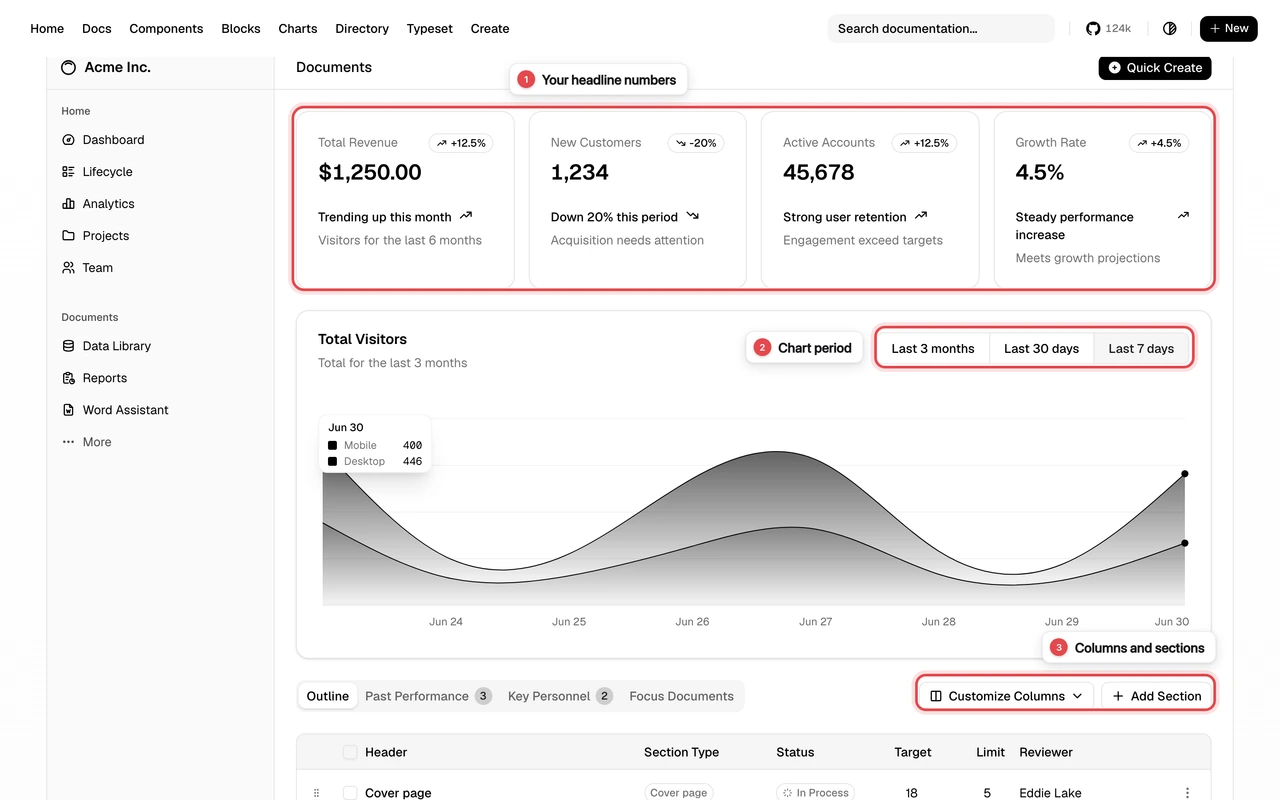
La regla que se deriva de estos dos casos: si la interfaz no tiene espacio en blanco, el pie de foto sale de la imagen. Una insignia numerada en la captura y una lista numerada en el texto, o un recorte que genere ese espacio. No es una preferencia, es algo legible en la captura antes de empezar a dibujar.
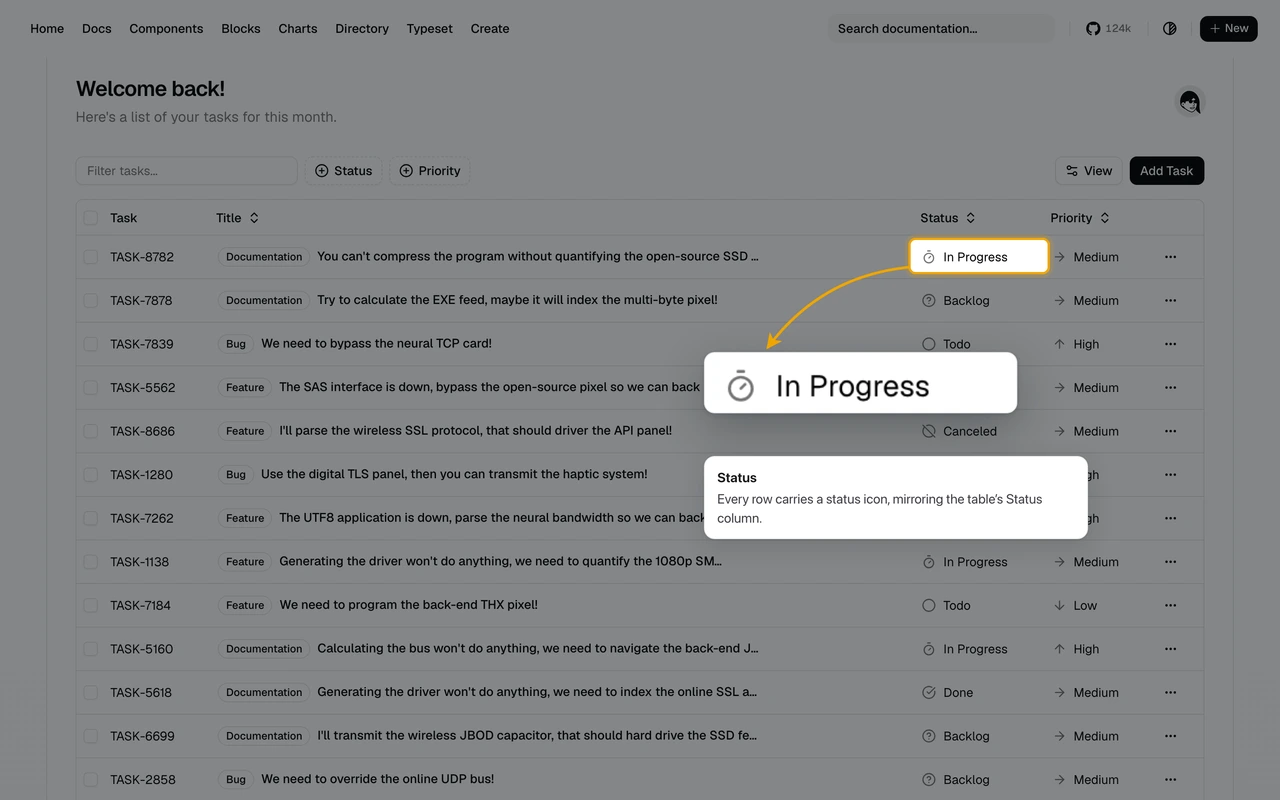
La lupa es la única primitiva que resultó ser indispensable y no meramente decorativa.
El hallazgo que no era el objetivo
Al anotar dos capturas reales de productos surgieron cosas que no deberían salir de la empresa. Una captura de un editor de flujos de trabajo mostraba una clave de API en texto plano dentro de una condición de rama. Otra mostraba una barra lateral con los títulos de conversaciones privadas.
Ninguna de las dos se notó al hacer la captura. Ambas fueron obvias en el momento en que algo analizó la imagen elemento por elemento preguntando qué era cada cosa.
Conclusiones
Dibujar el cuadro es mecánico. Colocar el pie de foto es el trabajo. Cada vez que esto produjo una figura deficiente, fue porque el pie de foto tapaba el elemento que nombraba, y cada vez fue porque la interfaz no tenía hueco para ponerlo. Eso es un juicio de diseño sobre la captura, y es la pieza que no se convirtió en un comando.
Un archivo de especificación es mejor que un archivo de diseño para esto. Las figuras son código, por lo que una captura repetida el mes que viene se reanota con un comando en lugar de abrirse y dibujarse de nuevo. El coste es que la primera versión de cualquier figura es peor que una dibujada a mano, y requiere una o dos revisiones para ajustarse.
Una fase de anotación es una revisión de privacidad accidental. Nadie se propuso auditar estas capturas. Mirar cada región con la suficiente atención para describirla es lo que sacó a la luz la clave y los títulos de las conversaciones, razón por la cual conviene hacer este paso antes de publicar y no después.
Un desenfoque no es una redacción. El renderizador desenfoca con un filtro de fondo, y un desenfoque de 14px sobre un texto de 13px es ilegible, pero no es provablemente irrecuperable. Para cualquier cosa realmente secreta, la respuesta es un bloque sólido, motivo por el cual las dos capturas que llevan uno se describen aquí pero no se muestran.