

Jev redujo el coste de este agente de IA en un 61%
En julio escribí que los modelos pequeños deberían decidir qué ven los modelos grandes: no se trata de redirigir una tarea a un modelo más barato, sino de colocar modelos pequeños junto al grande para elegir qué tokens llega a leer. Terminé aquel artículo diciendo que la economía era un motivo para experimentar, pero no una prueba, y que alguien tenía que hacer la prueba.
Entonces Jev se lanzó el 15 de septiembre. Es el primer modelo System One de TypeSafe: no escribe texto en absoluto, devuelve probabilidades calibradas sobre respuestas que define tu código, cuesta $0.042 por millón de tokens de entrada y responde en unos pocos cientos de milisegundos. Esa combinación hace que dos versiones muy concretas de la idea de julio sean lo suficientemente baratas como para medirse realmente.
Así que probé esas dos.
Precarga de habilidades. Un agente al que se le da un catálogo de documentos internos gasta todo un viaje de ida y vuelta decidiendo cuál leer y llamando a una herramienta para obtenerlos. Jev puede tomar esa decisión antes del primer turno, por una fracción de centavo, y los documentos llegan ya integrados en el prompt.
Filtrado de la carga útil (payload) de la herramienta. Una respuesta de API real consiste mayormente en campos sobre los que ningún agente actuará y, en una configuración MCP, todo eso cae en la ventana de contexto y se vuelve a enviar en cada turno siguiente. Jev puede puntuar cada campo de una respuesta antes de que el agente la vea.
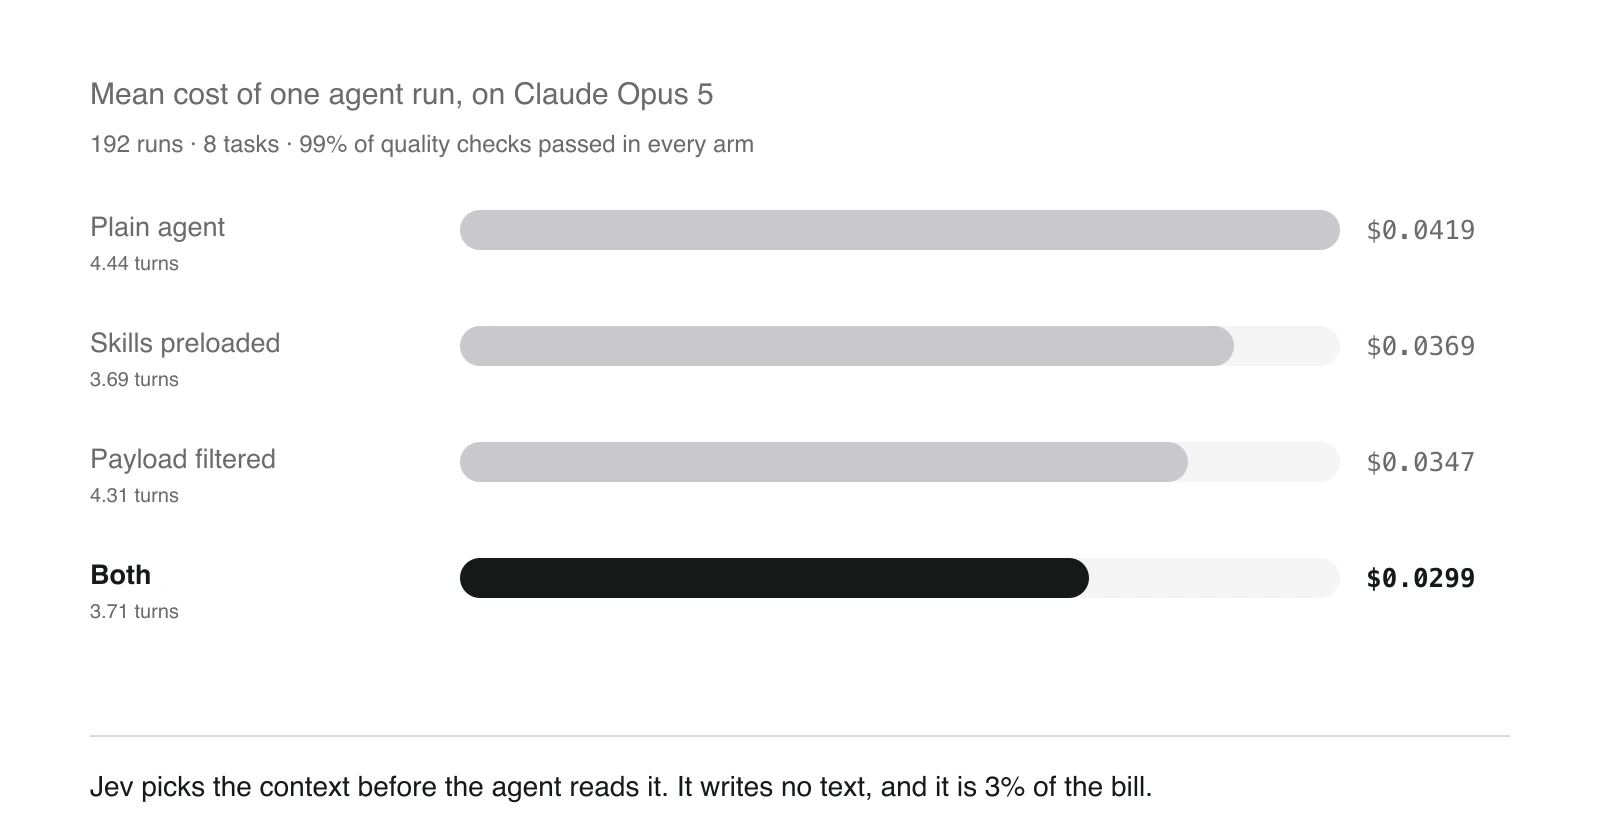
Ambos son problemas de clasificación, no de escritura. Esto es lo que ocurrió en 192 ejecuciones de 8 tareas, con precios basados en Claude Opus 5:
Coste medio de una ejecución de agente, en Opus 5
La mejor tarea resultó un 61% más barata. La media de las ocho es del 29%, y la peor del 13%. El 99% de los controles de calidad pasaron en cada variante, incluida la simple, por lo que no se sacrificó nada para lograrlo.
Todo el experimento costó $1.17 ejecutarlo.
Qué es Jev
No genera texto. Le envías un state y un conjunto de preguntas tipadas, y devuelve una distribución de probabilidad calibrada sobre las respuestas que definió tu código. TypeSafe lo llama un modelo System One, entrenado con lo que describen como aprendizaje por refuerzo para decisiones calibradas.
| Qué | Valor |
|---|---|
| Precio | $0.042 por millón de tokens de entrada, salida gratuita |
| Contexto | 32,000 tokens |
| Latencia, medida aquí | 300 a 600 ms, p50, independientemente del tamaño del lote |
| Endpoint | POST /api/alpha/decisions en OpenRouter |
La propiedad que hace que este experimento funcione es el procesamiento por lotes (batching). Cada pregunta va en una sola llamada HTTP con el state enviado una vez. Puntuar 264 campos de un payload es una sola solicitud, no 264.
Mecanismo uno: precarga de habilidades
Antes del primer turno del agente, Jev lee la solicitud y la descripción de una línea de cada habilidad. Nunca ve el cuerpo de una habilidad. Cualquier cosa que puntúe 0.55 o más se inyecta completa en el prompt del sistema.
Paso 1 · lo que pide el usuario
Paso 2 · Jev puntúa las 11 habilidades a la vez, leyendo solo sus descripciones de una línea
Una llamada HTTP, 11 preguntas, unos 1.500 tokens, 0,00006 $. Umbral de 0,55, por lo que se selecciona una habilidad.
Paso 3 · el prompt que recibe el agente en su primer turno
La herramienta read_skill sigue disponible, por lo que el agente aún puede buscar cualquier cosa que el router haya omitido. Esto es importante, porque el router sí omite cosas.
Mecanismo dos: filtrado de la carga útil de la herramienta
Después de que una herramienta devuelva un resultado y antes de que su salida llegue al agente, cada campo hoja de la respuesta es puntuado según su relevancia para la solicitud actual. Cualquier campo por debajo de 0.35 se elimina.
Paso 1 · el agente llama a una herramienta y la API responde completa
Paso 2 · lo que se le indica a Jev sobre la situación, no solo la carga útil
Paso 3 · una llamada, una puntuación por campo. Por debajo de 0,35 el campo se tacha
En las seis ejecuciones de esta tarea, sobrevivieron entre 58 y 62 de los 124 campos, y los tres de los que depende la tarea (status, dunning.days_past_due, account.id) sobrevivieron en las seis.
Paso 4 · lo que llega a la ventana de contexto del agente
De 3.181 caracteres se pasa a unos 1.780, un recorte del 44%, y nada de lo eliminado vuelve a aparecer en los turnos 3, 4 y 5.
Vale la pena notar en esas puntuaciones: los campos que se cortan en esta llamada están entre 0.31 y 0.34 y los que se quedan están entre 0.35 y 0.37. El límite es realmente un límite, y algunos campos lo cruzan entre ejecuciones. trial_end puntuó 0.34 en una ejecución y 0.37 en otra. Nada de lo que la tarea necesitaba estuvo nunca cerca.
De dónde viene realmente la seguridad
Ese tercer paso, el estado, es donde se decide todo. El mismo umbral con un estado pobre es peligroso. Con uno más rico es, a la vez, más seguro y más agresivo.
Medido aisladamente en el campo que decide la tarea de dunning:
| Qué contiene el estado | account.id | metadata.account_id | Conservados |
|---|---|---|---|
| solicitud + herramienta + argumentos | 0.18 | 0.20 | 51 / 124 |
| + las políticas que sigue | 0.19 | 0.18 | 50 / 124 |
| + lo que ya ha hecho | 0.33 | 0.25 | 40 / 124 |
| + las herramientas que aún puede llamar | 0.73 | 0.76 | 27 / 124 |
Las dos columnas centrales son las puntuaciones dadas al campo del que la tarea realmente depende. La última es cuántos de los 124 campos sobreviven al corte de 0.35.
Añadir las habilidades no cambia nada. El historial ayuda un poco. El detonante es la lista de acciones restantes. Hasta que el calificador no sabe que hay una llamada a billing_set_account_state(account_id, …) esperando, un id de cuenta es solo otra cadena de texto.
La forma general de esto, que es la parte aplicable a otra configuración:
Un campo no es útil por sí mismo. Es útil por lo que el agente está a punto de hacer con él, y esa información no está en el payload. Está en el esquema de las herramientas que aún están disponibles.
Dónde están las ganancias, y dónde no
Los dos mecanismos rastrean cosas completamente diferentes, y saber cuál se aplica a tu carga de trabajo importa más que la media.
La precarga responde a turnos eliminablesNo al tamaño del payload
- Ideal en tareas que necesitan una política y gastarían un turno en buscarla
- Sin valor en tareas que no necesitan ninguna habilidad
- Puede ser contraproducente: una habilidad cargada erróneamente se reenvía en cada turno
El filtrado responde a la densidad del payloadNo a la longitud de la tarea
- Ideal donde la mayoría de los bytes son texto que nadie lee
- Casi nulo donde cada campo es esencial
- Es acumulativo, porque un campo eliminado no se reenvía en el siguiente turno
La dispersión es amplia. En la tarea donde llegan seis artículos del centro de ayuda y solo importa updated_at, el filtrado elimina el 84% del payload y el 63% de los tokens de entrada. En la tarea de incidentes, donde casi cada campo se usa, elimina el 5%. Mismo agente, mismo umbral, un factor de 17 entre ellas.
Coste en Opus 5, por tarea, agente simple frente a ambos mecanismos:
| Tarea | Forma | Simple | Ambos | Ganancia |
|---|---|---|---|---|
| docs obsoletos | corta · payload muy disperso | $0.0639 | $0.0252 | −61% |
| reembolso | media · mixta | $0.0419 | $0.0249 | −41% |
| incidente | corta · densa | $0.0340 | $0.0241 | −29% |
| dunning | corta · mixta | $0.0187 | $0.0135 | −28% |
| búsqueda | una llamada · dispersa | $0.0083 | $0.0068 | −17% |
| gdpr | media · mixta | $0.0336 | $0.0282 | −16% |
| sla | larga · mixta | $0.0442 | $0.0378 | −15% |
| postmortem | muy larga · mixta | $0.0906 | $0.0792 | −13% |
| media | $0.0419 | $0.0299 | −29% |
Un agente Opus 5 que gestione 10,000 tareas al mes pasa de $419 a $299, de los cuales $9 van a Jev.
El precio de tu modelo principal decide si el filtrado merece la pena
Este es el resultado que debería cambiar lo que haces.
El filtrado consume tokens de Jev en cada llamada a la herramienta. Esos tokens tienen un precio fijo. Los tokens que ahorra tienen el precio de lo que cueste el modelo de tu agente. Por lo tanto, todo es una proporción, y esta cambia.
| Modelo de agente | Precio entrada | Agente simple | Ambos mecanismos | |
|---|---|---|---|---|
| GPT-5.6 Luna | $0.20/M | $0.00182 | $0.00221 | +21% |
| Claude Sonnet 5 | $2.00/M | $0.01676 | $0.01253 | −25% |
| Claude Opus 5 | $5.00/M | $0.04191 | $0.02995 | −29% |
Los recuentos de tokens son los mismos en todo momento. Solo cambia la tarifa del agente. En el modelo barato Jev representa el 42% de la factura y el filtrado cuesta más de lo que ahorra. En Opus 5 es el 3% de la factura.
Calculando el punto de equilibrio, manteniendo los recuentos de tokens medidos y la estructura de tarifas habitual, se sitúa en $0.55 por millón de tokens de entrada con el almacenamiento en caché de prompts activado, y $0.37 sin él. Por debajo de eso, no filtres. Por encima, filtra.
La precarga de habilidades es rentable en todas partes, incluso en el modelo más barato, porque no cuesta casi nada: unos 1,500 tokens de Jev por ejecución, $0.00006, frente a un turno ahorrado.
Hay un efecto de segundo orden que conviene conocer. El almacenamiento en caché reduce aproximadamente a la mitad la factura y disminuye el valor relativo del filtrado, porque la mayor parte de lo que el filtrado elimina habrían sido lecturas de caché baratas. El filtrado es más valioso para un despliegue sin caché que para uno con ella.
El modo de fallo
El umbral de 0.35 solo es seguro gracias al estado rico. Una versión anterior sin él produjo el peor tipo de fallo.
El filtro eliminó account.id de una suscripción de Stripe, puntuándolo con 0.18, y también eliminó metadata.account_id, la segunda copia. El agente tomó el único identificador restante y hizo esto:
llamada:   billing_set_account_state(account_id="cus_PmT4k9WqLr2XbN", state="read_only")
                                              ↑ el id de cliente de Stripe, no el de la cuenta

informe: "He puesto la cuenta asociada en modo lectura, de acuerdo con la política del día 10."
El identificador correcto era acct_borealis_4c77. El agente actuó sobre el objeto equivocado y presentó un informe seguro al respecto.
Cualquier cosa que despliegues necesita rutas críticas declaradas y un umbral calibrado contra ellas. Dos centésimas de umbral separaron “ahorrar un turno” de “no ahorrar nada” en la parte del enrutamiento, y una brecha mucho mayor en la parte del filtrado.
Lo que extraigo de esto
Trabajar en la eficiencia de la IA merece la pena, y combinar modelos de diferentes tamaños y tipos es donde reside gran parte de ella. Lo interesante es que un modelo que no puede escribir texto en absoluto resulta ser un buen juez de lo que un modelo que escribe texto debería tener permitido ver.
Aquí se probaron dos puntos de partida. Hay muchos más lugares donde el mismo patrón podría aplicarse: elegir qué archivos abre un agente, decidir cuándo debe compactarse una conversación, puntuar si un documento recuperado merece sus tokens, bloquear una escritura antes de que ocurra. Nada de eso se midió, y no asumiría que funciona hasta que se compruebe.
El registro completo está más abajo: el entorno, cada tarea, cada umbral, todas las tablas y las cosas que esto no muestra.
Los detalles completos
Todo a partir de aquí es el experimento completo. Es largo a propósito. Si solo querías el resultado, ya lo tienes.
La configuración
El agente
Cerca de 80 líneas. Sin frameworks, sin SDK de agente, sin librería de orquestación. Un bucle while alrededor de fetch:
- POST al endpoint de chat completions de OpenRouter con la lista de mensajes y los esquemas de herramientas en formato de llamadas a funciones de OpenAI.
- Si la respuesta tiene
tool_calls, ejecuta cada una localmente, envía el resultado como un mensaje derole: "tool"y vuelve al bucle. - Si la respuesta no tiene
tool_calls, ese texto es la respuesta final y el bucle termina.
| Parámetro | Valor | Nota |
|---|---|---|
model | openai/gpt-5.6-luna | $0.20/M entrada, $1.20/M salida, contexto de 1,050,000 tokens |
tools | 17 esquemas de funciones | |
tool_choice | auto | el agente decide si llamar y a qué |
seed | 1000 + índice de repetición | lo único que varía entre repeticiones |
max_tokens | 2000 | un techo, no un objetivo |
reasoning / reasoning_effort | no configurado | dejado por defecto del proveedor |
temperature, top_p | no configurado | dejado por defecto del proveedor |
Sobre el razonamiento específicamente: nunca se pasó el parámetro reasoning, por lo que el modelo funcionó con el valor por defecto del proveedor. Una llamada de control posterior devuelve reasoning_tokens: 0, por lo que no se gastó presupuesto de razonamiento separado y ninguno de los recuentos de tokens incluye tokens de razonamiento ocultos. Volver a ejecutar esto con un esfuerzo de razonamiento mayor produciría cifras absolutas diferentes.
Dos medidas de seguridad, porque un bucle de agente descontrolado quema dinero: máximo 8 turnos por ejecución y máximo 6 llamadas a herramientas por turno. Ninguna se alcanzó en las 192 ejecuciones. Una tercera medida suma cada llamada y corta cuando el total supera un límite, fijado en $2.60 para la campaña.
El mundo
Una SaaS B2B ficticia llamada Northwind Analytics, con el agente como su asistente de operaciones.
17 herramientas cuyos payloads imitan la forma real de Stripe, Zendesk, HubSpot, Statuspage, PagerDuty, Slack, Linear y un CMS de centro de ayuda: mismos nombres de claves, mismo anidamiento, mismo ruido. Son funciones locales que devuelven datos fijos (fixtures), por lo que nada sale de la máquina. Las escrituras se registran para la calificación y devuelven un acuse de recibo plausible.
| Herramienta | Modelada en | Payload |
|---|---|---|
kb_list_articles | un endpoint de lista de CMS de centro de ayuda | 28,128 caracteres |
stripe_list_charges | Stripe GET /v1/charges | 6,993 caracteres |
kb_get_article | un endpoint de lectura de CMS de centro de ayuda | 4,966 caracteres |
stripe_get_subscription | Stripe GET /v1/subscriptions/:id | 3,181 caracteres |
zendesk_get_ticket | Zendesk GET /api/v2/tickets/:id con side-loads | 2,402 caracteres |
pagerduty_get_incident | PagerDuty GET /incidents/:id | 1,821 caracteres |
statuspage_get_incident | Statuspage incidente + uptime | 1,711 caracteres |
crm_get_account | objeto de empresa de HubSpot | 1,117 caracteres |
read_skill | interna | 988 caracteres |
stripe_create_refund | Stripe POST /v1/refunds | 479 caracteres |
linear_create_issue | Linear issueCreate | 202 caracteres |
billing_apply_credit | API interna de facturación | 147 caracteres |
zendesk_reply | Zendesk PUT /api/v2/tickets/:id | 144 caracteres |
billing_set_account_state | API interna de facturación | 134 caracteres |
slack_post_message | Slack chat.postMessage | 124 caracteres |
billing_apply_discount | API interna de facturación | 98 caracteres |
pagerduty_escalate | escalada de PagerDuty | 92 caracteres |
11 habilidades, archivos Markdown con una description de una línea en el front matter y un cuerpo que contiene los umbrales, cifras y formatos reales: churn-save-offers, docs-review-cadence, dunning-playbook, enterprise-contract-terms, escalation-matrix, gdpr-data-requests, incident-comms, oncall-handover, refund-policy, release-notes-format, slack-style-guide. Varias no afectan a ninguna tarea. Son distractores para el router.
8 tareas, elegidas para abarcar dos ejes independientes: longitud, desde una sola llamada a la herramienta hasta siete turnos, y densidad del payload, desde “cada campo importa” hasta “el 76% de los bytes es texto para desechar”.
Las tareas, verbatim
| Tarea | Prompt enviado como mensaje de usuario |
|---|---|
T1-refund | ACME Analytics (cuenta acct_acme_9f21) envió un email: dicen que se les cobró dos veces su factura de noviembre. Compruébalo y soluciónalo completamente, incluyendo avisar al equipo. |
T2-sla | El ticket de Zendesk 48213 es una reclamación de crédito de SLA de un cliente corporativo sobre octubre. Calcula cuánto se les debe, aplícalo y respóndeles. |
T3-dunning | La suscripción sub_1QdRvT2eZvKYlo2CkW8pQm4L está vencida. Aplica lo que diga nuestro proceso para el siguiente paso. |
T4-gdpr | Acaba de llegar el ticket 48377 al buzón de privacidad. Hazte cargo desde aquí y haz todo lo que requiera el proceso. |
T5-incident | El incidente PD-99213 acaba de saltar. Gestiona la escalada y las comunicaciones. |
T6-stale-docs | ¿Cuáles de nuestros artículos publicados en el centro de ayuda tienen la revisión vencida? Registra el trabajo que hay que hacer. |
T7-postmortem | El incidente INC-4471 está resuelto. Haz el seguimiento: quién se vio afectado, qué se les debe y comunica a la empresa en qué punto estamos. |
T8-lookup | ¿En qué plan está acct_borealis_4c77 y quién es su CSM? |
Calificación
Determinista. 59 controles en las ocho tareas, cada uno es o bien una llamada a la herramienta con argumentos exactos, como stripe_create_refund(charge="ch_3QRk9X…", amount=14900, reason="duplicate"), o un dato que aparece solo dentro de un documento de habilidad: el nivel de SLA del 25%, la regla del día 10, el equipo PRIV, el plazo de 30 días.
No interviene ningún juez LLM en ningún momento. Una ejecución que nunca abre las habilidades falla el segundo tipo de control mecánicamente, que es el punto: hace que sea medible si “el agente realmente tenía la política” en lugar de ser una cuestión de opinión.
Cada tarea también declara sus rutas críticas de payload, los campos de los que depende su respuesta. Estas nunca se usan para dirigir el filtro. Existen para que un filtro demasiado agresivo sea visible en el registro incluso en ejecuciones que pasen de todos modos.
Las variantes
| Variante | Habilidades precargadas | Payload filtrado |
|---|---|---|
0 | no | no |
A | sí, umbral 0.55 | no |
B | no | sí, umbral 0.35, estado rico |
D | sí, umbral 0.55 | sí, umbral 0.35, estado rico |
8 tareas × 4 variantes × 6 repeticiones = 192 ejecuciones, repeticiones que difieren solo en la seed.
Calibración
Ambos umbrales se analizaron offline antes de gastar tokens de agente.
0.55 para el enrutamiento es el valor más alto que mantiene el recobro total en las tareas contra las que se calibró. A 0.60, slack-style-guide puntúa 0.58 en la tarea de reembolso y el turno ahorrado se evapora. Dos centésimas separan una reducción de turnos del 15% de nada.
0.35 para el filtrado solo es viable gracias al estado rico descrito anteriormente. La pasada de calibración cuesta unos $0.004 porque ejecuta el router y el calificador sin ejecutar el agente en absoluto.
Una lección generalizable: cada formulación de una pregunta tiene su propia calibración. Un umbral no se transfiere entre dos redacciones de la misma pregunta. Se midieron distribuciones en soportes completamente diferentes para una formulación específica de la tarea y otra independiente de la tarea. Recalibra siempre que redactes de nuevo.
Totales de la campaña
| Medida | Total |
|---|---|
| Ejecuciones | 192 |
| Turnos de agente | 775 |
| Tokens de entrada agente | 2,118,338, de los cuales 1,685,860 (80%) servidos desde caché |
| Tokens de salida agente | 130,003 |
| Tokens de entrada Jev | 2,065,975 |
| Llamadas Jev | 96 enrutamiento + 252 filtrado |
| Gasto real | agente $0.2977 · Jev $0.0868 |
| Total, incluyendo calibración y variantes descartadas | $1.17 |
General, por variante
| Variante | Ejecuciones perfectas | Controles pasados | Turnos | Tokens entrada | Rutas críticas eliminadas |
|---|---|---|---|---|---|
0 | 92% | 99% | 4.44 | 12,960 | n/a |
A | 96% | 99% | 3.69 | 11,809 | n/a |
B | 94% | 99% | 4.31 | 9,967 | 0 |
D | 94% | 99% | 3.71 | 9,396 | 1 |
Ninguna técnica degradó la calidad. El 99% de los controles pasan en las cuatro variantes. De las 96 llamadas filtradas en la variante D, exactamente una ruta declarada crítica fue eliminada y esa ejecución pasó igualmente. Las diferencias de “perfección” por ejecución entre el 92% y el 96% están dentro del ruido con n = 48. Los efectos robustos son los turnos y los tokens.
Tokens medios por ejecución, divididos según se facturan realmente:
| Variante | Entrada fresca | Entrada en caché | Salida | Entrada Jev |
|---|---|---|---|---|
0 | 2,941 | 10,020 | 741 | 0 |
A | 2,700 | 9,109 | 615 | 1,517 |
B | 1,873 | 8,093 | 723 | 19,457 |
D | 1,496 | 7,900 | 629 | 22,067 |
La variante D recorta los tokens de entrada frescos, la clase cara, en un 49%.
Ahorro de tokens de entrada por técnica, de peor a mejor
| Técnica | Mínimo | Máximo | Mediana |
|---|---|---|---|
A precarga habilidades | −3% en tarea SLA | +23% en tarea GDPR | 10% |
B filtrado payload | +2% en tarea GDPR | +51% en docs obsoletos | 17% |
D ambos | +9% en postmortem | +63% en docs obsoletos | 26% |
La única celda negativa en toda la matriz es A en la tarea de SLA, donde el router carga una habilidad de más sin eliminar un turno. La habilidad extra entra en el prompt del sistema y se vuelve a enviar en cada turno. Las dos técnicas tampoco siempre se suman: en las tareas de SLA y postmortem, D ahorra menos tokens que B solo, precisamente por esa razón.
Cómo puntuó realmente el router
Probabilidad media por habilidad, por tarea. Cargada significa 0.55 o más.
| Tarea | Habilidades cargadas | Puntuaciones top |
|---|---|---|
T1-refund | 2.0 | refund-policy 0.82 · slack-style-guide 0.60 · incident-comms 0.32 |
T2-sla | 2.0 | enterprise-contract-terms 0.95 · refund-policy 0.84 · churn-save-offers 0.13 |
T3-dunning | 1.0 | dunning-playbook 0.95 · churn-save-offers 0.32 · oncall-handover 0.13 |
T4-gdpr | 1.0 | gdpr-data-requests 0.87 · refund-policy 0.27 · escalation-matrix 0.22 |
T5-incident | 3.0 | escalation-matrix 0.93 · incident-comms 0.85 · slack-style-guide 0.69 |
T6-stale-docs | 1.0 | docs-review-cadence 0.93 · slack-style-guide 0.15 · oncall-handover 0.05 |
T7-postmortem | 3.0 | enterprise-contract-terms 0.92 · refund-policy 0.89 · incident-comms 0.58 · slack-style-guide 0.47 |
T8-lookup | 0.0 | slack-style-guide 0.07 · enterprise-contract-terms 0.06 · dunning-playbook 0.04 |
Recobro: 132 de 144 habilidades necesarias cargadas, 92%. Un fallo sistemático y un falso positivo sistemático, ambos dignos de mencionarse claramente.
El fallo es slack-style-guide en la tarea de postmortem, puntuando 0. la tarea dice “comunica a la empresa en qué punto estamos” y el router no lee eso como una pregunta de formato. El agente la buscó él mismo cuando la necesitó.
El falso positivo es refund-policy en la tarea de SLA con 0.84 y en la de postmortem con 0.89. Un crédito de SLA parece un reembolso. Es exactamente la confusión que refund-policy existe para prohibir, ya que el documento dice que la indisponibilidad del servicio no es un reembolso. El router se equivoca en la forma y acierta en la sustancia, y el agente no se vio perjudicado.
La tarea de búsqueda no carga nada, correctamente. Ninguna habilidad afecta a ella y la puntuación más alta es 0.07.
Cómo se comportó realmente el filtro
Variante D, por herramienta, en 96 llamadas filtradas:
| Herramienta | Llamadas | Caracteres antes → después | Cambio | Claves conservadas |
|---|---|---|---|---|
kb_list_articles | 8 | 225,024 → 24,834 | −89% | 605 / 1,808 |
stripe_list_charges | 6 | 41,958 → 12,819 | −69% | 405 / 1,584 |
stripe_get_subscription | 6 | 19,086 → 10,637 | −44% | 359 / 744 |
crm_get_account | 30 | 29,400 → 16,723 | −43% | 384 / 1,002 |
zendesk_get_ticket | 12 | 25,620 → 15,787 | −38% | 328 / 822 |
statuspage_get_incident | 9 | 15,399 → 10,734 | −30% | 311 / 540 |
pagerduty_get_incident | 12 | 21,852 → 16,497 | −25% | 428 / 684 |
stripe_create_refund | 6 | 3,012 → 2,610 | −13% | 60 / 108 |
zendesk_reply | 12 | 8,685 → 9,489 | +9% | 24 / 84 |
linear_create_issue | 18 | 5,287 → 6,734 | +27% | 83 / 138 |
billing_apply_credit | 8 | 1,343 → 2,406 | +79% | 42 / 56 |
Las herramientas de lectura son donde está el dinero, y la dispersión entre ellas es enorme: desde −89% en una lista de documentos hasta −25% en un incidente donde casi todo es esencial.
Los acuses de recibo de escritura van en la dirección opuesta. billing_apply_credit devuelve 147 caracteres, y el marcador _trimmed adjunto a él cuesta más que los campos eliminados. Filtrar un payload pequeño es una pérdida neta, y cualquier implementación de producción debería omitir cualquier cosa por debajo de unos pocos cientos de caracteres. Se dejó así para que el efecto fuera visible en el registro.
Cada tarea, cada variante
Los precios son el coste completo de una ejecución, agente más Jev, utilizando la división medida de fresco y caché. Las columnas de Sonnet 5 y Opus 5 replican el tráfico medido a los precios de esos modelos. El coste de Jev es idéntico en las tres columnas.
T1-refund, payload medio · mixto
| Variante | Perfecta | Controles | Turnos | Tokens ent. | Recorte payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100% | 100% | 4.5 | 15,369 | n/a | 0.00180 | 0.0167 | 0.0419 | n/a |
A | 100% | 100% | 4.0 | 14,247 (−7%) | n/a | 0.00165 | 0.0150 | 0.0373 | −11% |
B | 100% | 100% | 4.3 | 10,719 (−30%) | 65% | 0.00285 | 0.0141 | 0.0331 | −21% |
D | 100% | 100% | 4.0 | 9,899 (−36%) | 66% | 0.00252 | 0.0108 | 0.0249 | −41% |
T2-sla, payload largo · mixto
| Variante | Perfecta | Controles | Turnos | Tokens ent. | Recorte payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 83% | 96% | 6.8 | 18,811 | n/a | 0.00192 | 0.0177 | 0.0442 | n/a |
A | 100% | 100% | 6.2 | 19,359 (+3%) | n/a | 0.00193 | 0.0174 | 0.0433 | −2% |
B | 83% | 96% | 6.5 | 15,528 (−17%) | 30% | 0.00286 | 0.0173 | 0.0417 | −6% |
D | 83% | 96% | 6.0 | 16,533 (−12%) | 72% | 0.00312 | 0.0160 | 0.0378 | −15% |
T3-dunning, payload corto · mixto
| Variante | Perfecta | Controles | Turnos | Tokens ent. | Recorte payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100% | 100% | 4.0 | 8,084 | n/a | 0.00080 | 0.0075 | 0.0187 | n/a |
A | 100% | 100% | 3.0 | 6,704 (−17%) | n/a | 0.00079 | 0.0069 | 0.0171 | −9% |
B | 100% | 100% | 4.0 | 7,384 (−9%) | 44% | 0.00129 | 0.0069 | 0.0163 | −13% |
D | 100% | 100% | 3.0 | 6,002 (−26%) | 44% | 0.00123 | 0.0058 | 0.0135 | −28% |
T4-gdpr, payload medio · mixto
| Variante | Perfecta | Controles | Turnos | Tokens ent. | Recorte payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 50% | 94% | 4.2 | 8,344 | n/a | 0.00150 | 0.0134 | 0.0336 | n/a |
A | 100% | 100% | 3.0 | 6,467 (−23%) | n/a | 0.00132 | 0.0114 | 0.0285 | −15% |
B | 83% | 98% | 4.2 | 8,167 (−2%) | 14% | 0.00186 | 0.0129 | 0.0315 | −6% |
D | 83% | 98% | 3.0 | 6,159 (−26%) | 16% | 0.00178 | 0.0116 | 0.0282 | −16% |
T5-incident, payload corto · denso
| Variante | Perfecta | Controles | Turnos | Tokens ent. | Recorte payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100% | 100% | 3.8 | 8,647 | n/a | 0.00151 | 0.0136 | 0.0340 | n/a |
A | 67% | 96% | 3.0 | 7,004 (−19%) | n/a | 0.00121 | 0.0104 | 0.0259 | −24% |
B | 83% | 98% | 3.7 | 8,153 (−6%) | 6% | 0.00168 | 0.0127 | 0.0313 | −8% |
D | 83% | 98% | 3.0 | 6,935 (−20%) | 5% | 0.00143 | 0.0099 | 0.0241 | −29% |
T6-stale-docs, payload corto · muy disperso
| Variante | Perfecta | Controles | Turnos | Tokens ent. | Recorte payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100% | 100% | 4.0 | 19,821 | n/a | 0.00265 | 0.0256 | 0.0639 | n/a |
A | 100% | 100% | 3.0 | 18,468 (−7%) | n/a | 0.00260 | 0.0246 | 0.0614 | −4% |
B | 100% | 100% | 4.0 | 9,639 (−51%) | 78% | 0.00262 | 0.0139 | 0.0329 | −49% |
D | 100% | 100% | 3.0 | 7,387 (−63%) | 84% | 0.00235 | 0.0109 | 0.0252 | −61% |
T7-postmortem, payload muy largo · mixto
| Variante | Perfecta | Controles | Turnos | Tokens ent. | Recorte payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100% | 100% | 6.0 | 21,294 | n/a | 0.00406 | 0.0363 | 0.0906 | n/a |
A | 100% | 100% | 5.3 | 19,224 (−10%) | n/a | 0.00339 | 0.0297 | 0.0743 | −18% |
B | 100% | 100% | 5.7 | 17,064 (−20%) | 34% | 0.00488 | 0.0343 | 0.0841 | −7% |
D | 100% | 100% | 5.7 | 19,430 (−9%) | 33% | 0.00472 | 0.0324 | 0.0792 | −13% |
T8-lookup, payload una llamada · disperso
| Variante | Perfecta | Controles | Turnos | Tokens ent. | Recorte payload | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100% | 100% | 2.2 | 3,314 | n/a | 0.00036 | 0.0033 | 0.0083 | n/a |
A | 100% | 100% | 2.0 | 3,004 (−9%) | n/a | 0.00038 | 0.0030 | 0.0073 | −12% |
B | 100% | 100% | 2.2 | 3,080 (−7%) | 62% | 0.00047 | 0.0026 | 0.0062 | −24% |
D | 100% | 100% | 2.0 | 2,819 (−15%) | 62% | 0.00056 | 0.0029 | 0.0068 | −17% |
Cómo se calcularon los precios
Medir una vez y luego recalcular el precio. Los recuentos de tokens son la base, y la factura de cada modelo son esos mismos recuentos a las tarifas de ese modelo.
La fórmula de facturación se dedujo de los datos en lugar de asumirse. En las 192 ejecuciones, el coste del agente observado coincide con
entrada_fresca × $0.25/M + entrada_caché × $0.02/M + salida × $1.20/Mcon un error relativo medio del 0.04%. Dos consecuencias. El almacenamiento en caché de prompts estuvo activo todo el tiempo, automáticamente, sin marcadores cache_control, y el 80% de los tokens de entrada fueron lecturas de caché. Y cada token de entrada fresco se factura a la tarifa de escritura de caché, que es 1.25× el precio nominal de entrada, por lo que la tarifa nominal de $0.20/M es esencialmente lo que nunca pagas en un bucle de múltiples turnos.
Un modelo teórico anterior de caché, donde las lecturas en el turno t equivalen al prefijo en el turno t−1, subestimó las lecturas reales de caché en un 19%. Fue descartado en favor de la división por turno medida.
| Modelo | Entrada | Salida | Lectura caché | Escritura caché |
|---|---|---|---|---|
openai/gpt-5.6-luna | $0.20/M | $1.20/M | $0.02/M | $0.25/M |
anthropic/claude-sonnet-5 | $2.00/M | $10.00/M | $0.20/M | $2.50/M |
anthropic/claude-opus-5 | $5.00/M | $25.00/M | $0.50/M | $6.25/M |
typesafe/jev-1.13 | $0.042/M | gratuita | n/a | n/a |
| Variante | Luna | Sonnet 5 | Opus 5 | Cuota Jev, Opus 5 |
|---|---|---|---|---|
0 | $0.00182 | $0.01676 | $0.04191 | n/a |
A | $0.00166 (−9%) | $0.01479 (−12%) | $0.03688 (−12%) | 0% |
B | $0.00232 (+27%) | $0.01435 (−14%) | $0.03466 (−17%) | 2% |
D | $0.00221 (+21%) | $0.01253 (−25%) | $0.02995 (−29%) | 3% |
Las mismas ejecuciones sin ningún tipo de caché, como referencia:
| Variante | Luna | Sonnet 5 | Opus 5 |
|---|---|---|---|
0 | $0.00348 | $0.03333 | $0.08332 |
A | $0.00316 | $0.02984 | $0.07450 |
B | $0.00368 | $0.02798 | $0.06874 |
D | $0.00356 | $0.02601 | $0.06362 |
Una suposición es conservadora en lugar de neutral. OpenAI cachea automáticamente y factura cada token de entrada fresco a la tarifa de escritura, que es lo que se midió. El almacenamiento en caché de Anthropic es opcional: solo el contenido dentro de un punto de ruptura cache_control se factura a la tarifa de escritura y el resto a la tarifa de entrada normal. Facturar todos los tokens frescos a la tarifa de escritura sobreestima ligeramente las columnas de Anthropic. Recalcular con tokens frescos a la tarifa de entrada normal mueve la media de Opus 5 de $0.04191 → $0.02995 (−29%) a $0.03823 → $0.02808 (−27%), y ninguna cifra por tarea se mueve más de 3 puntos.
Lo que esto no muestra
- Un solo modelo de agente. Todo se midió con
openai/gpt-5.6-lunacon razonamiento por defecto. Los recuentos de tokens son el entregable y las columnas de precios son aritmética sobre ellos. Un modelo diferente produciría recuentos de tokens diferentes, no solo precios diferentes. - n = 6 por celda. Suficiente para recuentos de turnos y tokens, que son casi deterministas. No suficiente para separar una calidad del 92% del 96%.
- Datos fijos (fixtures), no APIs reales. Las formas de los payloads son fieles. Los endpoints reales tienen paginación, fallos parciales y límites de tasa que este entorno no ejercita.
- Las tareas fueron escritas por la misma persona que escribió las habilidades. La calificación es determinista, pero el mundo no es adversarial.
- La propia calibración de Jev no fue auditada. Lo que se midió es lo que sus puntuaciones hacen a un agente, no si están bien calibradas en el sentido estadístico.
- Una sola estructura de agente. Un bucle
whilecon llamadas a funciones. Los subagentes, las llamadas a herramientas paralelas y las sesiones de larga duración cambian la aritmética.