

Los modelos pequeños deberían decidir qué ven los grandes
Cada vez es más habitual que un modelo de IA potente coordine a otros más pequeños. El modelo grande planifica el trabajo y delega la clasificación, la extracción o las modificaciones previsibles en modelos más rápidos y baratos.
Tiene sentido. Pero solo optimiza quién realiza cada tarea.
Creo que se puede lograr una eficiencia aún mayor: usar modelos pequeños no solo por debajo del modelo grande, sino también a su alrededor.
Podrían preparar el contexto antes de que el modelo razone, filtrar los resultados de sus herramientas y conservar la información útil a medida que avanza la sesión.
El modelo grande seguiría tomando las decisiones difíciles. Pero, como es inteligente, lento y caro, cada token que procesa debería justificar su lugar.
Preparar el contexto en lugar de acumularlo
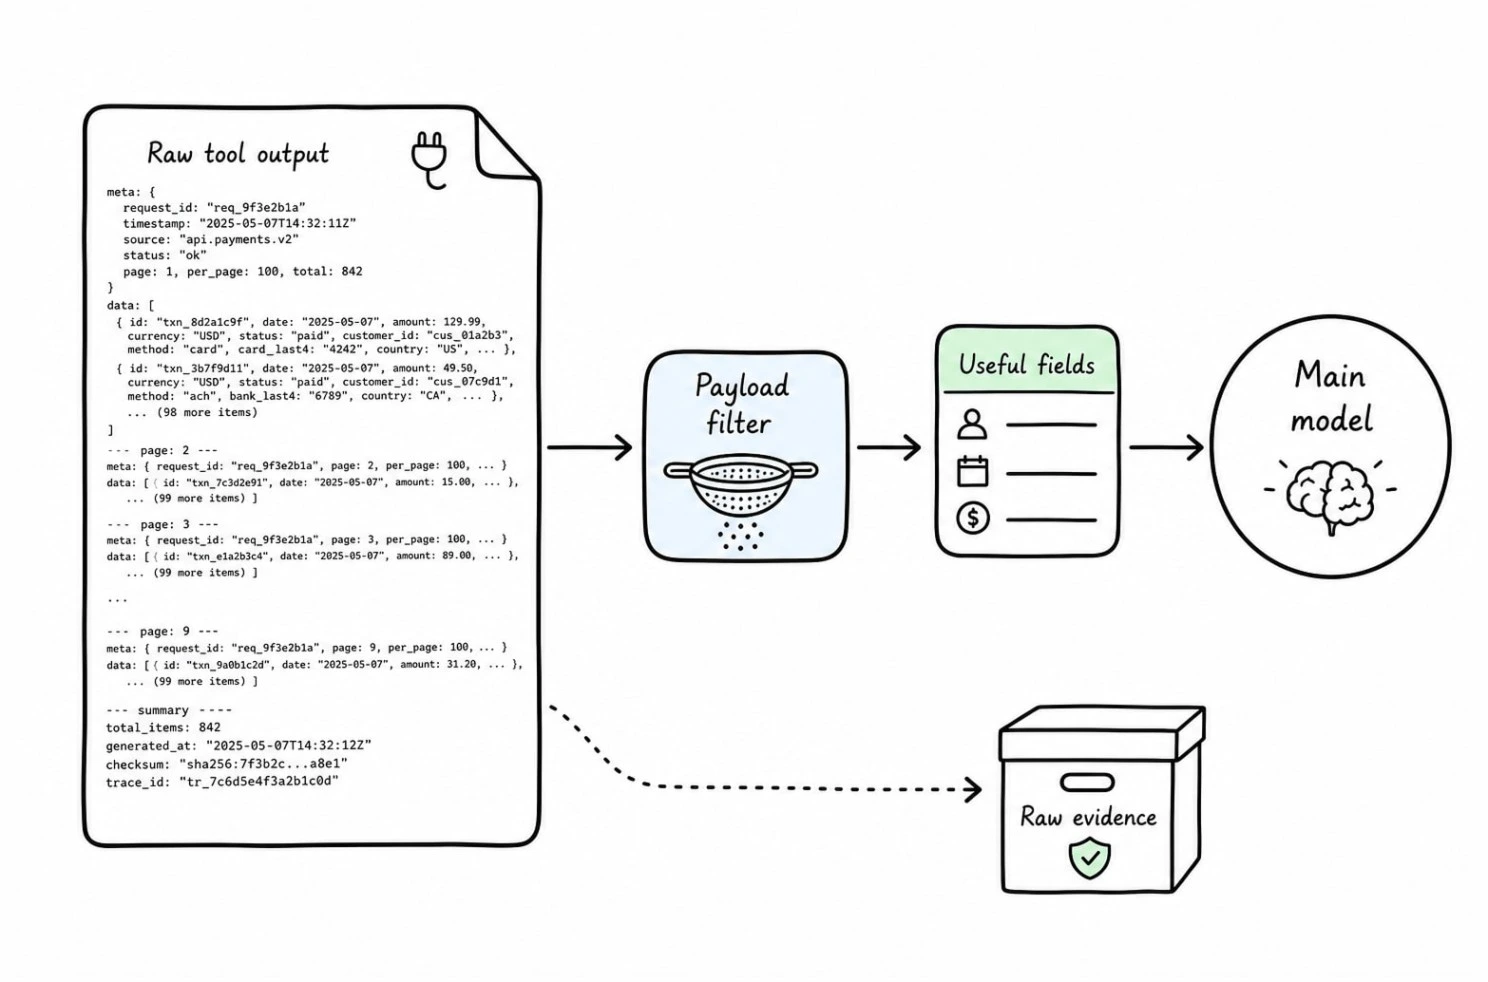
Los agentes de programación construyen un largo historial de trabajo: mensajes, planes, resultados de comandos, archivos, errores y versiones obsoletas de la misma información. Puede que cada elemento haya sido útil en algún momento. Pocos siguen siéndolo para todas las decisiones posteriores.
Los sistemas actuales suelen acumular este material hasta que borran resultados de herramientas, guardan recuerdos o compactan la conversación. La documentación de Anthropic considera que el contexto irrelevante amenaza la capacidad de concentración del modelo, y no solo la capacidad de la ventana de contexto.
Un modelo pequeño podría seleccionar el contexto antes de cada paso de razonamiento importante. Su respuesta podría tener este aspecto:
{
  "include_messages": [2, 7, 11],
  "include_files": [
    { "path": "src/auth.ts", "lines": "48-126" },
    { "path": "tests/auth.test.ts", "match": "refresh token" }
  ],
  "include_tool_results": ["call_184"],
  "durable_notes": ["The user rejected cookie-based sessions."],
  "omit_reason": "Unrelated build logs and superseded files"
}
El modelo grande recibiría los pasajes seleccionados de las fuentes, no un resumen impreciso de todo el historial. Se trata de una búsqueda de información en el espacio de trabajo del propio agente, que evoluciona con el tiempo.
Filtrar los resultados de las herramientas antes de que los lea el modelo principal
Una API o un servidor MCP puede devolver decenas de campos cuando el agente solo necesita tres. Los identificadores, las marcas de tiempo, los metadatos de paginación y las descripciones repetidas permanecen entonces en la transcripción y pueden volver a procesarse en turnos posteriores.
Un modelo pequeño podría interponerse entre la respuesta de la herramienta y el modelo principal. Filtraría el resultado sin procesar según el objetivo actual, devolvería un subconjunto tipado y conservaría una referencia al resultado original intacto. Esto resulta especialmente útil cuando quien desarrolla el agente no puede modificar la herramienta externa.
La misma capa podría clasificar archivos, localizar secciones relevantes y excluir contenido generado antes de que lo lea el modelo grande.
Comprimir la información mientras aún está fresca
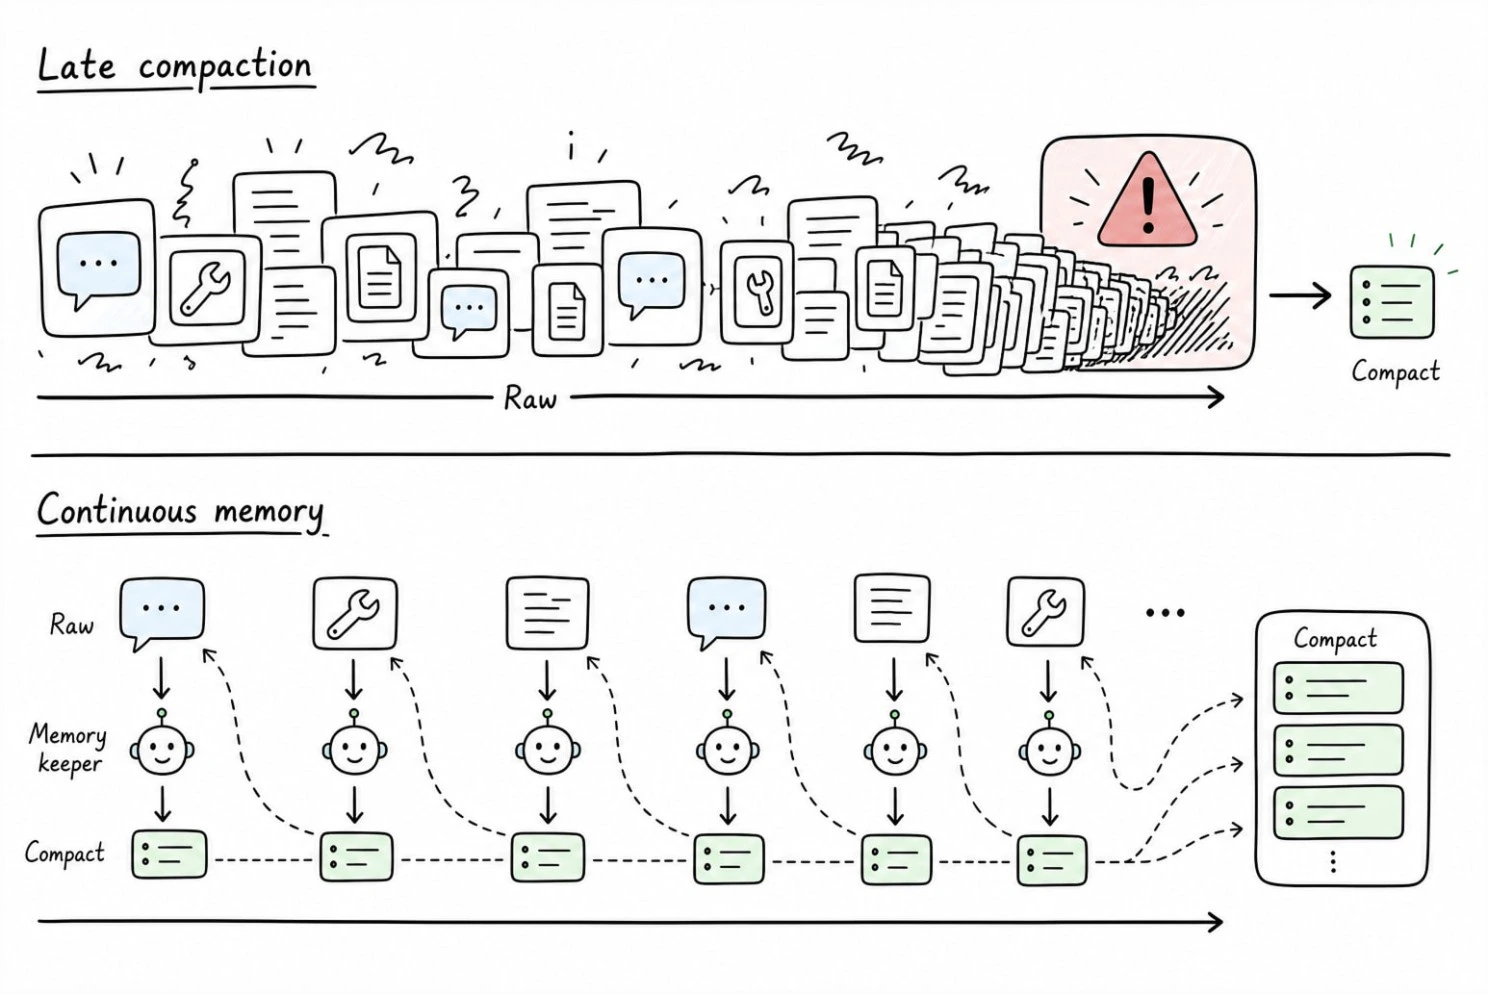
La compactación suele ser reactiva: cuando el contexto alcanza un umbral, un historial extenso se convierte en un breve resumen. Para entonces, es posible que el modelo principal ya haya releído muchas veces contenido prolijo. Además, un único resumen tardío debe conservar detalles de varias etapas cuya relevancia futura es difícil de prever.
El historial de un agente tiene dos lectores con necesidades distintas. Las personas necesitan los mensajes completos y el lenguaje natural para entender y auditar lo ocurrido. Los modelos de IA necesitan los mismos hechos expresados con el menor número posible de tokens fiables.
Un modelo pequeño podría mantener ambas versiones a medida que llega la información: la transcripción completa, legible para las personas, y una representación compacta y legible por máquina que se carga en el contexto activo. Cada elemento comprimido enlazaría con el original.
La versión para máquinas no tendría que estar redactada con esmero. Podría inspirarse en la reciente tendencia «Caveman» de los agentes de programación: frases telegráficas que eliminan artículos, fórmulas de cortesía, reservas y conectores superfluos, sin perder los detalles técnicos. No se trata de que las personas hablen así, sino de dejar de pagar a modelos grandes para que relean lenguaje escrito para personas.
Un registro de pruebas de 2,000 tokens podría quedar así:
14 pruebas superadas.
refreshes expired tokenfalló porqueexpiresAttenía el valorundefinedenauth.test.ts:88. Salida completa: artefactotest-run-184.
Se conservan el resultado, el fallo, el valor pertinente, la ubicación y la ruta de vuelta a las pruebas. El ruido, no.
Esto es mantenimiento continuo, no una compactación de emergencia.
La rentabilidad es plausible
La inferencia adicional solo merece la pena si ahorra más de lo que cuesta en dinero, latencia y errores. Un modelo sencillo muestra que el umbral de rentabilidad puede ser bajo.
Pensemos en una sesión ilustrativa de programación de 20 pasos. El modelo grande recibe un total de 1.45 millones de tokens de entrada. Un modelo de contexto lee el mismo historial, genera 10,000 tokens con instrucciones de selección y reduce la entrada del modelo grande a 560,000 tokens. En ambas versiones, el modelo grande genera 40,000 tokens de salida.
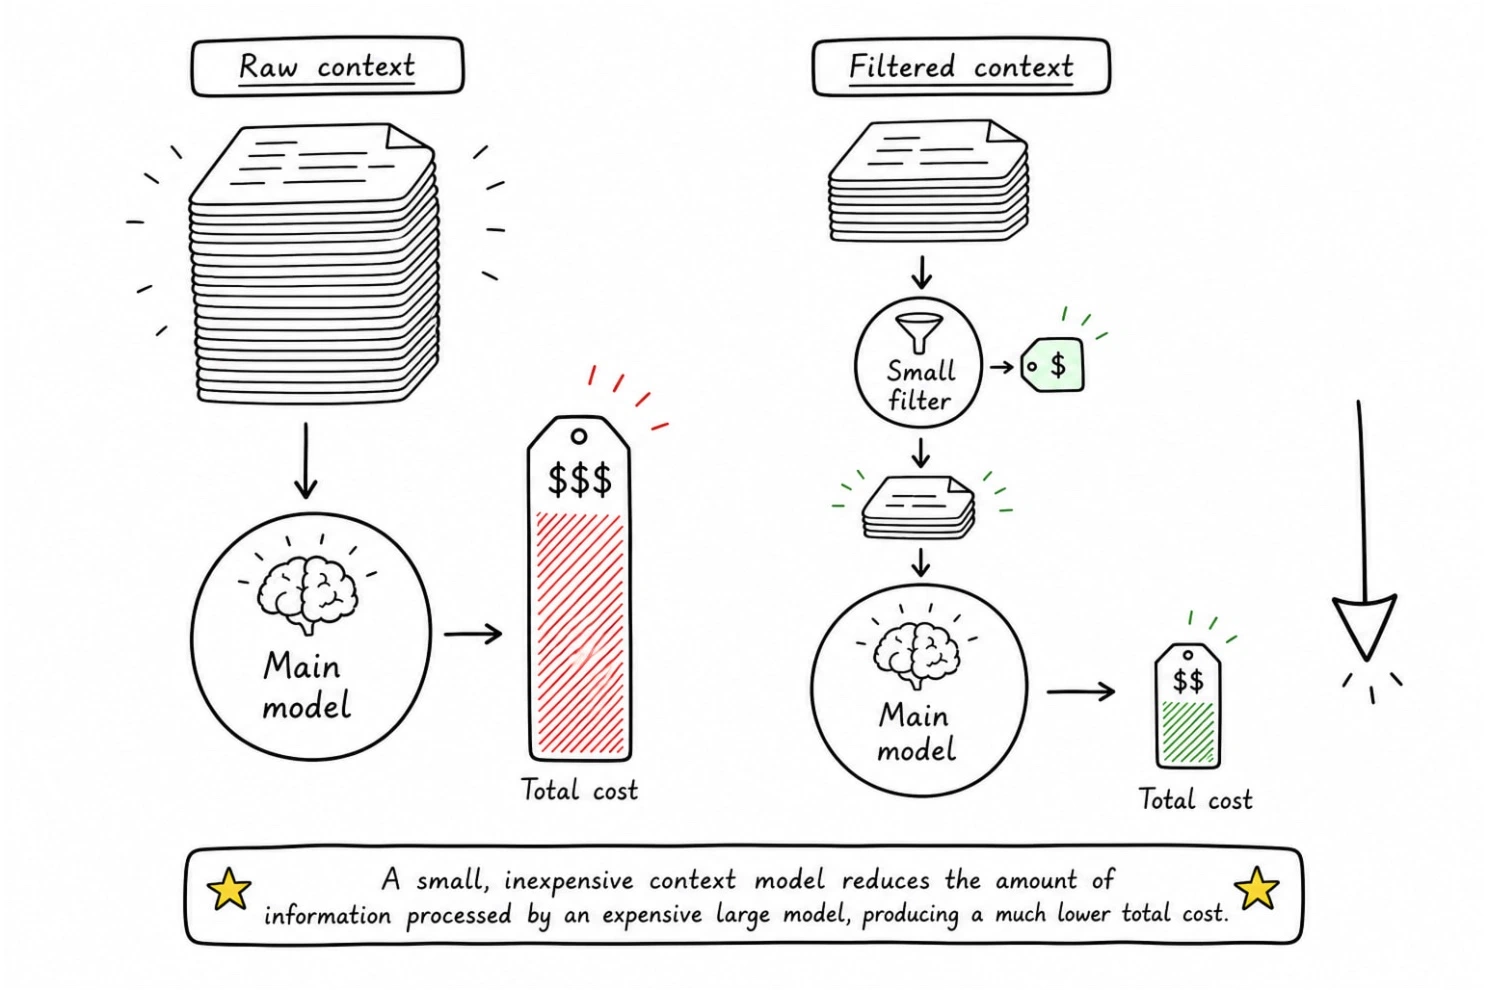
Con los precios estándar de API publicados el 4 July 2026, combinar Gemini 3.1 Flash-Lite ($0.25 de entrada y $1.50 de salida por millón de tokens) con Claude Fable 5 ($10 de entrada y $50 de salida) da estos resultados:
| Sin filtrar | Con filtrado | |
|---|---|---|
| Entrada del modelo grande | 1.45M tokens | 0.56M tokens |
| Coste del modelo grande | $16.50 | $7.60 |
| Coste del modelo de contexto | ninguno | $0.38 |
| Total | $16.50 | $7.98 |
Coste total de una sesión de 20 pasos
El filtrado se amortiza al eliminar 37,750 tokens de entrada de Fable, es decir, un 2.6% de la entrada sin procesar.
El filtro puede fallar
Eliminar contexto puede hacer desaparecer la pista que resuelve la tarea. Un modelo pequeño podría descartar una línea de registro inusual, alterar una restricción del usuario o eliminar un identificador necesario para la siguiente llamada a una herramienta.
Por eso, la arquitectura necesita unas cuantas reglas estrictas:
- mantener accesibles las entradas originales;
- estructurar las decisiones de filtrado y permitir su auditoría;
- no comprimir nunca las instrucciones del usuario ni las restricciones de seguridad;
- incluir la información incierta;
- permitir que el modelo principal solicite las pruebas originales;
- medir el éxito de la tarea, no solo el ahorro de tokens.
Los modelos pequeños deben gestionar el acceso a las pruebas, no convertirse en una fuente de verdad invisible.
El experimento importa más que la estimación
La idea debería probarse frente a tres alternativas: contexto original acumulado, compactación basada en umbrales y filtrado semántico continuo.
Todos los sistemas deberían ejecutar las mismas tareas de programación. La evaluación debería medir el coste total en tokens, la latencia, el aprovechamiento de la caché y el éxito de las tareas. También debería registrar cada caso en que el filtrado elimina pruebas que el modelo principal necesita más adelante.
- 1Un conjunto de tareasEl mismo trabajo de programación para cada sistema
- 2Tres sistemasOriginal, compactación por umbrales y filtrado continuo
- 3Cuatro métricasCoste, latencia, aciertos de caché y éxito
- 4Un veredictoSolo cuenta que sea más barato si sigue funcionando
La arquitectura solo sale ganando si reduce el coste sin mermar la calidad de las tareas completadas. Hasta que se haga una prueba así, la economía es un motivo para experimentar, no una demostración de que el sistema funciona.
Un nuevo papel para los modelos pequeños
El enrutamiento de modelos plantea esta pregunta: ¿qué modelo debería realizar esta tarea?
Esta arquitectura plantea otra: ¿qué merece la atención del mejor modelo?
Enrutamiento de modelosQuién hace el trabajo
- Lee la tarea y elige un modelo
- El modelo barato se encarga de las tareas sencillas
- El contexto es todo lo que se ha acumulado
Modelos pequeños alrededor del grandeSobre qué se trabaja
- El mejor modelo conserva las decisiones difíciles
- Los modelos pequeños eligen lo que lee
- El contexto se selecciona antes de cada paso
Los modelos pequeños podrían convertirse en bibliotecarios del contexto, editores de datos y encargados de mantener la memoria. Prepararían el espacio de trabajo antes de que el modelo principal razone y, después de que actúe, conservarían los resultados útiles.
La idea es especialmente importante para los agentes de programación, porque generan muchísimo material intermedio. También sirve para investigación, atención al cliente y otros procesos prolongados que combinan conversaciones, herramientas y datos externos.
El modelo más capaz no debería leer todas las líneas solo porque el sistema pueda enviárselas.
Cada token debe estar ahí por un motivo.
Fuentes
- Anthropic: edición del contexto
- Anthropic: ingeniería del contexto con memoria, compactación y eliminación de herramientas
- Caveman: comunicación eficiente en tokens para agentes de programación
- Google: Gemini 3.1 Flash-Lite
- Anthropic: precios de la API de Claude
- Model Context Protocol: especificación de herramientas