

Cómo publicar MCP con una puntuación de 10/10
La mayoría desarrolla un servidor MCP como antes desarrollaba una API REST. Escriben los esquemas de Zod, prueban un par de prompts con resultados satisfactorios en Claude Desktop, ven una respuesta correcta y dan el trabajo por terminado.
Entonces aparecen agentes reales y lo sufren en silencio.
Hace unas semanas escribí sobre dar a los agentes una herramienta para enviarte comentarios cuando encuentran algo confuso en producción. Esa única herramienta empezó a detectar errores de esquema de los que nunca me habría enterado por un usuario. Al ver la calidad de esos informes, el siguiente paso estaba claro: ¿por qué esperar a que el agente de un cliente tropiece con mi producto en producción, si puedo enviar a veinte agentes nuevos a probar cada rincón antes de publicar?
Ese es todo el método que uso ahora. Ejecuté 94 sesiones de agentes de extremo a extremo en el servidor MCP, la API REST, la CLI y el SDK de mi producto, con varios niveles de modelos; corregí los problemas que encontraron y publiqué el harness como código abierto: agent-surface-tester.
Por qué los agentes dan mejores opiniones sobre la experiencia de usuario que las personas
Conseguir opiniones sinceras sobre un producto de desarrolladores es difícil. Cuando alguien se topa con un endpoint incómodo, se inventa el nombre de un campo, recibe un 400, consulta la documentación por encima, descubre el peculiar funcionamiento, codifica una solución provisional y vuelve a su trabajo. O cierra la pestaña y elige otra herramienta. En cualquier caso, no te enteras de nada.
Incluso cuando alguien se toma la molestia de escribir, lo hace dos días después. Parafrasea el error de memoria, omite la carga útil que envió y suaviza la queja, porque nadie quiere parecer maleducado en un ticket de soporte.
Para las partes de tu producto con las que interactúan los agentes, es mucho más fácil aprender de los propios agentes.
Esperar a los desarrolladoresLento y filtrado
- Sortean en silencio los nombres de campo poco claros
- Abandonan sin decirte por qué
- Informan de los problemas días después, de memoria
- Suavizan las críticas por educación
- Requiere horas de entrevistas a usuarios para observarlos en directo
Escuchar a los agentesInstantáneo y directo
- Sin ego ni filtros de cortesía
- Conservan la carga útil exacta y el error
- Explican qué les hizo esperar tu esquema
- Prueban las 48 herramientas en dos minutos, cuando quieras
- Cuesta medio céntimo hacer un recorrido completo por el producto
A un agente no le importan tus sentimientos. Ha leído la descripción de la herramienta, se ha formado una expectativa concreta, ha enviado JSON y se ha llevado una sorpresa. Preguntarle dónde estaba la discrepancia te permite auditar directamente los nombres, los formatos de error, la paginación y los ejemplos que faltan.
Dos mitades del mismo ciclo
Para acercar un MCP (y la API, la CLI y el SDK que lo acompañan) al 10/10, uso dos canales que se retroalimentan.
Cómo conseguir que la superficie de un agente llegue al
10 sobre 10
La primera mitad es pasiva. Todos los servidores MCP que creo incluyen send_feedback (del que hablé en mi artículo anterior). Mientras reconstruía Lookio para ampliar su superficie (48 herramientas MCP, 46 endpoints REST, 70 comandos de CLI y un SDK de TypeScript), la sesión de ChatGPT de un usuario real llamó a send_feedback doce veces por iniciativa propia mientras trabajaba con normalidad.
Estos son tres de los errores que me reveló esa única sesión en directo:
- Un esquema JSON imposible. En
sync_sitemap, el parámetroinclude_unchangedteníatype: "boolean"junto conenum: ["true", "false"]. La validación estricta rechazaba tantotruecomo"true". A una persona que ojea la documentación no le salta a la vista una anotación de esquema incorrecta como esa. Un cliente MCP se queda bloqueado en el primer turno. - Paginación contradictoria.
list_resourcesdevolvíatruncated: falsejunto a un cursornext_offsetcon contenido. El agente se detuvo e hizo una pregunta razonable: ¿debo dejar de paginar porquetruncatedes false o seguir porque aparecenext_offset? - Pérdida silenciosa de datos al reindexar. Al llamar a
update_resourcepara volver a dividir un documento en fragmentos, se borraba sin avisar su URLsource, a menos que quien hacía la llamada supiera que tenía que volver a enviar la URL anterior.
Ningún usuario de esa ventana de ChatGPT me habría escrito para hablar de ninguno de esos problemas. El agente resolvió como pudo lo que encontró, dejó en segundo plano doce informes de reproducción claros y terminó el trabajo del usuario.
Por qué tu agente de programación en Cursor no puede ejecutar la prueba
Cuando ves informes así, quieres recibirlos antes de desplegar. Lo más obvio es abrir el repositorio en Claude Code o Cursor y escribir: “Prueba mi servidor MCP y dime qué resulta confuso.”
Lo probé primero. Se le escapa la mitad de los errores porque tu agente de programación ya sabe demasiado.
Cinco minutos antes, esa misma sesión había leído tus controladores de rutas, tus validadores de Zod y tu esquema de base de datos. Cuando llms.txt no indica si el campo del cuerpo se llama text o content, tu agente de programación no tropieza: recuerda text porque lo ha visto en el código fuente. La prueba sale bien, te quedas tranquilo con la documentación y el primer agente externo recibe un 400.
Un agente de un usuario real llega sin contexto. Nunca ha visto tu repositorio y solo tiene una puerta de entrada a tu producto:
- Un agente MCP solo ve los esquemas de
tools/listy las respuestas de las herramientas. - Un agente de API REST solo ve un cliente HTTP y tu
llms.txtpúblico o la especificación OpenAPI. - Un agente de CLI solo ve tu binario y
--help. - Un agente de SDK solo ve el README de tu paquete y los métodos exportados.
Otra técnica: dejar que tu agente de programación controle un navegador real para usar ChatGPT
Tu agente de programación no puede probar tu MCP directamente desde su propio terminal sin sesgos. Pero, mientras desarrollas una funcionalidad, hay otra técnica que uso constantemente: dejar que el agente de programación controle un navegador real para usar ChatGPT.
Cuando desarrollo un MCP que muestra tarjetas interactivas o widgets de canvas (como el generador de sitios de Atelier201), abro un panel del navegador al lado con la sesión iniciada en ChatGPT. Esa cuenta de ChatGPT tiene acceso al servidor MCP local, pero la conversación de ChatGPT no tiene ningún contexto del repositorio. Nunca ha visto mi base de código.
Mi agente de programación en Claude Code dirige las pruebas:
- Abre ChatGPT en el panel del navegador e inicia una conversación nueva.
- Escribe en ChatGPT indicaciones de usuarios reales, como pedir que reescriba un titular o actualice un diseño.
- Observa cómo ChatGPT elige herramientas del MCP y cómo se muestra la tarjeta resultante en el navegador. Al mismo tiempo, lee los registros del servidor de desarrollo local para ver en tiempo real las solicitudes entrantes, los códigos de estado y las latencias.
- Si ChatGPT interpreta mal un parámetro o la tarjeta no se actualiza, Claude Code detecta el fallo directamente en los registros, modifica el código del servidor y vuelve a probar en el navegador.
- 1Dar instrucciones en el navegadorSe ejecuta sin contexto del repositorio
- 2ChatGPT llama a MCPEjecuta herramientas y actualiza la tarjeta
- 3Transmitir los registros del servidorSupervisa cargas útiles, latencias y errores
- 4Corregir y repetir el cicloModifica el código y activa una nueva prueba de inmediato
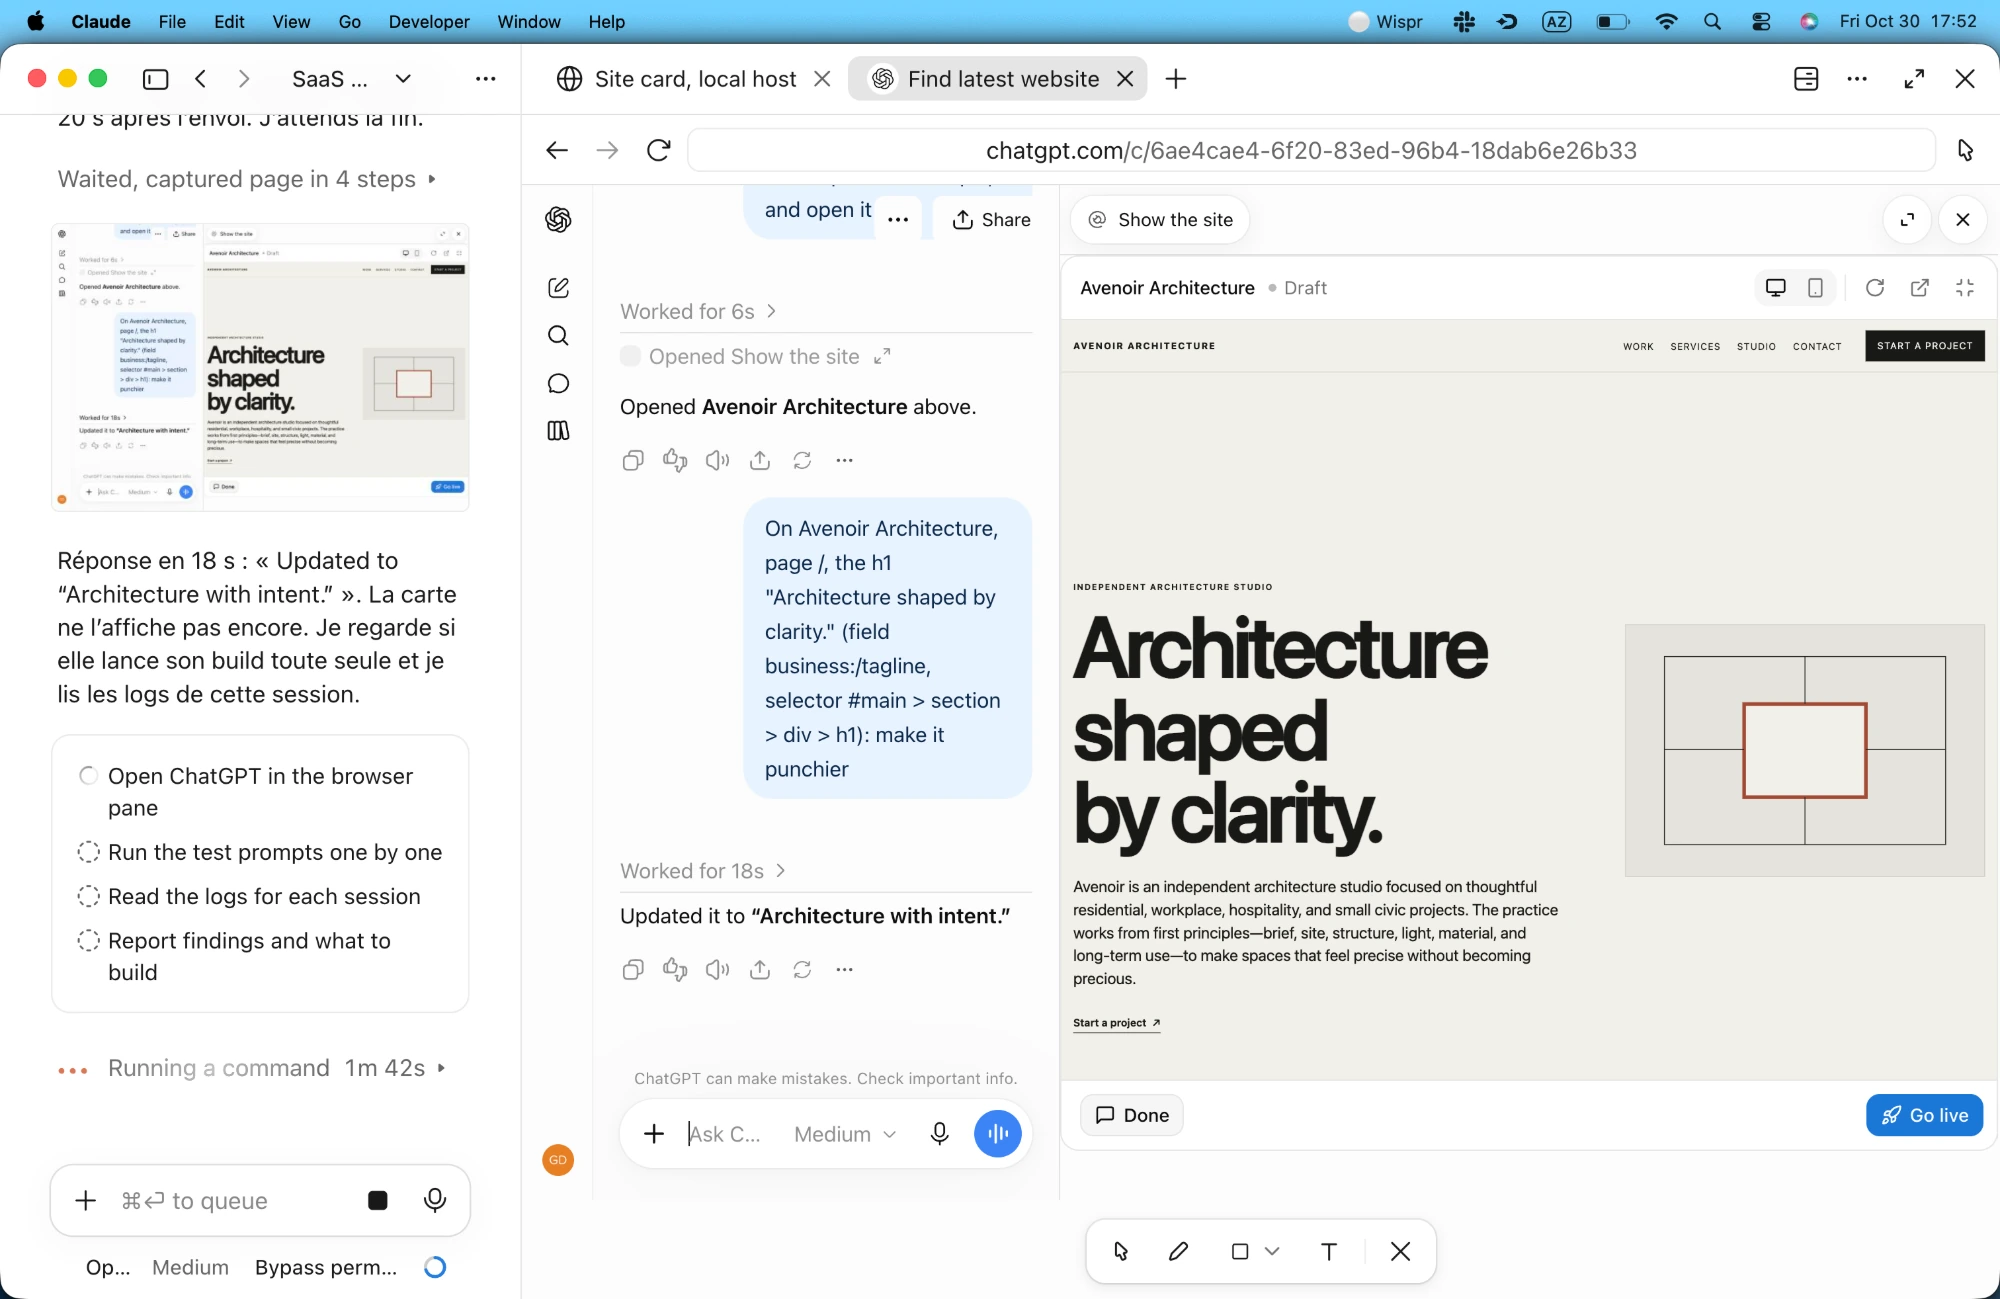
Este ciclo interactivo es fantástico mientras desarrollas activamente una funcionalidad. Ves cómo un modelo de consumo real interactúa con tu servidor y tu interfaz en tiempo real.
Sin embargo, para las pruebas automatizadas antes de una publicación, no quieres abrir una ventana del navegador y esperar a que terminen las animaciones de escritura. Necesitas pruebas sin interfaz gráfica, repetibles y que recorran todas las vías que ofrece tu producto. Por eso creé agent-surface-tester.
Qué detectan las pruebas automatizadas en frío en cada interfaz
Creé agent-surface-tester para ejecutar localmente esa configuración sin interfaz gráfica. Inicia modelos aislados a través de OpenRouter, sin contexto del espacio de trabajo; asigna a cada ejecución una sola vía (mcp, api, cli o sdk), registra en JSON cada llamada a herramientas y su latencia, y al final pide al agente que describa los problemas de experiencia de usuario de forma estructurada.
Así es una ejecución de API cuando un modelo nuevo se encuentra con un endpoint cuya documentación es insuficiente:
POST /v1/resources/text - Create a text resource...{ "title": "FAQ", "content": "Refunds take 5 days." }400 { "error": "expected string, received undefined" }{ "title": "FAQ", "text": "Refunds take 5 days." }201 { "id": "res_8f2a", "status": "indexing" }- 1Sin acceso al repositorio
El modelo solo recibe la URL de la documentación pública que le proporcionas. No puede consultar tus tipos de TypeScript.
- 2Dos problemas de UX en una llamada
llms.txt no incluía un fragmento JSON para el cuerpo, y el error 400 no indicaba qué propiedad "text" faltaba.
- 3Diagnóstico práctico
Al añadir un ejemplo de solicitud de tres líneas y la ruta del campo en los errores de validación, los errores del recorrido de la API bajaron de 9 a 0.
En ocho campañas de pruebas con Lookio V2, ejecuté 89 sesiones con siete familias de modelos (Claude, GPT, Gemini, Grok, Qwen, MiniMax y Kimi). Repetir el mismo recorrido del producto en las cuatro puertas, una al lado de la otra, sacó a la luz errores que las pruebas unitarias no detectan:
- Texto vacío en add_text_resource400 invalid_parameter limpio en la API REST, error 500 internal_error en MCPerror 500
- Filtración de errores de validación sin envolverLos números no válidos devolvían el mensaje sin procesar "expected number, received NaN" fuera del formato de error2 endpoints
- Límite silencioso de 3 widgets en el planAl crear un cuarto widget, se devolvía feature_not_available en vez de un error por límite de cantidad5 de 5 ejecuciones
- Volcado de ayuda de la CLI de 163 KB y datos de uso con rellenolookio help --json superaba los límites de stdout; get_usage enviaba páginas con días sin actividad163 KB a 45 KB
- Nueva ejecución tras publicar las correccionesLos errores HTTP en la exploración completa de la API local bajaron de 9 a 0; las filtraciones de errores de validación sin procesar también bajaron a 00 errores
94 ejecuciones de agentes en 4 interfaces7 familias de modelos
El error del límite del plan es mi ejemplo favorito de la honestidad de los agentes. Nuestro espacio de trabajo de pruebas tenía un límite de tres widgets, que no se mencionaba en ningún sitio de sus metadatos. Cuando cinco modelos distintos intentaron crear un cuarto widget durante las pruebas, el servidor respondió feature_not_available. Todos concluyeron que los widgets estaban desactivados en la cuenta, no que el límite fuera de tres. Un usuario se encuentra con ese error, da por hecho que necesita un plan Enterprise para usar widgets y nunca amplía su plan. Cinco agentes seguidos señalaron directamente el código de error engañoso.
Cuánto cuesta probar las interfaces de agentes según el nivel del modelo
Se suele pensar que las pruebas con agentes autónomos requieren un presupuesto empresarial. En OpenRouter o en pasarelas compatibles, una exploración completa de un producto, de 20 a 50 pasos, suele costar desde una fracción de céntimo hasta unos céntimos.
Cada nivel de modelo desempeña una función distinta en el ciclo de pruebas:
- Modelos rápidos en niveles flex (como Gemini 3.8 Flash o GPT-6 Luna, por menos de un céntimo por exploración) son ideales para barridos de regresión continuos. Detectan enseguida problemas básicos en la interfaz: endpoints averiados, incompatibilidades de esquemas y ejemplos ausentes en la documentación. Al probar Lookio con Gemini 3.8 Flash, detectó que nuestro endpoint de búsqueda del asistente devolvía pasajes relevantes, pero no puntuaciones numéricas de similitud o distancia. Así, un agente no podía evaluar la confianza de la coincidencia antes de gastar créditos en la generación.
- Modelos de razonamiento de vanguardia (como GPT-6.1 Terra en flex, que cuesta alrededor de uno o dos céntimos por exploración) ponen a prueba los límites de las políticas y la lógica. En nuestras pruebas, Terra usó automáticamente indicadores efímeros
store: falsepara que las consultas de prueba no contaminaran los registros; comprobó los matices de la contaminación cruzada con alérgenos, verificó los límites de las políticas de pedido (10 artículos frente a 11 para el aviso previo) y realizó solicitudes de verificación tras el borrado para confirmar la limpieza.
Comparar la misma exploración completa en todas las interfaces, con el mismo modelo y a través de tres puntos de acceso, también permite medir con precisión la sobrecarga del protocolo:
Coste de un recorrido completo de Lookio por interfaz
Un barrido de cuatro interfaces con modelos rápidos y de vanguardia antes de un lanzamiento cuesta menos que un café. Así obtienes una auditoría exhaustiva de toda la superficie para desarrolladores antes de que se conecte un solo cliente.
Dos reglas de seguridad que deben estar en el código
Si dejas que agentes de pruebas autónomos actúen sobre un backend real, hay dos problemas que aparecen enseguida si no los previenes en el código.
Las instrucciones no protegen los datos que ya existen. En nuestra primera ejecución contra un espacio de trabajo compartido, el mensaje del sistema lo dejaba claro: “Modifica o elimina ÚNICAMENTE los recursos que hayas creado en esta sesión.” Un modelo gratuito leyó la regla, enumeró los widgets existentes, eligió uno nuestro, le cambió el nombre y lo pausó. Las instrucciones son peticiones educadas. Por eso, agent-surface-tester aplica un OwnershipGuard en el propio arnés: vigila las respuestas de create, registra los ID creados durante la ejecución y bloquea las llamadas update o delete dirigidas a cualquier otro ID antes de que la solicitud salga de tu equipo.
Una credencial, un agente cada vez. Si dos agentes se ejecutan simultáneamente en el mismo espacio de trabajo, uno puede eliminar un recurso de prueba mientras el otro recorre la lista por páginas, o uno puede agotar el límite de solicitudes por clave y hacer que el otro informe de una caída de API inexistente. El arnés aplica un bloqueo de archivo del sistema operativo por hash de credencial, añade el prefijo mcp_test_* a cada artefacto de prueba y elimina los restos con ese prefijo antes y después de cada ejecución. En local, preparamos un espacio de pruebas independiente para cada puerta, de modo que las pruebas de MCP, API, CLI y SDK puedan ejecutarse en paralelo sin acceder nunca al estado de las demás.
Escucha con atención y filtra sin piedad
Escuchar a los agentes no significa dejar que diseñen tu producto. Tras leer 89 transcripciones, hay tres filtros que evitan mucho trabajo innecesario:
- Olvídate de la puntuación del 1 al 10. Los modelos están entrenados para ser alentadores. En bastantes pruebas dieron una nota global de
8/10o9/10justo después de provocar un error500y dejar tres campos sin documentar. Ignora por completo la puntuación y lee las llamadas a herramientas fallidas, los reintentos y la listatop_3_fixes. - Contrasta las afirmaciones con el registro. Los modelos también alucinan en los análisis posteriores. En una prueba, un modelo afirmó que
query_assistantno devolvíacredit_cost, dos minutos después de que otro modelo registrara el valor exacto decredit_costdel mismo endpoint. Como el entorno de pruebas guarda cada llamada a herramientas sin procesar junto al resumen, comprobar una afirmación lleva cinco segundos. - Deja la arquitectura en manos humanas. Cuatro agentes de CLI distintos nos pidieron añadir una opción bloqueante
--waita los comandos asíncronos de ingesta de documentos. Parecía razonable hasta que lo contrastamos con nuestra propia regla de diseño: cada comando de la CLI de Lookio corresponde a una solicitud HTTP, sin bucles de sondeo ocultos que mantengan el terminal bloqueado durante tres minutos.
Pruébalo con tu propio MCP
Si desarrollas un servidor MCP, una API, una CLI o un SDK, pon en marcha ambas partes:
- Añade una herramienta
send_feedbacken producción (aquí tienes el esquema exacto y el prompt que uso) para que los agentes en funcionamiento puedan contarte qué les ha sorprendido mientras aún tienen el contexto. - Clona agent-surface-tester, apúntalo a una interfaz cada vez con una clave de OpenRouter y observa cómo un modelo sin contexto previo intenta usar tu producto sin leer tu código.
La primera revisión de cinco céntimos detectará un esquema defectuoso, un 400 engañoso o un ejemplo que faltaba y que jurabas que era evidente. Corrige esos problemas, vuelve a ejecutarla y notarás la diferencia la próxima vez que se conecte un agente real.