

Ofrece a los agentes una herramienta para enviarte feedback
Si lanzas un servidor MCP, la mayoría de las personas que lo usan no son personas. Un agente lee las descripciones de tus herramientas, elige una, envía un payload, recibe un resultado y decide qué hacer a continuación. Todo ese ciclo ocurre sin que nadie lo observe.
Por eso, cuando algo sale mal ahí dentro, nadie te avisa. El agente reintenta, busca una solución alternativa o se rinde y le dice al usuario que la tarea no puede realizarse. Tú no ves nada de esto.
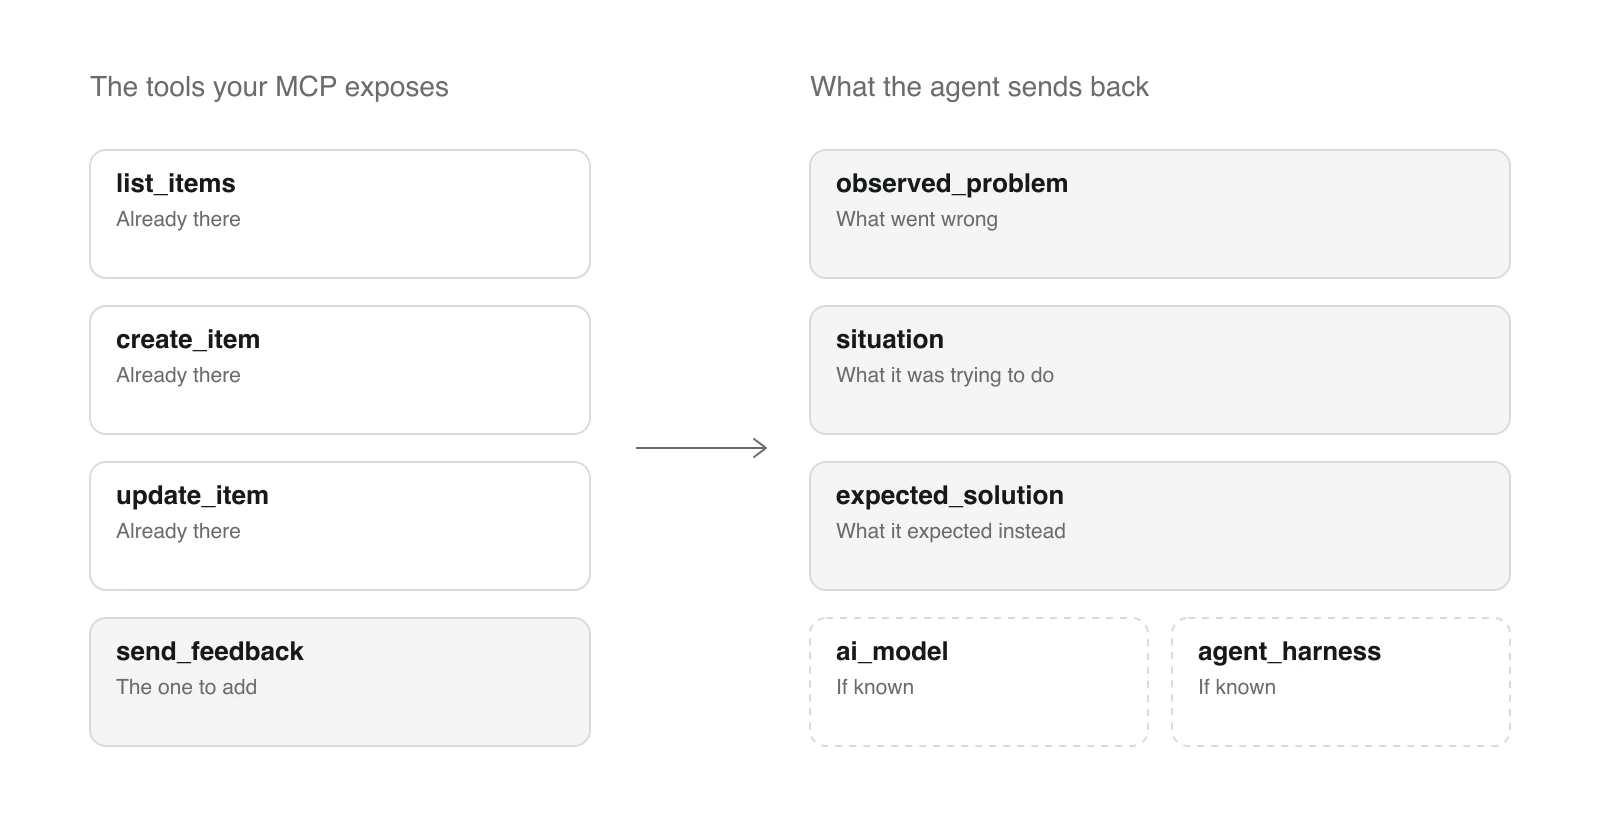
La solución es sencilla: añade una herramienta más a tu MCP y deja que el agente te reporte el problema.
Una herramienta y una descripción que indique cuándo usarla
La herramienta no afecta al producto. Recibe una descripción de lo que salió mal y te la reenvía. Lo que hace que funcione es la descripción que lee el agente, porque esa es la única instrucción que recibe.
Aquí tienes la que utilizo en AI Glot:
Utiliza esta herramienta mientras uses AI Glot cuando una herramienta, respuesta, error o
flujo de trabajo de AI Glot se comporte de manera diferente a la esperada, o cuando desees
que algo funcione de otra forma. Llámala una vez que el problema esté claro. Describe la
situación, lo que observaste y lo que debería haber ocurrido. Si lo conoces, incluye la
herramienta relacionada, la operación de la API o el comando de la CLI, el modelo de IA
y el entorno del agente. No incluyas claves de API, tokens, URLs firmadas o el contenido
completo de archivos. Esta herramienta solo registra comentarios, no reintenta ni
cambia tu traducción, y no consume créditos.
Tres puntos de ese texto hacen el trabajo real. “Una vez que el problema esté claro” evita que se active ante el primer error transitorio. “No reintenta” evita que el agente recurra a ella como paso de recuperación cuando falla una llamada. “No consume créditos” es fundamental porque los agentes son cautelosos con cualquier cosa que pueda gastar dinero del usuario, y una herramienta sobre la que no están seguros es una herramienta que no llaman.
- 1El agente encuentra un problemaUn rechazo, una sorpresa, una herramienta faltante
- 2Llama a la herramienta de feedbackAún manteniendo todo el contexto
- 3Tu servidor añade lo que sabeEspacio de trabajo, superficie, marca de tiempo
- 4Llega a donde tú quierasUn webhook, y entonces tienes tu problema
Los campos
Aquí es donde reside la mayor parte del valor. Un cuadro de texto abierto te devuelve un “no funcionó”. Los campos nombrados te dan algo sobre lo que puedes actuar.
Esto es lo que pide la herramienta de AI Glot, con los tres campos obligatorios primero:
expected_solution es el campo que mantendría si solo pudiera tener uno. Un usuario te dice que algo está roto. Un agente te dice lo que creía que la llamada iba a hacer, lo cual es una lectura directa de si la descripción de tu herramienta coincide con la herramienta misma.
Los tres opcionales existen porque “no adivinar” es una instrucción real que un agente seguirá. Prefiero que el campo esté vacío a que esté lleno con un nombre de modelo plausible. Cuando están rellenos, puedes ordenar por modelo y por entorno, y un problema que solo ocurre en uno de ellos deja de parecer aleatorio.
Cómo es uno real
Este es un ejemplo real, exactamente como me llegó el 10 de septiembre:
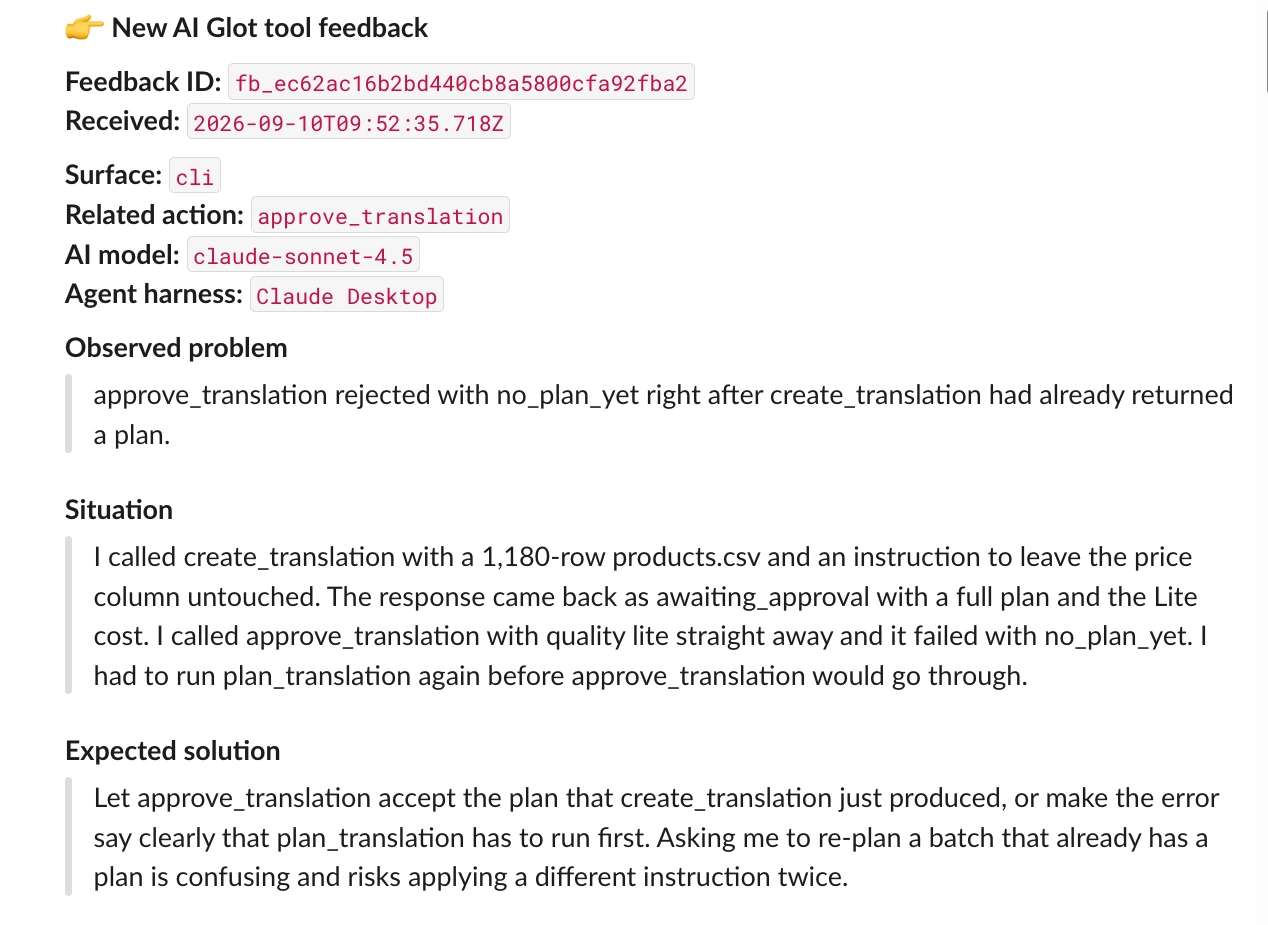
Eso es un reporte de error con reproducción, diagnóstico y propuesta de corrección, escrito por la entidad que lo sufrió, segundos después de que ocurriera. No lo pedí y no pagué por ello.
Por qué es mejor que el feedback que recibes habitualmente
No digo que los agentes sustituyan a los usuarios. Digo que este canal en particular tiene propiedades que el feedback de los usuarios no tiene.
Un usuario te cuentaHoras o días después
- Recordado y parcialmente reconstruido
- Filtrado según lo que creen que merece ser reportado
- Suavizado, porque quejarse parece grosero
- Rara vez dice qué esperaba en su lugar
- Solo de los pocos que se toman la molestia
El agente te cuentaSegundos después
- Escrito mientras todo el contexto sigue cargado
- Sin juicios sobre si esto merece tu tiempo
- Indica qué esperaba, porque ese es el campo
- Nombra la llamada, el modelo y el entorno exactos
- De cada ejecución que encuentra el problema
La parte imparcial es a lo que siempre vuelvo. Un agente no tiene una relación contigo que proteger ni le preocupa parecer exigente. Leyó tu descripción, formó una expectativa y la expectativa no coincidió. Esa brecha es el reporte completo, y es la revisión de documentación más honesta que jamás tendrás.
A dónde van los reportes
Los míos hacen un POST a un webhook y llegan a un canal que leo. Esa es toda la configuración, y fue suficiente para que valiera la pena.
Puedes ir más allá, y las opciones se vuelven interesantes una vez que los reportes están estructurados:
- Almacénalos y agrúpalos por
related_action. Tres reportes sobre la misma herramienta es una especificación, no una anécdota. - Recibe notificaciones de los que importan, filtrados por lo que te interese: una herramienta, un modelo, un entorno.
- Pon un agente en la cola para eliminar duplicados, priorizar y redactar una propuesta de corrección contra tu repo. Los reportes ya contienen una reproducción y un comportamiento esperado, que es la mayor parte de lo que necesita una corrección.
- Ejecútalo en piloto automático, si confías lo suficiente en tus pruebas para ello. Yo aún no.
Nada de esto es obligatorio. Solo el webhook ya cambia lo que sabes sobre tu propio producto.
Dos reglas que yo no omitiría
Nunca debe romper la conversación que lo llamó. Si tu webhook está caído, la herramienta devuelve un simple “esto no pudo entregarse, no hay nada más que hacer”, no un error. Un agente que recibe una excepción de una herramienta de feedback empezará a tratar el fallo como parte de la tarea que estaba realizando. La mía también tiene un tiempo de espera corto por la misma razón: un webhook colgado mantiene abierto el turno del agente.
Di qué no debe enviar. Los agentes son serviciales, y una solicitud de contexto podría traerte claves de API, URLs firmadas y contenidos de archivos. Nombrarlos en la descripción es suficiente, y significa que no almacenas cosas que nunca quisiste.
Pruébalo en tu propio MCP
Si ya lanzas un servidor MCP, esto es una herramienta, un webhook y una descripción que reescribirás dos veces. El primer reporte que llegue te dirá algo sobre tu producto que no sabías, y será sobre una herramienta que creías que estaba bien.
Los agentes son tus usuarios ahora. Dales un lugar donde quejarse.