

La mayoría de los agentes de IA no deberían ser agentes
Cuando llegaron los agentes a n8n, creé un montón. Añades un nodo de agente, le conectas tres herramientas y él decide cuál usar. Parecía que, de repente, todo se había vuelto fácil.
En los meses siguientes fui eliminando la mayoría. En los flujos que tenían que escalar y funcionar de verdad en producción, ahora uso alrededor de una quinta parte de los agentes que tenía.
No porque los agentes sean malos. En la mayoría de mis casos, el agente decidía en tiempo de ejecución cosas que yo ya sabía al diseñar el flujo, y me cobraba por ello en cada turno.
El flujo que pongo en cuestión
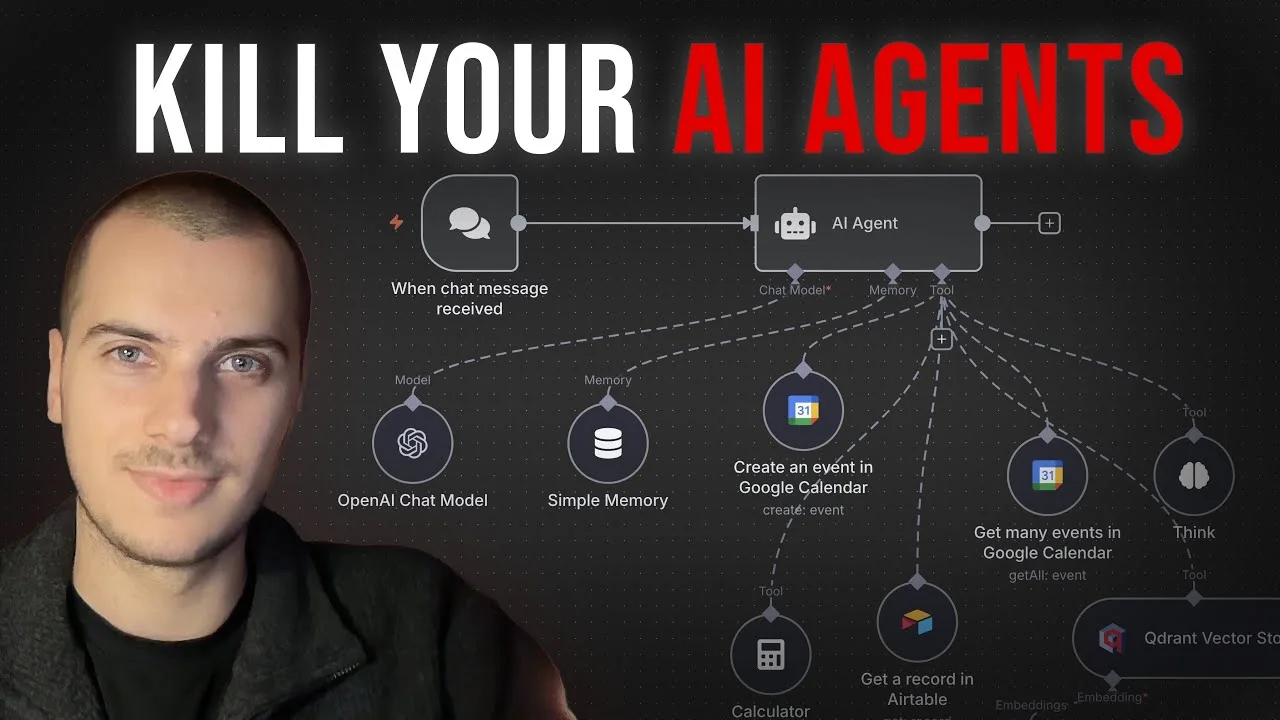
Un chatbot de soporte. Un activador de chat, un agente con un modelo grande y una herramienta: una solicitud HTTP a un endpoint de recuperación que responde preguntas sobre mis documentos. Alguien pregunta por el producto, el agente llama a la herramienta, lee el resultado y redacta la respuesta.
Agente de conocimiento con IA
- Al recibir un mensaje de chat
- Agente de conocimiento con IAgpt-4.1Modelo de chatModelo de chat de OpenAIgpt-4.1MemoriaMemoria simpleHerramientaConsultar la base de conocimientosSolicitud HTTP. El agente redacta la consulta y decide cuándo llamarla
Alguien dice hola y te cuesta un modelo de vanguardia
Escribe «hola» a ese agente. En aproximadamente 1,3 segundos recibes una respuesta amable, redactada por uno de los modelos más grandes disponibles.
No se llamó a ninguna herramienta. No se recuperó nada. Se enviaron como tokens de entrada todas las instrucciones del sistema, incluidas las líneas que describían herramientas que ni siquiera se usaron.
- Llega el mensaje"hola"1 token
- Se envían todas las instrucciones del sistemaTodas las descripciones de las herramientas y todas las reglas sobre cuándo usar cada unatodo
- El modelo grande decideDecide no llamar a nada
- El modelo grande responde«Hola, ¿en qué puedo ayudarte hoy?»
El saludo es el caso más fácil de ver, pero no es excepcional. En un chatbot, muchos mensajes no requieren recuperar ni consultar nada.
Lo mismo, pero desarrollado por escrito
Esta es la alternativa. Tiene más nodos, y cada uno refleja una decisión que tomé una sola vez, en lugar de dejar que un modelo la tome en cada mensaje.
Chatbot RAG inteligente y eficiente
- Al recibir un mensaje de chat
- Buscar mensajes anterioresGestor de memoria, modo de cargaMemoriaMemoria simple
- Enrutador de intenciónClasificador de texto, dos categoríasModelo de chatModelo muy pequeñogpt-4.1-nano
no hace falta recuperar información
- Respuesta sencillaCadena LLM básica con el mismo modelo diminuto
hace falta recuperar información
- Preparar la consulta de recuperaciónCadena LLM básica, gpt-4.1-mini
- RAG a través de LookioSolicitud HTTP sencilla. En este paso no interviene ningún modelo
- Redactar la respuesta finalCadena LLM básica, gpt-4.1. El único modelo grande del flujo
- Responder al chat
- Guardar mensajesGestor de memoria, modo de inserción
Enrutar primero con un modelo que no cuesta nada
El único cometido del clasificador de texto es decidir qué ruta debe seguir el mensaje. Hay dos categorías, cada una con una descripción:
- No hace falta recuperar información. Saludos, confirmaciones y charla informal. Cualquier cosa que pueda responderse sin consultar nada.
- Hace falta recuperar información. El mensaje requiere información de los documentos para poder responderse.
La clasificación es una tarea sencilla y los modelos pequeños la hacen muy bien. Es tan rápida que apenas influye en la latencia total, y tan barata que dejé de preocuparme por el coste.
La ruta barata usa una cadena LLM básica con ese mismo modelo diminuto y una instrucción de sistema breve. Ahora, un «Hola» recibe respuesta en unos dos segundos, con el mismo resultado, pero usando un modelo cuyo coste por token es una fracción del anterior.
Un mismo nodo de modelo alimenta tanto el enrutador como la respuesta sencilla. Son tareas distintas, pero de una complejidad similar. Además, tener un único lugar donde cambiar el modelo hace que pruebe otro de vez en cuando, en vez de editar dos nodos y olvidarme del segundo.
Aplico el mismo enfoque a la barra lateral del chat: generar títulos de conversación de forma programada con un modelo pequeño en lugar de generar un título con cada mensaje.
Configura el activador para responder desde un nodo
Un pequeño detalle que puede echar por tierra todo el diseño si se pasa por alto. De forma predeterminada, un activador de chat responde desde el último nodo, pero este flujo tiene dos rutas y ambas deben responder.
Configura el modo de respuesta del activador para que responda desde un nodo y coloca un nodo Responder al chat donde converjan las ramas. Sin él, no hay forma de tener una ruta barata y otra cara que respondan ambas, y ese es precisamente el objetivo del enrutamiento.
La ruta de recuperación, en tres nodos
Fíjate en lo que hizo el agente ante una pregunta real. Se llamó al modelo grande, tardó 600ms y decidió llamar a la herramienta. Buena decisión. Pero lo único que produjo con toda esa inteligencia fue una consulta breve, más o menos una versión depurada de lo que acababa de escribir el usuario. Y, para redactarla, volvió a procesarse toda la instrucción de sistema.
Tareas del turnoTodas con el modelo grande
- Decidir si hace falta recuperar información
- Redactar una consulta breve
- Redactar la respuesta final con la información obtenida
Qué necesita cada tareaSi eliges el modelo para cada paso
- Un clasificador, modelo diminuto
- Una reformulación, modelo pequeño
- Un modelo grande, que aquí sí se justifica
Así que la ruta consta de tres nodos, no de un agente.
Preparar la consulta de recuperación es una cadena LLM básica con un modelo mini. La instrucción de sistema dice: a partir del mensaje del usuario, formula una consulta breve y concisa para la herramienta de recuperación de información y devuélvela directamente como pregunta. En mis pruebas, el modelo pequeño redactó la misma consulta que el grande.
RAG a través de Lookio es una solicitud HTTP sencilla. La consulta va en el cuerpo; el ID del asistente y el modo son valores fijos que elegí yo, no parámetros que un modelo pueda alterar. La mayoría de las herramientas que se conectan a un agente son API por debajo y la plataforma suele ofrecer el nodo listo para copiar y pegar.
Write the final response recibe el mensaje original y el contenido recuperado, ambos etiquetados, y redacta la respuesta. Este paso se mantiene en el modelo grande, porque la calidad se nota sobre todo en cómo está formulada la respuesta final.
Ahora te encargas tú de la memoria
Esta es la parte de la que se ocupaba el agente por ti, y que ahora tienes que volver a incorporar.
Un nodo de agente incluye un subnodo de memoria que se encarga de gestionarla. Si divides el agente en pasos, ninguno lo hace, así que la conversación se carga una vez al principio y se guarda una vez al final.
- Buscar mensajes anterioresGestor de memoria en modo de carga, justo después del activadoruna vez
- Cada prompt la añadeEl enrutador, la respuesta sencilla y los dos pasos de recuperación reciben el historial×4
- Responder en el chatLa respuesta vuelve al usuario
- Guardar los mensajesGestor de memoria en modo de inserción: el mensaje del usuario y la respuestauna vez
Da más trabajo. Pero también es cuando te das cuenta de que el agente enviaba toda la conversación en cada turno y de que un paso de reescritura de consultas necesita los dos últimos mensajes, no los veinte últimos.
Qué recuperas
AgenteDecide en tiempo de ejecución
- Modelo grande en cada turno, haya saludo o no
- Prompt del sistema y descripciones de herramientas en cada llamada
- Puede saltarse una herramienta y responder de memoria
- Puede cambiar el orden y te enteras cuando ya está en producción
Pasos explícitosDecididos al diseñar el flujo
- Modelo grande en uno de cinco nodos
- Sin descripciones de herramientas
- La recuperación siempre se ejecuta, porque es un paso
- El orden es el que has dibujado
La tercera línea es la que más me importa. Que un agente se salte una herramienta y responda con lo que sabe en ese momento es un fallo que no puedes reproducir ni detectar con pruebas. Un flujo de trabajo no puede hacerlo. El nodo está ahí y se ejecuta.
Cuándo sigo recurriendo a un agente
Cuando de verdad desconozco el orden. En una investigación abierta, por ejemplo, en la que la segunda consulta depende de lo que encuentre la primera. O cuando no se puede saber de antemano cuántos pasos habrá.
Ahora aplico esta prueba: ¿puedo dibujarlo en papel antes de ejecutarlo? Si puedo, usar un agente es pagarle a un modelo para que vuelva a descubrir mi esquema en cada solicitud.
La misma pregunta, un nivel más arriba
Este es el hábito que se traslada a otros casos. Cuando trabajo con Claude Code o Codex, muchas de las tareas tienen la misma estructura que ese bot de soporte, y las partes costosas también son las mismas: volver a enviar todo el contexto para un paso que solo necesitaba una fracción, o que el modelo vuelva a descubrir algo que yo ya sabía.
Saber cuánto cuesta una llamada a una herramienta, porque una vez la conectaste a mano y viste cuántos tokens consumía, te permite detectar lo que ocurre dentro de un entorno que apenas te muestra nada.
Abre tus propios agentes y revisa las ejecuciones. En cada una, pregúntate si podrías haber dibujado los pasos antes de ejecutarla. En la mayoría de las mías, sí.