

Mapeo de importación de CSV con una sola llamada al modelo (Jev)
- La pregunta
- ¿Qué parte de un mapeo de columnas de CSV puede resolverse mediante código y puede una sola llamada al modelo gestionar todo lo restante?
- El resultado
- El emparejamiento estricto resuelve hasta 7 de cada 10 columnas gratis, y una llamada puntúa cada par restante en menos de 700 ms por una décima de centavo.
Qué quería averiguar
Cualquier producto que importe un CSV tiene esta pantalla. El usuario sube un archivo y algo tiene que decidir que su Lineitem sku es tu sku.
Ya se podía hacer esto con un LLM pequeño y funcionaba razonablemente bien. Lo que obtenías era una cadena de texto en la que tenías que confiar, tras una espera perceptible para el usuario. Quería saber si el mismo trabajo podía dividirse en tres vías: dejar que el código simple resolviera todo lo que puede resolver correctamente, consultar al modelo una sola vez por todo lo demás simultáneamente y, después, devolver la decisión al código, donde puedo verla y cambiarla.
Jev hace que la parte central sea económica. No escribe texto, responde a preguntas que mi código define y devuelve una probabilidad para cada una. Por lo tanto, la pregunta no es realmente si un modelo puede mapear columnas, sino cuánta parte del trabajo no necesita el modelo en absoluto y si una sola llamada puede cubrir lo que queda.
Cómo se probó
Tres tablas de destino, diez columnas cada una, y nueve CSV de muestra elegidos por sus casos complicados más que por los fáciles: una exportación limpia de HubSpot, un archivo totalmente en francés con dos columnas de email distintas, una exportación de Shopify donde Name es el número de pedido, y una exportación de almacén con 23 columnas de las cuales 13 no pertenecen a ninguna parte.
Cada columna de destino lleva una descripción de una línea, y esa descripción no es decorativa. Es lo que separa dos campos contiguos.
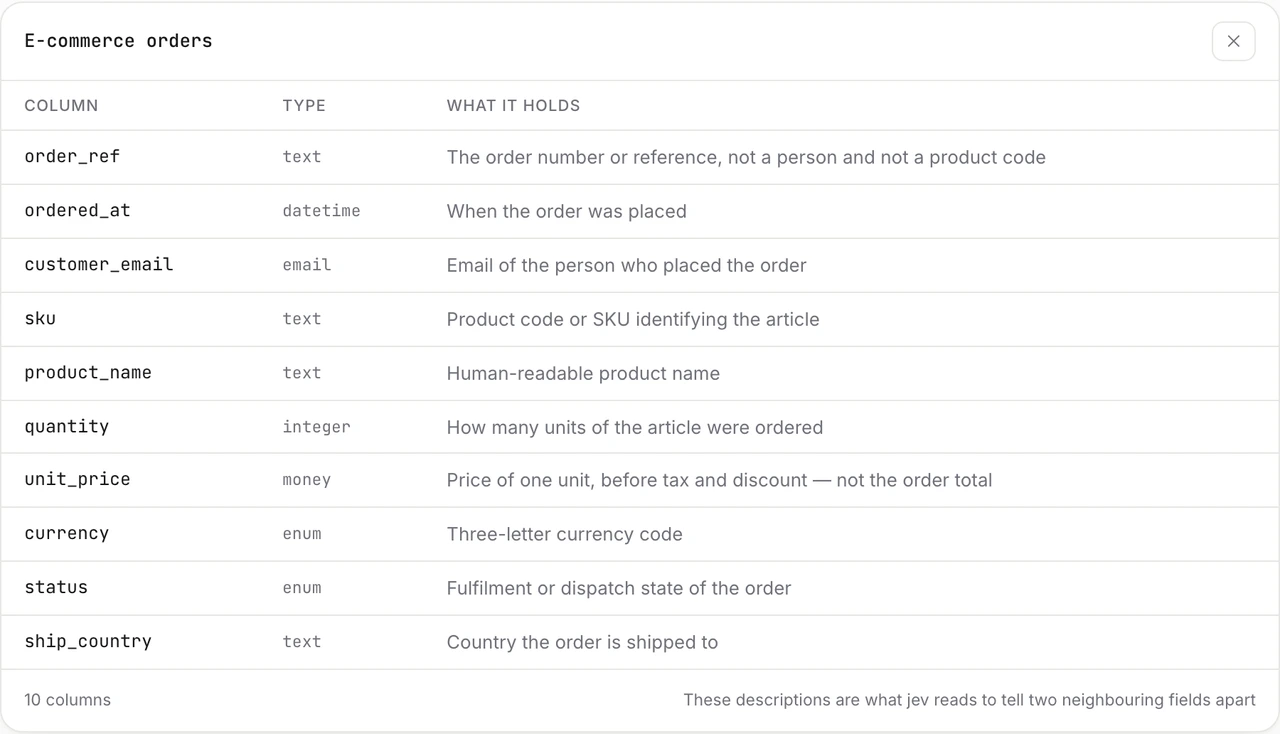
La ejecución consta de tres etapas, y solo la central es un modelo.
Etapa 1 · en código, gratis e instantánea
Etapa 2 · una llamada, todos los pares restantes a la vez
Etapa 3 · de nuevo en código
La estructura de las preguntas es la única decisión de diseño que merece debate. Hacer una sola pregunta de opción múltiple por columna entrante sería el movimiento obvio, y es el incorrecto.
Una opción por columna entranteLa estructura obvia
- Tiene que elegir uno de los destinos, siempre
- Cuando nada encaja, sigue nombrando algo, alrededor de 0,85
- Nada en la respuesta dice "ninguno de estos"
Un sí/no por par, más un guardiánLo que se construyó
- Cada par obtiene su propio número, independiente de los demás
- Una columna puede puntuar bajo en todas partes, que es la apariencia de "no está en esta tabla"
- El guardián pregunta directamente si no pertenece a ninguna parte
Los resultados
Los nueve archivos se procesaron en una sola llamada.
| Archivo | Columnas | Definido en código | Preguntas | Tiempo Jev | Coste |
|---|---|---|---|---|---|
crm-hubspot-export.csv | 10 | 7 | 12 | 464 ms | $0.000077 |
hr-bamboo.csv | 8 | 5 | 18 | 374 ms | $0.000109 |
orders-minimal.csv | 5 | 0 | 55 | 409 ms | $0.000287 |
hr-payroll.csv | 10 | 2 | 72 | 484 ms | $0.000362 |
crm-eventbrite.csv | 7 | 0 | 77 | 514 ms | $0.000395 |
orders-shopify.csv | 10 | 1 | 90 | 437 ms | $0.000462 |
crm-french-crm.csv | 10 | 0 | 110 | 495 ms | $0.000549 |
hr-identity-provider.csv | 12 | 0 | 132 | 474 ms | $0.000658 |
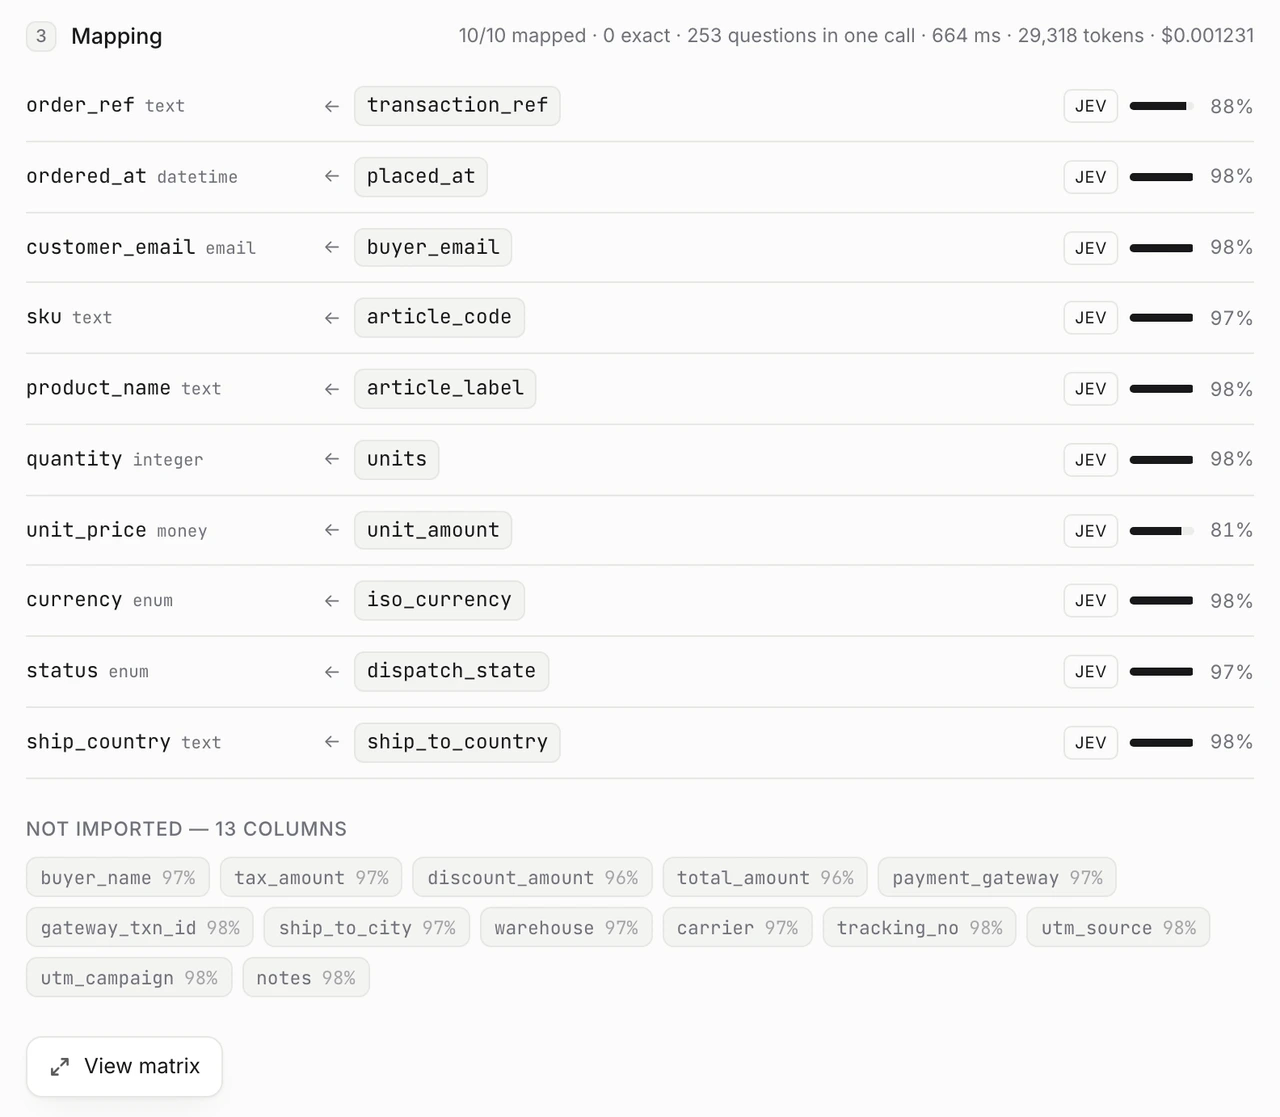
orders-warehouse-export.csv | 23 | 0 | 253 | 675 ms | $0.001231 |
Veintiuna veces el coste de las preguntas es 1,45 veces la espera. Doce preguntas tardan 464 ms y 253 tardan 675 ms. Esa es la propiedad sobre la que descansa todo el diseño: si cada pregunta fuera una llamada propia, el archivo del almacén supondría una espera de dos minutos en lugar de dos tercios de segundo, y la matriz sería inutilizable.
En la exportación de HubSpot, 7 de las 10 columnas ni siquiera llegan al modelo. Esa parte es gratuita, instantánea y no puede fallar.
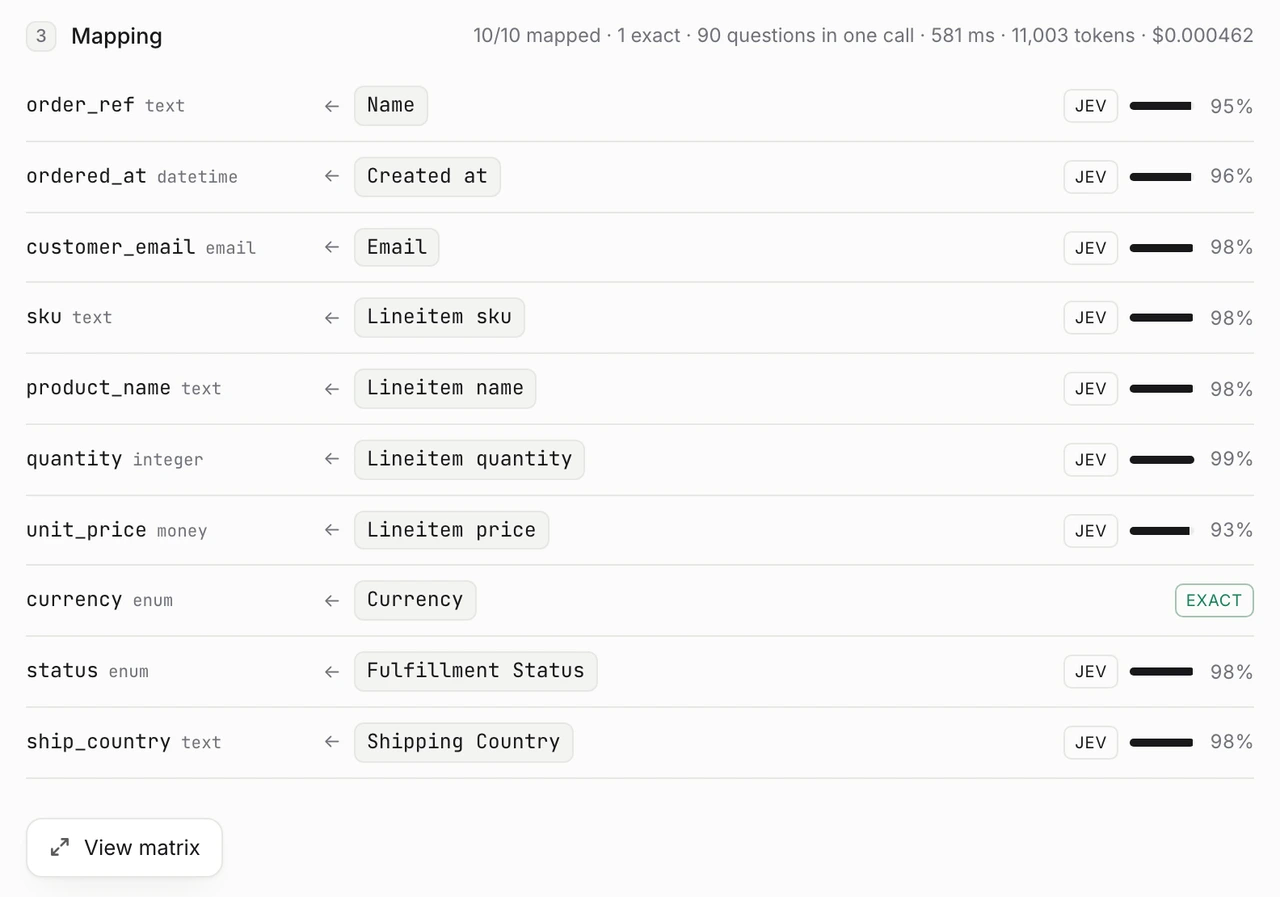
Los valores de muestra hacen la mayor parte del trabajo. Cada columna se envía con tres de sus valores, truncados a los primeros y últimos 100 caracteres. Eso es lo que indica al modelo que Name de Shopify es una referencia de pedido, y es la razón por la cual el mismo nombre de columna se mapea de forma diferente según lo que contenga.
Una llamada y luego cada número es tuyo
La llamada devuelve la matriz completa, no una decisión. Abrirla es la forma más clara de ver qué ha sucedido realmente.
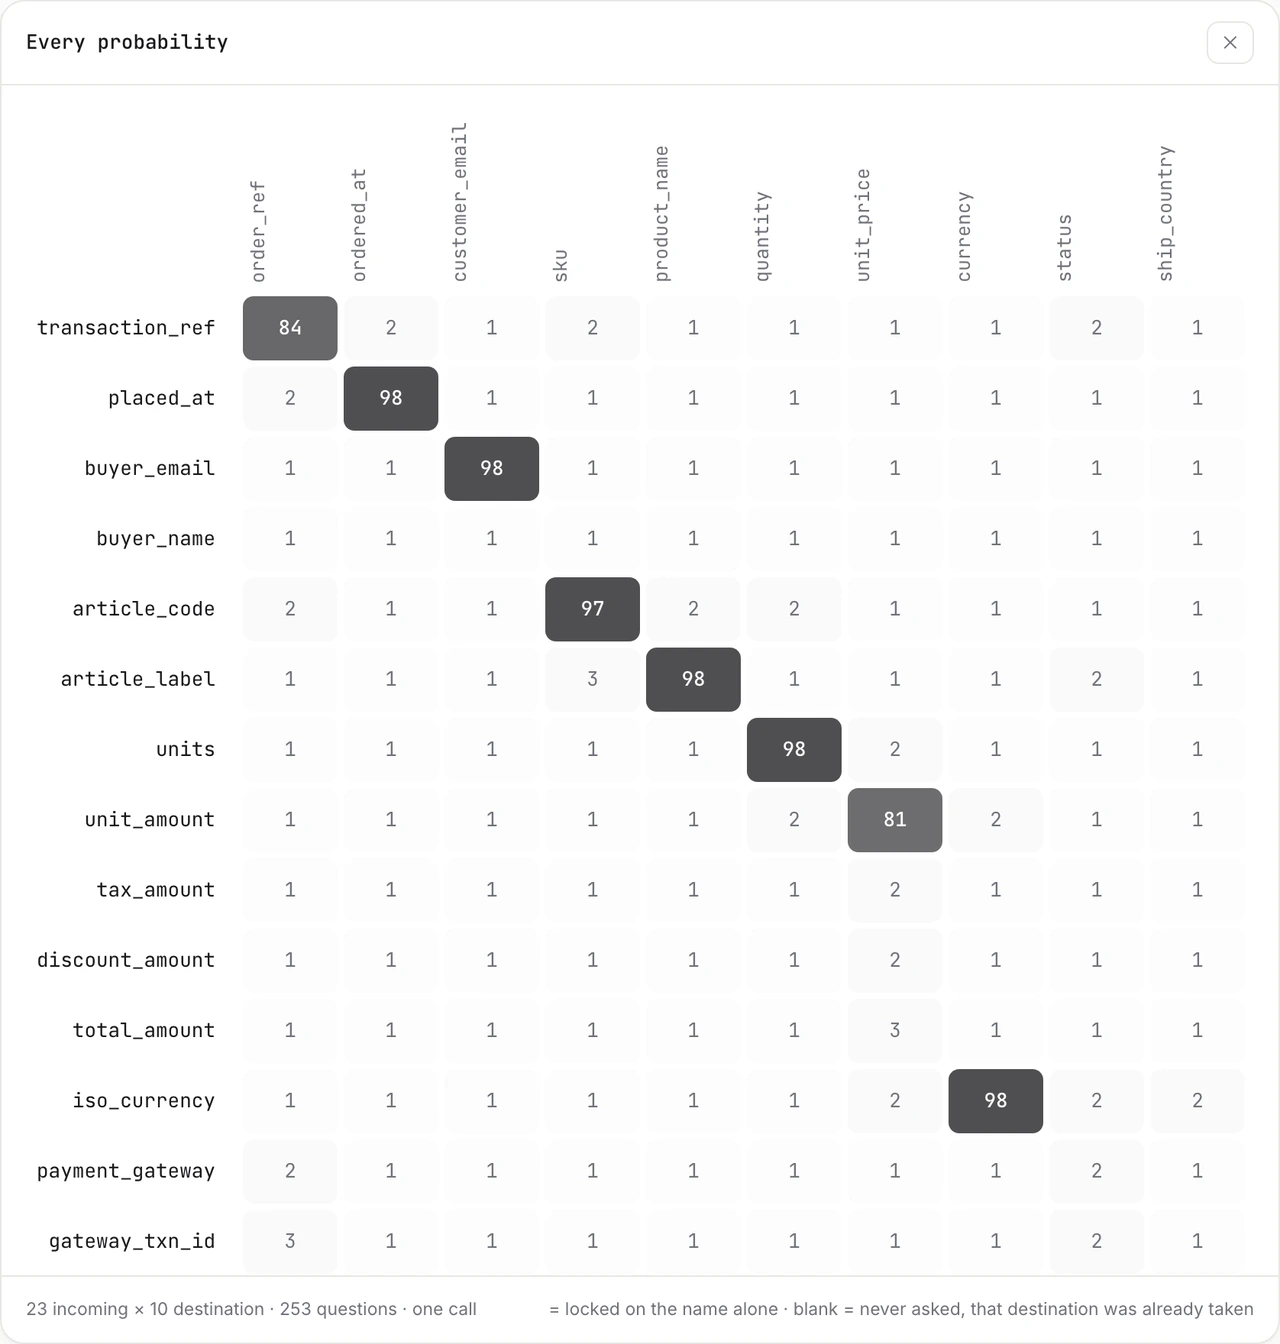
Como el código guarda cada número, el umbral es una constante que puedo mover en lugar de un comportamiento que deba solicitar mediante un prompt. Con 0,75, la exportación del almacén mapea los diez destinos y descarta las trece columnas correctas.
El punto de retorno
El archivo de Eventbrite es el que no puede terminar, y esa es la pantalla interesante.
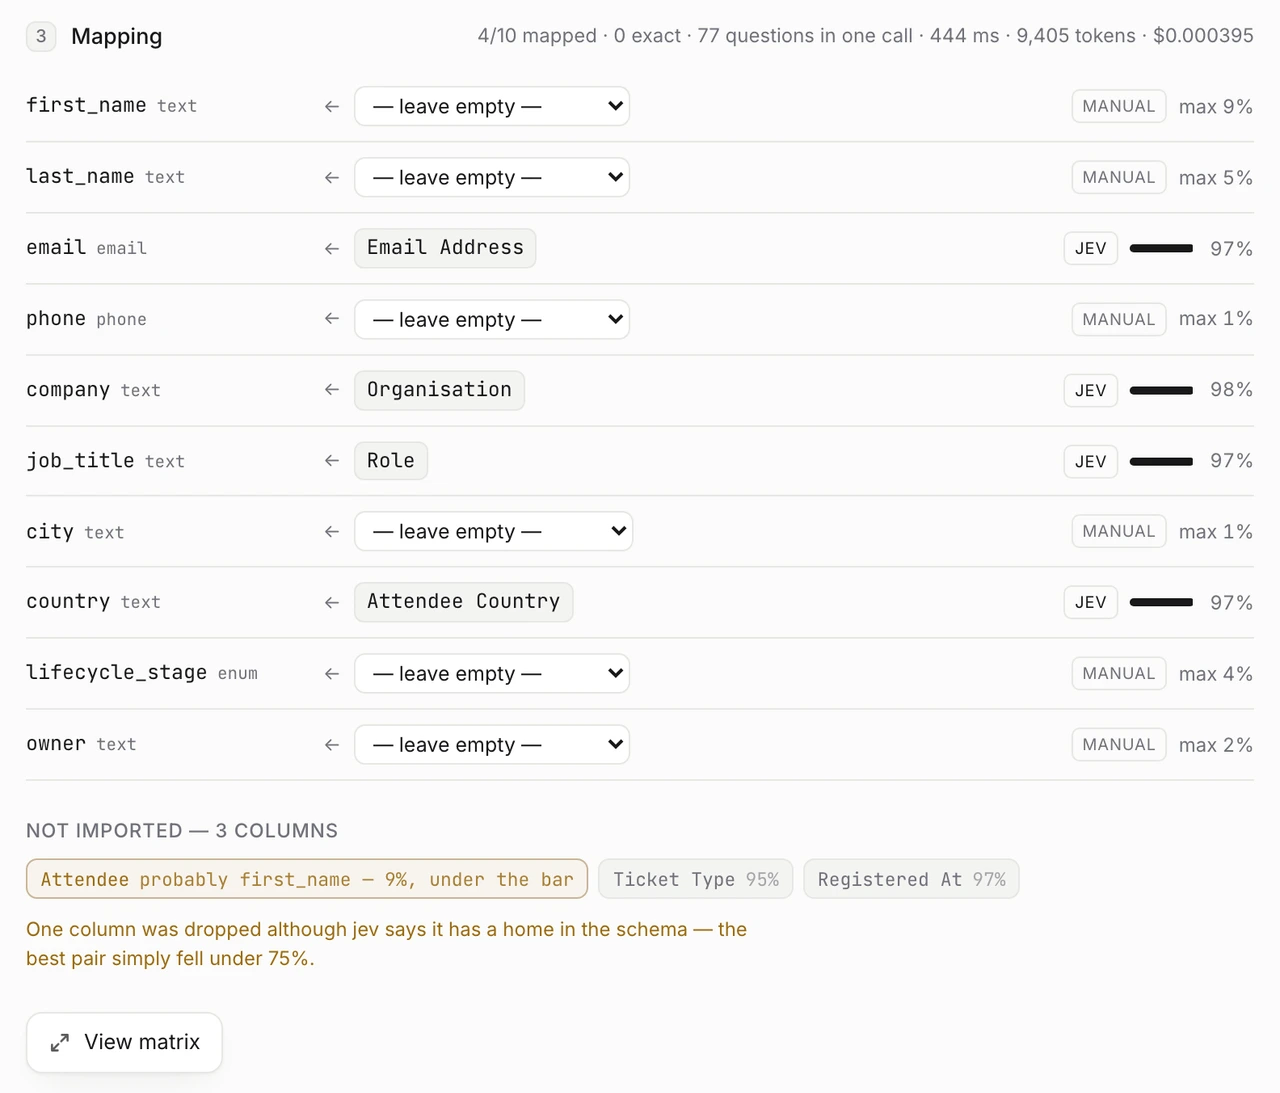
La pregunta de control se gana su lugar al final de esa pantalla. Attendee obtiene un 9 % en “¿no pertenece a ningún sitio?”, por lo que el modelo indica que sí tiene un lugar, pero su mejor pareja cayó por debajo de 0,75. La interfaz lo marca en ámbar en lugar de descartarlo silenciosamente. Ticket Type al 95 % y Registered At al 97 % se descartan sin comentarios, porque realmente no pertenecen a ningún sitio.
Conclusiones
Haz la parte determinista, y nada más que la parte determinista. La primera versión normalizaba mayúsculas, acentos y separadores, y además incluía una pequeña tabla de alias: attendeecountry a country, site a location, team a department. Esos son juicios disfrazados de normalización, y fallan dos veces. Un archivo que contiene tanto Attendee Country como Company Country produce dos coincidencias exactas en un solo destino, y el código bloquea la que aparece primero en el orden de las columnas, silenciosamente. Y team no es department, es una pregunta. Eliminar los alias hizo que el problema desapareciera en lugar de obligarme a arbitrarlo, porque ahora ninguna columna es exacta y el modelo las separa por sus valores.
Pregunta una vez, decide después. Una llamada devuelve 253 números calibrados en 675 ms, y todo lo demás es aritmética que puedo leer: el umbral, el orden de resolución, qué se considera una advertencia. Nada del resultado depende de haber persuadido al modelo para que se comporte de cierta forma. Mover la barra de 0,75 a 0,80 es una constante, no un prompt.
Vale la pena mostrar una probabilidad. Dado que el número ya existe, la interfaz lo imprime, y un mapeo al 81 % se lee de forma diferente a uno al 98 %. El modelo hace un preanálisis, no toma la decisión: el usuario ve el grado de seguridad, en qué columna, y recupera el control en las que importan. Eso es mucho mejor que un desplegable optimista sin ningún número.
Esto se probó con nueve archivos, tres tablas y diez columnas de destino cada una. Un esquema con 40 columnas requeriría más de una llamada, y el segundo presupuesto en la ventana de contexto de jev no se divide, por lo que una tabla de destino muy ancha es un límite real y no solo una ruta lenta. No lo he probado.