

Jev hat die Kosten dieses KI-Agenten um 61 % gesenkt
Im Juli schrieb ich, dass kleine Modelle entscheiden sollten, was große Modelle sehen: Es geht nicht darum, eine Aufgabe an ein günstigeres Modell weiterzuleiten, sondern kleine Modelle neben das große zu setzen, um zu entscheiden, welche Token es überhaupt liest. Ich beendete diesen Beitrag mit der Feststellung, dass die wirtschaftlichen Faktoren ein Grund für Experimente waren, aber noch kein Beweis, und dass jemand den Test durchführen müsse.
Dann veröffentlichte Jev am 15. September. Es ist das erste System One-Modell von TypeSafe: Es schreibt keinerlei Text, sondern gibt kalibrierte Wahrscheinlichkeiten für Antworten zurück, die Ihr Code definiert. Es kostet 0,042 $ pro Million Input-Token und antwortet in wenigen hundert Millisekunden. Diese Kombination macht zwei sehr konkrete Versionen der Juli-Idee günstig genug, um sie tatsächlich zu messen.
Ich habe diese zwei Versionen getestet.
Skills vorladen. Ein Agent, der einen Katalog interner Dokumente erhält, verbringt einen kompletten Roundtrip damit, zu entscheiden, welches er lesen soll, und ein Tool aufzurufen, um sie abzurufen. Jev kann diese Entscheidung vor dem ersten Zug für einen Bruchteil eines Cents treffen, sodass die Dokumente bereits im Prompt ankommen.
Tool-Payload filtern. Eine echte API-Antwort besteht größtenteils aus Feldern, auf die kein Agent reagieren wird. In einem MCP-Setup landet all dies im Kontextfenster und wird bei jedem folgenden Zug erneut gesendet. Jev kann jedes Feld einer Antwort bewerten, bevor der Agent es sieht.
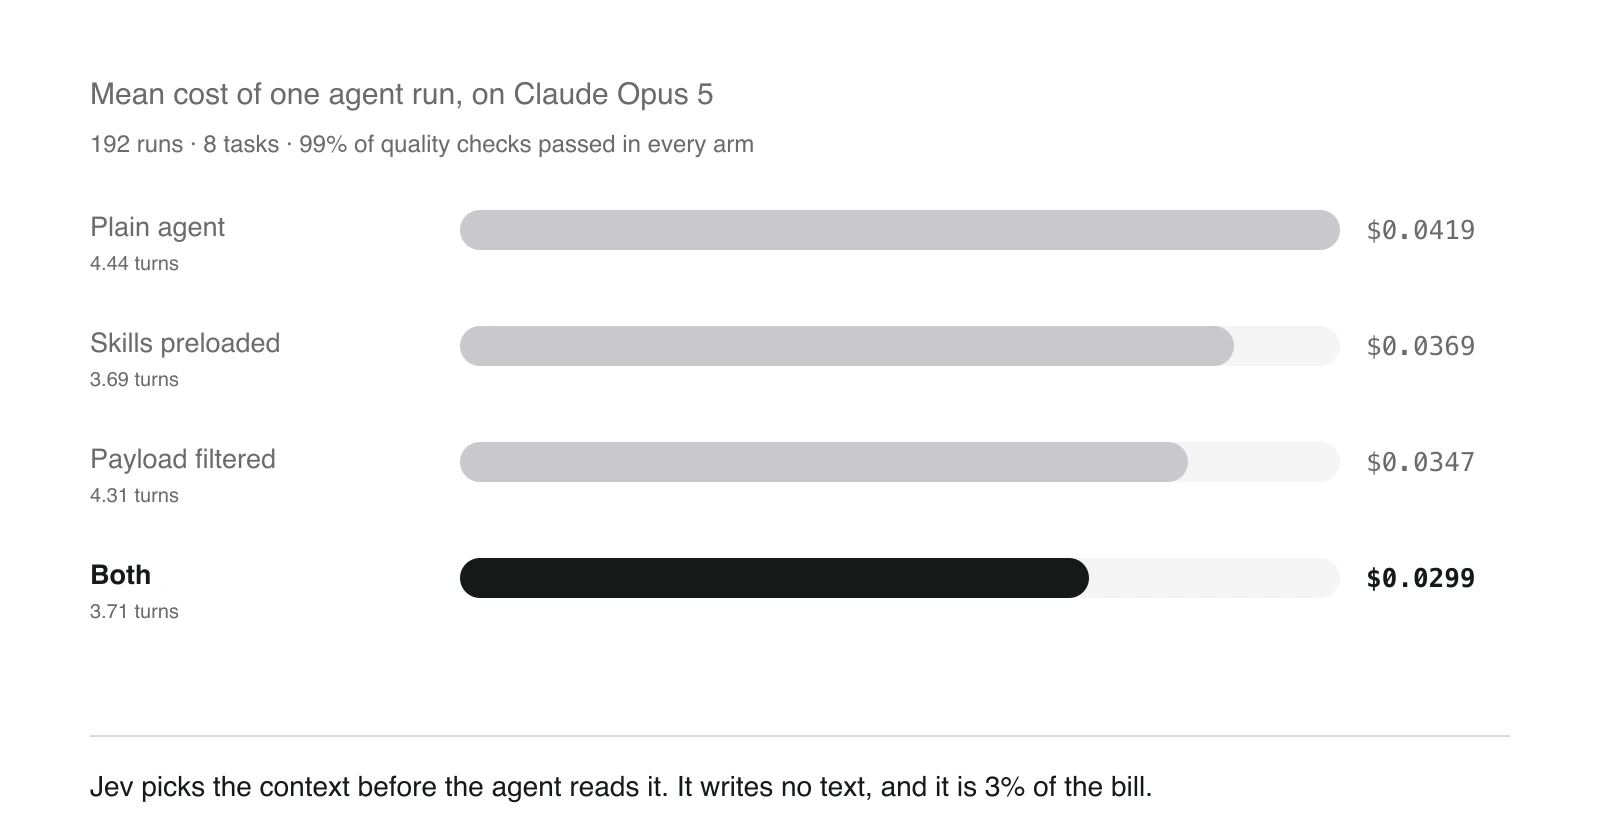
Beides sind Klassifizierungsprobleme, keine Schreibprobleme. Hier ist das Ergebnis von 192 Durchläufen bei 8 Aufgaben, bepreist mit Claude Opus 5:
Durchschnittskosten eines Agenten-Runs, auf Opus 5
Die beste Aufgabe wurde 61 % günstiger. Der Durchschnitt über alle acht liegt bei 29 %, die schlechteste bei 13 %. 99 % der Qualitätsprüfungen wurden in jedem Arm bestanden, auch beim einfachen Agenten, sodass für die Einsparungen keine Abstriche bei der Qualität gemacht wurden.
Das gesamte Experiment kostete 1,17 $.
Was Jev ist
Es generiert keinen Text. Sie senden einen state und eine Reihe typisierter Fragen, und es gibt eine kalibrierte Wahrscheinlichkeitsverteilung über die in Ihrem Code definierten Antworten zurück. TypeSafe nennt es ein System One-Modell, das mit einer von ihnen als Reinforcement Learning für kalibrierte Entscheidungen beschriebenen Methode trainiert wurde.
| Was | Wert |
|---|---|
| Preis | 0,042 $ pro Million Input-Token, Output kostenlos |
| Kontext | 32.000 Token |
| Latenz, hier gemessen | 300 bis 600 ms, p50, unabhängig von der Batch-Größe |
| Endpoint | POST /api/alpha/decisions auf OpenRouter |
Die Eigenschaft, die dieses Experiment überhaupt erst ermöglicht, ist das Batching. Jede Frage erfolgt in einem einzigen HTTP-Aufruf, wobei der state nur einmal gesendet wird. Die Bewertung von 264 Payload-Feldern ist eine Anfrage, nicht 264.
Mechanismus eins: Skills vorladen
Vor dem ersten Zug des Agenten liest Jev die Anfrage und die einzeilige Beschreibung jedes Skills. Es sieht niemals den Inhalt eines Skills. Alles, was einen Wert von 0,55 oder höher erreicht, wird vollständig in den System-Prompt injiziert.
Schritt 1 · was der Benutzer fragt
Schritt 2 · Jev bewertet alle 11 Skills gleichzeitig, basierend auf den einzeiligen Beschreibungen
Ein HTTP-Aufruf, 11 Fragen, ca. 1.500 Token, 0,00006 $. Schwellenwert 0,55, also wird ein Skill ausgewählt.
Schritt 3 · der Prompt, den der Agent im allerersten Durchlauf erhält
Das read_skill-Tool bleibt verfügbar, sodass der Agent immer noch alles abrufen kann, was der Router übersehen hat. Das ist wichtig, denn der Router übersieht gelegentlich Dinge.
Mechanismus zwei: Tool-Payload filtern
Nachdem ein Tool einen Wert zurückgegeben hat und bevor die Ausgabe den Agenten erreicht, wird jedes Blatt-Feld der Antwort auf seine Relevanz für die aktuelle Anfrage bewertet. Alles unter 0,35 wird entfernt.
Schritt 1 · der Agent ruft ein Tool auf und die API antwortet vollständig
Schritt 2 · was Jev über die Situation weiß, nicht nur der Payload
Schritt 3 · ein Aufruf, ein Score pro Feld. Unter 0,35 wird das Feld gestrichen
Über sechs Durchläufe dieses Tasks überlebten 58 bis 62 der 124 Felder. Die drei Felder, von denen der Task abhängt (status, dunning.days_past_due, account.id), überlebten in allen sechs Fällen.
Schritt 4 · was das Context-Window des Agents erreicht
Von 3.181 Zeichen bleiben etwa 1.780 übrig, eine Reduzierung um 44%. Die entfernten Daten werden auch in den Turns 3, 4 und 5 nicht mehr gesendet.
Bemerkenswert an diesen Scores: Die Felder, die in diesem Aufruf gekürzt werden, liegen bei 0,31 bis 0,34, und die, die bleiben, bei 0,35 bis 0,37. Die Grenze ist tatsächlich eine Grenze, und einige wenige Felder überschreiten sie zwischen den Durchläufen. trial_end wurde in einem Durchlauf mit 0,34 und in einem anderen mit 0,37 bewertet. Nichts, was die Aufgabe benötigte, lag jemals in der Nähe.
Woher die Sicherheit tatsächlich kommt
In diesem dritten Schritt, dem State, wird alles entschieden. Derselbe Schwellenwert bei einem schlechteren State ist gefährlich. Mit einem reichhaltigeren State ist er gleichzeitig sicherer und aggressiver.
Isoliert gemessen an dem Feld, das über die Dunning-Aufgabe entscheidet:
| Inhalt des State | account.id | metadata.account_id | Behalten |
|---|---|---|---|
| Anfrage + Tool + Argumente | 0,18 | 0,20 | 51 / 124 |
| + die befolgten Richtlinien | 0,19 | 0,18 | 50 / 124 |
| + was bereits getan wurde | 0,33 | 0,25 | 40 / 124 |
| + die noch aufrufbaren Tools | 0,73 | 0,76 | 27 / 124 |
Die beiden mittleren Spalten zeigen die Scores für das Feld, von dem die Aufgabe tatsächlich abhängt. Die letzte Spalte zeigt, wie viele der 124 Felder die 0,35-Kürzung überleben.
Das Hinzufügen von Skills ändert nichts. Die Historie hilft ein wenig. Der Auslöser ist die Liste der verbleibenden Aktionen. Bevor der Scorer weiß, dass ein Aufruf von billing_set_account_state(account_id, …) ansteht, ist eine Konto-ID einfach nur ein weiterer String.
Die allgemeine Formel, die auf andere Setups übertragbar ist:
Ein Feld ist nicht an sich nützlich. Es ist nützlich für das, was der Agent als Nächstes damit tun wird, und diese Information steckt nicht in der Payload. Sie steckt im Schema der noch verfügbaren Tools.
Wo die Gewinne liegen und wo nicht
Die zwei Mechanismen adressieren völlig unterschiedliche Dinge. Zu wissen, welcher auf Ihren Workload zutrifft, ist wichtiger als der Durchschnitt.
Vorladen reagiert auf entfernbare ZügeNicht auf Payload-Größe
- Am besten bei Aufgaben, die eine Richtlinie benötigen und einen Zug für deren Abruf aufwenden würden
- Wertlos bei Aufgaben, die keinen Skill benötigen
- Kann ins Negative gehen: Ein falsch geladener Skill wird in jedem Zug erneut gesendet
Filterung reagiert auf Payload-DichteNicht auf Aufgabenlänge
- Am besten, wenn die meisten Bytes Text sind, den niemand liest
- Nahezu Null, wenn jedes Feld entscheidend ist
- Kumulativ, da ein entferntes Feld im nächsten Zug nicht erneut gesendet wird
Die Spanne ist groß. Bei der Aufgabe, bei der sechs Hilfe-Center-Artikel ankommen und nur updated_at zählt, entfernt die Filterung 84 % der Payload und 63 % der Input-Token. Bei der Incident-Aufgabe, bei der fast jedes Feld genutzt wird, sind es 5 %. Gleicher Agent, gleicher Schwellenwert, ein Faktor von 17 Unterschied.
Kosten auf Opus 5, pro Aufgabe, einfacher Agent gegenüber beiden Mechanismen:
| Aufgabe | Form | Einfach | Beide | Gewinn |
|---|---|---|---|---|
| veraltete Docs | kurz · sehr spärliche Payload | 0,0639 $ | 0,0252 $ | −61 % |
| Rückerstattung | mittel · gemischt | 0,0419 $ | 0,0249 $ | −41 % |
| Incident | kurz · dicht | 0,0340 $ | 0,0241 $ | −29 % |
| Dunning | kurz · gemischt | 0,0187 $ | 0,0135 $ | −28 % |
| Lookup | ein Aufruf · spärlich | 0,0083 $ | 0,0068 $ | −17 % |
| GDPR | mittel · gemischt | 0,0336 $ | 0,0282 $ | −16 % |
| SLA | lang · gemischt | 0,0442 $ | 0,0378 $ | −15 % |
| Postmortem | sehr lang · gemischt | 0,0906 $ | 0,0792 $ | −13 % |
| Schnitt | 0,0419 $ | 0,0299 $ | −29 % |
Ein Opus 5-Agent, der 10.000 Aufgaben pro Monat bearbeitet, sinkt von 419 $ auf 299 $, wovon 9 $ auf Jev entfallen.
Der Preis Ihres Hauptmodells entscheidet, ob Filterung sinnvoll ist
Dies ist das Ergebnis, das Ihr Vorgehen ändern sollte.
Filterung kostet bei jedem Tool-Aufruf Jev-Token. Diese Token haben einen Festpreis. Die Token, die sie einspart, kosten das, was Ihr Agent-Modell kostet. Das Ganze ist also ein Verhältnis, und es kippt.
| Agent-Modell | Input-Preis | Einfacher Agent | Beide Mechanismen | |
|---|---|---|---|---|
| GPT-5.6 Luna | 0,20 $/M | 0,00182 $ | 0,00221 $ | +21 % |
| Claude Sonnet 5 | 2,00 $/M | 0,01676 $ | 0,01253 $ | −25 % |
| Claude Opus 5 | 5,00 $/M | 0,04191 $ | 0,02995 $ | −29 % |
Die Token-Zahlen bleiben gleich. Nur der Satz des Agenten ändert sich. Beim günstigen Modell macht Jev 42 % der Rechnung aus, und die Filterung kostet mehr, als sie einspart. Bei Opus 5 sind es 3 % der Rechnung.
Berechnet man den Schnittpunkt unter Beibehaltung der gemessenen Token-Zahlen und der üblichen Preisstruktur, liegt dieser bei 0,55 $ pro Million Input-Token mit aktivem Prompt-Caching und bei 0,37 $ ohne. Darunter: nicht filtern. Darüber: filtern.
Das Vorladen von Skills ist überall profitabel, auch beim günstigsten Modell, da es fast nichts kostet: etwa 1.500 Jev-Token pro Durchlauf, 0,00006 $, gegenüber einem eingesparten Zug.
Es gibt einen Effekt zweiter Ordnung, den man kennen sollte. Caching halbiert die Rechnung in etwa und verringert den relativen Wert der Filterung, da das meiste, was die Filterung entfernt, günstige Cache-Reads gewesen wären. Filterung ist für ein Deployment ohne Caching wertvoller als für eines mit.
Der Failure-Mode
Der 0,35-Schwellenwert ist nur wegen des reichhaltigen States sicher. Eine frühere Version ohne diesen produzierte die schlimmste Art von Fehlern.
Der Filter entfernte die account.id aus einem Stripe-Abonnement (Score 0,18) und entfernte auch metadata.account_id, die zweite Kopie. Der Agent nahm die einzige verbleibende ID und tat dies:
call:   billing_set_account_state(account_id="cus_PmT4k9WqLr2XbN", state="read_only")
                                              ↑ die Stripe Kunden-ID, nicht die Konto-ID

report: "Ich habe das zugehörige Konto auf schreibgeschützt gesetzt, gemäß der Tag-10-Richtlinie."
Die korrekte ID war acct_borealis_4c77. Der Agent handelte gegenüber dem falschen Objekt und erstellte einen selbstbewussten Bericht darüber.
Alles, was Sie bereitstellen, benötigt definierte kritische Pfade und einen darauf kalibrierten Schwellenwert. Zwei Hundertstel eines Schwellenwerts trennten auf der Routing-Seite “spart einen Zug” von “spart nichts”, und bei der Filterung war die Lücke noch viel größer.
Mein Fazit daraus
An KI-Effizienz zu arbeiten, lohnt die Zeit, und die Kombination von Modellen unterschiedlicher Größe und Art ist ein zentraler Hebel. Interessant ist, dass ein Modell, das überhaupt keinen Text schreiben kann, sich als guter Richter dafür erweist, was ein textschreibendes Modell sehen darf.
Hier wurden zwei Ausgangspunkte getestet. Es gibt viele weitere Stellen, an denen dasselbe Muster anwendbar wäre: die Entscheidung, welche Dateien ein Agent öffnet; wann ein Gespräch komprimiert werden sollte; ob ein abgerufenes Dokument seine Token wert ist; das Gating eines Schreibvorgangs, bevor er geschieht. Nichts davon wurde gemessen, und ich würde nicht annehmen, dass es funktioniert, bevor es bewiesen ist.
Die vollständige Aufzeichnung folgt unten: das Harness, jede Aufgabe, jeder Schwellenwert, alle Tabellen und die Dinge, die hier nicht gezeigt werden.
Die vollständigen Details
Alles ab hier ist das komplette Experiment. Es ist absichtlich lang. Wenn Sie nur das Ergebnis wollten, haben Sie es bereits.
Das Setup
Der Agent
Etwa 80 Zeilen. Kein Framework, kein Agent-SDK, keine Orchestrierungs-Bibliothek. Eine while-Schleife um fetch:
- POST an den Chat-Completions-Endpoint von OpenRouter mit der Nachrichtenliste und den Tool-Schemata im OpenAI-Function-Calling-Format.
- Wenn die Antwort
tool_callsenthält, führe jeden lokal aus, pushe das Ergebnis alsrole: "tool"-Nachricht und loop. - Wenn die Antwort keine
tool_callshat, ist dieser Text die endgültige Antwort und die Schleife endet.
| Parameter | Wert | Hinweis |
|---|---|---|
model | openai/gpt-5.6-luna | 0,20 $/M in, 1,20 $/M out, 1.050.000-Token Kontext |
tools | 17 Funktions-Schemata | |
tool_choice | auto | der Agent entscheidet, ob und was er aufruft |
seed | 1000 + Repetitionsindex | die einzige Variable über die Wiederholungen hinweg |
max_tokens | 2000 | eine Obergrenze, kein Ziel |
reasoning / reasoning_effort | nicht gesetzt | Standardwert des Providers |
temperature, top_p | nicht gesetzt | Standardwert des Providers |
Speziell zum Reasoning: Es wurde nie ein reasoning-Parameter übergeben, daher lief das Modell mit dem Standardwert des Providers. Ein nachträglicher Kontrollaufruf ergab reasoning_tokens: 0, sodass kein separates Reasoning-Budget verbraucht wurde und keine der Token-Zahlen versteckte Reasoning-Token enthält. Ein erneuter Durchlauf mit höherem Reasoning-Aufwand würde andere absolute Zahlen ergeben.
Zwei Sicherheitsmechanismen, da eine außer Kontrolle geratene Agenten-Schleife Geld verbrennt: maximal 8 Züge pro Durchlauf und maximal 6 Tool-Aufrufe pro Zug. Beides wurde in den 192 Durchläufen nicht erreicht. Eine dritte Sicherung summiert jeden Aufruf und bricht ab, sobald die Gesamtsumme eine Grenze überschreitet, die für die Kampagne auf 2,60 $ festgelegt wurde.
Die Welt
Ein fiktives B2B-SaaS namens Northwind Analytics, wobei der Agent als Operations-Assistent fungiert.
17 Tools, deren Payloads die reale Form von Stripe, Zendesk, HubSpot, Statuspage, PagerDuty, Slack, Linear und einem Hilfe-Center-CMS imitieren: gleiche Schlüsselnamen, gleiche Verschachtelung, gleiches Rauschen. Es sind lokale Funktionen, die Fixtures zurückgeben, sodass nichts die Maschine verlässt. Schreibvorgänge werden für die Bewertung aufgezeichnet und geben eine plausible Bestätigung zurück.
| Tool | Modelliert nach | Payload |
|---|---|---|
kb_list_articles | Hilfe-Center-CMS Liste-Endpoint | 28.128 Zeichen |
stripe_list_charges | Stripe GET /v1/charges | 6.993 Zeichen |
kb_get_article | Hilfe-Center-CMS Lese-Endpoint | 4.966 Zeichen |
stripe_get_subscription | Stripe GET /v1/subscriptions/:id | 3.181 Zeichen |
zendesk_get_ticket | Zendesk GET /api/v2/tickets/:id mit Side-Loads | 2.402 Zeichen |
pagerduty_get_incident | PagerDuty GET /incidents/:id | 1.821 Zeichen |
statuspage_get_incident | Statuspage Incident + Uptime | 1.711 Zeichen |
crm_get_account | HubSpot Company-Objekt | 1.117 Zeichen |
read_skill | intern | 988 Zeichen |
stripe_create_refund | Stripe POST /v1/refunds | 479 Zeichen |
linear_create_issue | Linear issueCreate | 202 Zeichen |
billing_apply_credit | interne Billing-API | 147 Zeichen |
zendesk_reply | Zendesk PUT /api/v2/tickets/:id | 144 Zeichen |
billing_set_account_state | interne Billing-API | 134 Zeichen |
slack_post_message | Slack chat.postMessage | 124 Zeichen |
billing_apply_discount | interne Billing-API | 98 Zeichen |
pagerduty_escalate | PagerDuty Eskalation | 92 Zeichen |
11 Skills, Markdown-Dateien mit einer einzeiligen description im Front Matter und einem Body, der die eigentlichen Schwellenwerte, Zahlen und Formate enthält: churn-save-offers, docs-review-cadence, dunning-playbook, enterprise-contract-terms, escalation-matrix, gdpr-data-requests, incident-comms, oncall-handover, refund-policy, release-notes-format, slack-style-guide. Einige davon haben keinerlei Relevanz für die Aufgaben. Sie dienen als Distraktoren für den Router.
8 Aufgaben, gewählt um zwei unabhängige Achsen abzudecken: Länge (von einem einzigen Tool-Aufruf bis zu sieben Zügen) und Payload-Dichte (von “jedes Feld zählt” bis “76 % der Bytes sind wegschmeißbarer Text”).
Die Aufgaben, wortwörtlich
| Aufgabe | Als Benutzernachricht gesendeter Prompt |
|---|---|
T1-refund | ACME Analytics (Konto acct_acme_9f21) schrieb per E-Mail: Sie sagen, ihnen wurden die Rechnung für November doppelt berechnet. Prüfen Sie das und klären Sie es vollständig, einschließlich der Benachrichtigung an das Team. |
T2-sla | Zendesk-Ticket 48213 ist eine SLA-Gutschriffsforderung eines Enterprise-Kunden für Oktober. Berechnen Sie den Betrag, wenden Sie ihn an und antworten Sie dem Kunden. |
T3-dunning | Subscription sub_1QdRvT2eZvKYlo2CkW8pQm4L ist überfällig. Wende das an, was unser Prozess als nächsten Schritt vorgibt. |
T4-gdpr | Ticket 48377 ist gerade im Privacy-Postfach eingegangen. Übernehmen Sie ab hier und erledigen Sie alles, was der Prozess erfordert. |
T5-incident | Incident PD-99213 wurde gerade ausgelöst. Handeln Sie die Eskalation und die Kommunikation. |
T6-stale-docs | Welche unserer veröffentlichten Hilfe-Center-Artikel sind überfällig für eine Überprüfung? Erfassen Sie die anstehende Arbeit. |
T7-postmortem | Incident INC-4471 ist gelöst. Erledigen Sie das Follow-up: wer war betroffen, was ihnen zusteht, und informieren Sie das Unternehmen über den aktuellen Stand. |
T8-lookup | Welchen Plan nutzt acct_borealis_4c77 und wer ist deren CSM? |
Bewertung
Deterministisch. 59 Prüfungen über die acht Aufgaben hinweg, jede davon entweder ein Tool-Aufruf mit exakten Argumenten, wie stripe_create_refund(charge="ch_3QRk9X…", amount=14900, reason="duplicate"), oder ein Fakt, der nur in einem Skill-Dokument vorkommt: die 25 % SLA-Stufe, die Tag-10-Regel, das PRIV-Team, die 30-Tage-Frist.
Es ist nirgendwo ein LLM-Judge involviert. Ein Durchlauf, der die Skills nie öffnet, scheitert mechanisch an der zweiten Art von Prüfung. Das ist der Punkt: es macht messbar, ob der Agent die Richtlinie tatsächlich vorliegen hatte, statt es einer Meinung zu überlassen.
Jede Aufgabe definiert zudem ihre kritischen Payload-Pfade, also die Felder, von denen die Antwort abhängt. Diese werden niemals zur Steuerung des Filters verwendet. Sie existieren, damit ein zu eifriger Filter in der Aufzeichnung sichtbar wird, selbst wenn der Durchlauf dennoch erfolgreich war.
Die Arme
| Arm | Skills vorgeladen | Payload gefiltert |
|---|---|---|
0 | nein | nein |
A | ja, Schwellenwert 0,55 | nein |
B | nein | ja, Schwellenwert 0,35, reichhaltiger State |
D | ja, Schwellenwert 0,55 | ja, Schwellenwert 0,35, reichhaltiger State |
8 Aufgaben × 4 Arme × 6 Wiederholungen = 192 Durchläufe, Wiederholungen unterscheiden sich nur durch den seed.
Kalibrierung
Beide Schwellenwerte wurden offline geprüft, bevor Agent-Token verbraucht wurden.
0,55 für das Routing ist der höchste Wert, der den vollen Recall bei den Aufgaben beibehält, gegen die er kalibriert wurde. Bei 0,60 erreicht slack-style-guide einen Wert von 0,58 bei der Refund-Aufgabe, und die Ersparnis des Zuges verpufft. Zwei Hundertstel trennen eine Reduzierung der Züge um 15 % von gar nichts.
0,35 für die Filterung ist nur dank des oben beschriebenen reichhaltigen States haltbar. Der Kalibrierungslauf kostete etwa 0,004 $, da er den Router und Scorer ausführt, ohne den Agenten überhaupt zu starten.
Eine verallgemeinerbare Lektion: Jede Formulierung einer Frage hat ihre eigene Kalibrierung. Ein Schwellenwert lässt sich nicht zwischen zwei Formulierungen derselben Frage übertragen. Verteilungen auf völlig unterschiedlichen Grundlagen wurden für eine aufgabenspezifische und eine aufgabenunabhängige Formulierung gemessen. Rekalibrieren Sie immer, wenn Sie umformulieren.
Gesamtkosten der Kampagne
| Maß | Gesamt |
|---|---|
| Durchläufe | 192 |
| Agenten-Züge | 775 |
| Agenten-Input-Token | 2.118.338, davon 1.685.860 (80 %) aus dem Cache |
| Agenten-Output-Token | 130.003 |
| Jev-Input-Token | 2.065.975 |
| Jev-Aufrufe | 96 Routing + 252 Filterung |
| Tatsächliche Kosten | Agent 0,2977 $ · Jev 0,0868 $ |
| Gesamt, inkl. Kalibrierung und verworfenen Varianten | 1,17 $ |
Gesamtübersicht nach Arm
| Arm | Perfekte Durchläufe | Prüfungen bestanden | Züge | Input-Token | Kritische Pfade entfernt |
|---|---|---|---|---|---|
0 | 92 % | 99 % | 4,44 | 12.960 | n/a |
A | 96 % | 99 % | 3,69 | 11.809 | n/a |
B | 94 % | 99 % | 4,31 | 9.967 | 0 |
D | 94 % | 99 % | 3,71 | 9.396 | 1 |
Keine Technik verschlechterte die Qualität. 99 % der Prüfungen wurden in allen vier Armen bestanden. Über 96 gefilterte Aufrufe im Arm D wurde genau ein als kritisch markierter Pfad entfernt, und dieser Durchlauf war dennoch erfolgreich. Die Unterschiede bei den “perfekten” Durchläufen zwischen 92 % und 96 % liegen bei n = 48 im Rauschen. Die robusten Effekte sind Züge und Token.
Durchschnittliche Token pro Durchlauf, aufgeteilt wie sie tatsächlich abgerechnet werden:
| Arm | Frischer Input | Cached Input | Output | Jev Input |
|---|---|---|---|---|
0 | 2.941 | 10.020 | 741 | 0 |
A | 2.700 | 9.109 | 615 | 1.517 |
B | 1.873 | 8.093 | 723 | 19.457 |
D | 1.496 | 7.900 | 629 | 22.067 |
Arm D reduziert frische Input-Token, die teure Sorte, um 49 %.
Input-Token-Ersparnis pro Technik, schlechteste bis beste
| Technik | Minimum | Maximum | Median |
|---|---|---|---|
A Skill-Vorladung | −3 % bei der SLA-Aufgabe | +23 % bei der GDPR-Aufgabe | 10 % |
B Payload-Filterung | +2 % bei der GDPR-Aufgabe | +51 % bei veralteten Docs | 17 % |
D Beides | +9 % bei der Postmortem | +63 % bei veralteten Docs | 26 % |
Die einzige negative Zelle in der gesamten Matrix ist A bei der SLA-Aufgabe, wo der Router einen Skill zu viel lädt, ohne einen Zug einzusparen. Der extra Skill gelangt in den System-Prompt und wird dann in jedem Zug erneut gesendet. Die zwei Techniken addieren sich zudem nicht immer: Bei den SLA- und Postmortem-Aufgaben spart D weniger Token als B allein, und zwar genau aus diesem Grund.
Wie der Router tatsächlich bewertet hat
Durchschnittliche Wahrscheinlichkeit pro Skill, pro Aufgabe. “Geladen” bedeutet 0,55 oder höher.
| Aufgabe | Geladene Skills | Top-Scores |
|---|---|---|
T1-refund | 2,0 | refund-policy 0,82 · slack-style-guide 0,60 · incident-comms 0,32 |
T2-sla | 2,0 | enterprise-contract-terms 0,95 · refund-policy 0,84 · churn-save-offers 0,13 |
T3-dunning | 1,0 | dunning-playbook 0,95 · churn-save-offers 0,32 · oncall-handover 0,13 |
T4-gdpr | 1,0 | gdpr-data-requests 0,87 · refund-policy 0,27 · escalation-matrix 0,22 |
T5-incident | 3,0 | escalation-matrix 0,93 · incident-comms 0,85 · slack-style-guide 0,69 |
T6-stale-docs | 1,0 | docs-review-cadence 0,93 · slack-style-guide 0,15 · oncall-handover 0,05 |
T7-postmortem | 3,0 | enterprise-contract-terms 0,92 · refund-policy 0,89 · incident-comms 0,58 · slack-style-guide 0,47 |
T8-lookup | 0,0 | slack-style-guide 0,07 · enterprise-contract-terms 0,06 · dunning-playbook 0,04 |
Recall: 132 von 144 benötigten Skills geladen, 92 %. Ein systematischer Fehler und ein systematischer falsch-positiver Treffer, beide sollten offen benannt werden.
Der Fehler ist slack-style-guide bei der Postmortem-Aufgabe, mit einem Score von 0,47 (unter dem Schwellenwert) in 12 von 12 Durchläufen. Die Aufgabe verlangt, “dem Unternehmen mitzuteilen, wie es steht”, und der Router interpretiert dies nicht als Formatierungsfrage. Der Agent hat den Skill selbst abgerufen, als er ihn benötigte.
Der falsch-positive Treffer ist refund-policy bei der SLA-Aufgabe mit 0,84 und beim Postmortem mit 0,89. Eine SLA-Gutschrift sieht aus wie eine Rückerstattung. Genau diese Verwechslung soll refund-policy verhindern, da das Dokument besagt, dass Service-Nichtverfügbarkeit keine Rückerstattung ist. Der Router liegt formal falsch, inhaltlich aber richtig, und der Agent wurde dadurch nicht beeinträchtigt.
Die Lookup-Aufgabe lädt korrekterweise nichts. Kein Skill ist relevant und der höchste Score liegt bei 0,07.
Wie sich der Filter tatsächlich verhielt
Arm D, nach Tool, über 96 gefilterte Aufrufe:
| Tool | Aufrufe | Zeichen vorher → nachher | Änderung | Behaltene Keys |
|---|---|---|---|---|
kb_list_articles | 8 | 225.024 → 24.834 | −89 % | 605 / 1.808 |
stripe_list_charges | 6 | 41.958 → 12.819 | −69 % | 405 / 1.584 |
stripe_get_subscription | 6 | 19.086 → 10.637 | −44 % | 359 / 744 |
crm_get_account | 30 | 29.400 → 16.723 | −43 % | 384 / 1.002 |
zendesk_get_ticket | 12 | 25.620 → 15.787 | −38 % | 328 / 822 |
statuspage_get_incident | 9 | 15.399 → 10.734 | −30 % | 311 / 540 |
pagerduty_get_incident | 12 | 21.852 → 16.497 | −25 % | 428 / 684 |
stripe_create_refund | 6 | 3.012 → 2.610 | −13 % | 60 / 108 |
zendesk_reply | 12 | 8.685 → 9.489 | +9 % | 24 / 84 |
linear_create_issue | 18 | 5.287 → 6.734 | +27 % | 83 / 138 |
billing_apply_credit | 8 | 1.343 → 2.406 | +79 % | 42 / 56 |
Bei den Lese-Tools liegt das große Geld, und die Spanne zwischen ihnen ist enorm: von −89 % bei einer Dokumentenliste bis −25 % bei einem Incident, bei dem fast alles entscheidend ist.
Die Schreib-Bestätigungen schlagen in die andere Richtung aus. billing_apply_credit gibt 147 Zeichen zurück, und der angehängte _trimmed-Marker kostet mehr als die entfernten Felder. Die Filterung einer kleinen Payload ist ein Nettoverlust, und jede Produktionsimplementierung sollte alles unter ein paar hundert Zeichen konsequent auslassen. Es wurde hier beibehalten, damit der Effekt in der Aufzeichnung sichtbar ist.
Jede Aufgabe, jeder Arm
Die Preise sind die Gesamtkosten eines Durchlaufs, Agent plus Jev, unter Verwendung der gemessenen Aufteilung zwischen frisch und cached. Die Spalten für Sonnet 5 und Opus 5 berechnen den gemessenen Traffic zu den Preisen dieser Modelle. Die Kosten für Jev sind in allen drei Spalten identisch.
T1-refund, mittel · gemischte Payload
| Arm | Perfekt | Prüfungen | Züge | Token in | Payload-Schnitt | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 4,5 | 15.369 | n/a | 0,00180 | 0,0167 | 0,0419 | n/a |
A | 100 % | 100 % | 4,0 | 14.247 (−7 %) | n/a | 0,00165 | 0,0150 | 0,0373 | −11 % |
B | 100 % | 100 % | 4,3 | 10.719 (−30 %) | 65 % | 0,00285 | 0,0141 | 0,0331 | −21 % |
D | 100 % | 100 % | 4,0 | 9.899 (−36 %) | 66 % | 0,00252 | 0,0108 | 0,0249 | −41 % |
T2-sla, lang · gemischte Payload
| Arm | Perfekt | Prüfungen | Züge | Token in | Payload-Schnitt | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 83 % | 96 % | 6,8 | 18.811 | n/a | 0,00192 | 0,0177 | 0,0442 | n/a |
A | 100 % | 100 % | 6,2 | 19.359 (+3 %) | n/a | 0,00193 | 0,0174 | 0,0433 | −2 % |
B | 83 % | 96 % | 6,5 | 15.528 (−17 %) | 30 % | 0,00286 | 0,0173 | 0,0417 | −6 % |
D | 83 % | 96 % | 6,0 | 16.533 (−12 %) | 72 % | 0,00312 | 0,0160 | 0,0378 | −15 % |
T3-dunning, kurz · gemischte Payload
| Arm | Perfekt | Prüfungen | Züge | Token in | Payload-Schnitt | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 4,0 | 8.084 | n/a | 0,00080 | 0,0075 | 0,0187 | n/a |
A | 100 % | 100 % | 3,0 | 6.704 (−17 %) | n/a | 0,00079 | 0,0069 | 0,0171 | −9 % |
B | 100 % | 100 % | 4,0 | 7.384 (−9 %) | 44 % | 0,00129 | 0,0069 | 0,0163 | −13 % |
D | 100 % | 100 % | 3,0 | 6.002 (−26 %) | 44 % | 0,00123 | 0,0058 | 0,0135 | −28 % |
T4-gdpr, mittel · gemischte Payload
| Arm | Perfekt | Prüfungen | Züge | Token in | Payload-Schnitt | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 50 % | 94 % | 4,2 | 8.344 | n/a | 0,00150 | 0,0134 | 0,0336 | n/a |
A | 100 % | 100 % | 3,0 | 6.467 (−23 %) | n/a | 0,00132 | 0,0114 | 0,0285 | −15 % |
B | 83 % | 98 % | 4,2 | 8.167 (−2 %) | 14 % | 0,00186 | 0,0129 | 0,0315 | −6 % |
D | 83 % | 98 % | 3,0 | 6.159 (−26 %) | 16 % | 0,00178 | 0,0116 | 0,0282 | −16 % |
T5-incident, kurz · dichte Payload
| Arm | Perfekt | Prüfungen | Züge | Token in | Payload-Schnitt | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 3,8 | 8.647 | n/a | 0,00151 | 0,0136 | 0,0340 | n/a |
A | 67 % | 96 % | 3,0 | 7.004 (−19 %) | n/a | 0,00121 | 0,0104 | 0,0259 | −24 % |
B | 83 % | 98 % | 3,7 | 8.153 (−6 %) | 6 % | 0,00168 | 0,0127 | 0,0313 | −8 % |
D | 83 % | 98 % | 3,0 | 6.935 (−20 %) | 5 % | 0,00143 | 0,0099 | 0,0241 | −29 % |
T6-stale-docs, kurz · sehr spärliche Payload
| Arm | Perfekt | Prüfungen | Züge | Token in | Payload-Schnitt | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 4,0 | 19.821 | n/a | 0,00265 | 0,0256 | 0,0639 | n/a |
A | 100 % | 100 % | 3,0 | 18.468 (−7 %) | n/a | 0,00260 | 0,0246 | 0,0614 | −4 % |
B | 100 % | 100 % | 4,0 | 9.639 (−51 %) | 78 % | 0,00262 | 0,0139 | 0,0329 | −49 % |
D | 100 % | 100 % | 3,0 | 7.387 (−63 %) | 84 % | 0,00235 | 0,0109 | 0,0252 | −61 % |
T7-postmortem, sehr lang · gemischte Payload
| Arm | Perfekt | Prüfungen | Züge | Token in | Payload-Schnitt | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 6,0 | 21.294 | n/a | 0,00406 | 0,0363 | 0,0906 | n/a |
A | 100 % | 100 % | 5,3 | 19.224 (−10 %) | n/a | 0,00339 | 0,0297 | 0,0743 | −18 % |
B | 100 % | 100 % | 5,7 | 17.064 (−20 %) | 34 % | 0,00488 | 0,0343 | 0,0841 | −7 % |
D | 100 % | 100 % | 5,7 | 19.430 (−9 %) | 33 % | 0,00472 | 0,0324 | 0,0792 | −13 % |
T8-lookup, ein Aufruf · spärliche Payload
| Arm | Perfekt | Prüfungen | Züge | Token in | Payload-Schnitt | $ Luna | $ Sonnet 5 | $ Opus 5 | vs 0 |
|---|---|---|---|---|---|---|---|---|---|
0 | 100 % | 100 % | 2,2 | 3.314 | n/a | 0,00036 | 0,0033 | 0,0083 | n/a |
A | 100 % | 100 % | 2,0 | 3.004 (−9 %) | n/a | 0,00038 | 0,0030 | 0,0073 | −12 % |
B | 100 % | 100 % | 2,2 | 3.080 (−7 %) | 62 % | 0,00047 | 0,0026 | 0,0062 | −24 % |
D | 100 % | 100 % | 2,0 | 2.819 (−15 %) | 62 % | 0,00056 | 0,0029 | 0,0068 | −17 % |
Wie die Preise berechnet wurden
Einmal messen, dann neu bepreisen. Die Token-Zahlen sind die Basis, und die Rechnung jedes Modells basiert auf diesen Zahlen zu den jeweiligen Tarifen.
Die Abrechnungsformel wurde aus den Daten rückwärts entwickelt, anstatt sie vorauszusetzen. Über alle 192 Durchläufe hinweg stimmt die beobachtete Agenten-Kostenrechnung mit
frischer_input × 0,25 $/M + cached_input × 0,02 $/M + output × 1,20 $/Mbei einem medianen relativen Fehler von 0,04 % überein. Zwei Konsequenzen daraus: Prompt-Caching war die ganze Zeit automatisch aktiv, ohne cache_control-Marker, und 80 % der Input-Token waren Cache-Reads. Zudem wird jeder frische Input-Token zum Cache-Write-Tarif abgerechnet, welcher das 1,25-fache des nominalen Input-Preises beträgt, sodass der nominale 0,20 $/M-Satz in einer Multi-Turn-Schleife faktisch nie das ist, was man bezahlt.
Ein früheres theoretisches Modell des Cachings, bei dem Reads in Zug t dem Präfix in Zug t−1 entsprechen, unterschätzte die realen Cache-Reads um 19 %. Es wurde zugunsten der gemessenen Aufteilung pro Zug verworfen.
| Modell | Input | Output | Cache-Read | Cache-Write |
|---|---|---|---|---|
openai/gpt-5.6-luna | 0,20 $/M | 1,20 $/M | 0,02 $/M | 0,25 $/M |
anthropic/claude-sonnet-5 | 2,00 $/M | 10,00 $/M | 0,20 $/M | 2,50 $/M |
anthropic/claude-opus-5 | 5,00 $/M | 25,00 $/M | 0,50 $/M | 6,25 $/M |
typesafe/jev-1.13 | 0,042 $/M | kostenlos | n/a | n/a |
| Arm | Luna | Sonnet 5 | Opus 5 | Jev-Anteil, Opus 5 |
|---|---|---|---|---|
0 | 0,00182 $ | 0,01676 $ | 0,04191 $ | n/a |
A | 0,00166 $ (−9 %) | 0,01479 $ (−12 %) | 0,03688 $ (−12 %) | 0 % |
B | 0,00232 $ (+27 %) | 0,01435 $ (−14 %) | 0,03466 $ (−17 %) | 2 % |
D | 0,00221 $ (+21 %) | 0,01253 $ (−25 %) | 0,02995 $ (−29 %) | 3 % |
Die gleichen Durchläufe ohne jegliches Caching als Referenz:
| Arm | Luna | Sonnet 5 | Opus 5 |
|---|---|---|---|
0 | 0,00348 $ | 0,03333 $ | 0,08332 $ |
A | 0,00316 $ | 0,02984 $ | 0,07450 $ |
B | 0,00368 $ | 0,02798 $ | 0,06874 $ |
D | 0,00356 $ | 0,02601 $ | 0,06362 $ |
Eine Annahme ist konservativ statt neutral. OpenAI cached automatisch und berechnet jeden frischen Input-Token zum Write-Tarif, was gemessen wurde. Anthropic-Caching ist Opt-in: nur Inhalte innerhalb eines cache_control-Breakpoints werden zum Write-Tarif abgerechnet, der Rest zum normalen Input-Tarif. Die Abrechnung aller frischen Token zum Write-Tarif übertreibt die Anthropic-Spalten daher leicht. Eine Neuberechnung mit frischen Token zum normalen Input-Tarif verschiebt den Opus 5-Schnitt von 0,04191 $ → 0,02995 $ (−29 %) auf 0,03823 $ → 0,02808 $ (−27 %), und kein Einzelwert pro Aufgabe verschiebt sich um mehr als 3 Punkte.
Was dies nicht zeigt
- Ein Agenten-Modell. Alles wurde an
openai/gpt-5.6-lunamit Standard-Reasoning gemessen. Die Token-Zahlen sind das Lieferbare, und die Preisspalten sind Arithmetik darauf. Ein anderes Modell würde andere Token-Zahlen produzieren, nicht nur andere Preise. - n = 6 pro Zelle. Genug für Zug-Zahlen und Token-Zahlen, die nahezu deterministisch sind. Nicht genug, um 92 % von 96 % Qualität zu trennen.
- Fixtures, keine Live-APIs. Die Payload-Formen sind getreu. Echte Endpoints haben Pagination, partielle Fehler und Rate-Limits, die dieses Harness nicht prüft.
- Die Aufgaben wurden von derselben Person geschrieben wie die Skills. Die Bewertung ist deterministisch, aber die Welt ist nicht adversariell.
- Jevs eigene Kalibrierung wurde nicht auditiert. Gemessen wurde, was seine Scores mit einem Agenten machen, nicht ob sie im statistischen Sinne gut kalibriert sind.
- Eine Agenten-Struktur. Eine
while-Schleife mit Function Calling. Sub-Agenten, parallele Tool-Aufrufe und langlebige Sessions ändern die Arithmetik.