

CSV-Import-Mapping mit einem einzigen Modellaufruf (Jev)
- Die Frage
- Wie viel eines CSV-Spaltenmappings kann im Code erledigt werden, und kann ein einziger Modellaufruf alles andere handhaben?
- Ergebnis
- Striktes Matching erledigt bis zu 7 von 10 Spalten kostenlos, und ein Aufruf bewertet jedes verbleibende Paar in unter 700 ms für einen Zehntel-Cent.
Was ich herausfinden wollte
Jedes Produkt, das CSV-Importe unterstützt, hat diesen Bildschirm. Der Nutzer lädt eine Datei hoch, und etwas muss entscheiden, dass dessen Lineitem sku Ihr sku entspricht.
Man könnte dies bereits mit einem kleinen LLM tun, und es funktionierte einigermaßen gut. Das Ergebnis war jedoch ein String, dem man vertrauen musste, nach einer Wartezeit, die der Nutzer spürte. Ich wollte wissen, ob derselbe Job in drei Teile gesplittet werden kann: einfacher Code erledigt alles, was er korrekt lösen kann, ein Modell wird einmalig für den gesamten Rest gefragt, und die Entscheidung wird zurück in den Code geholt, wo ich sie einsehen und ändern kann.
Jev macht den mittleren Teil günstig. Es schreibt keinen Text, es beantwortet Fragen, die mein Code definiert, und gibt eine Wahrscheinlichkeit für jede zurück. Die Frage ist also nicht wirklich, ob ein Modell Spalten mappen kann, sondern wie viel der Arbeit das Modell gar nicht benötigt und ob ein Aufruf den Rest bewältigen kann.
Wie getestet wurde
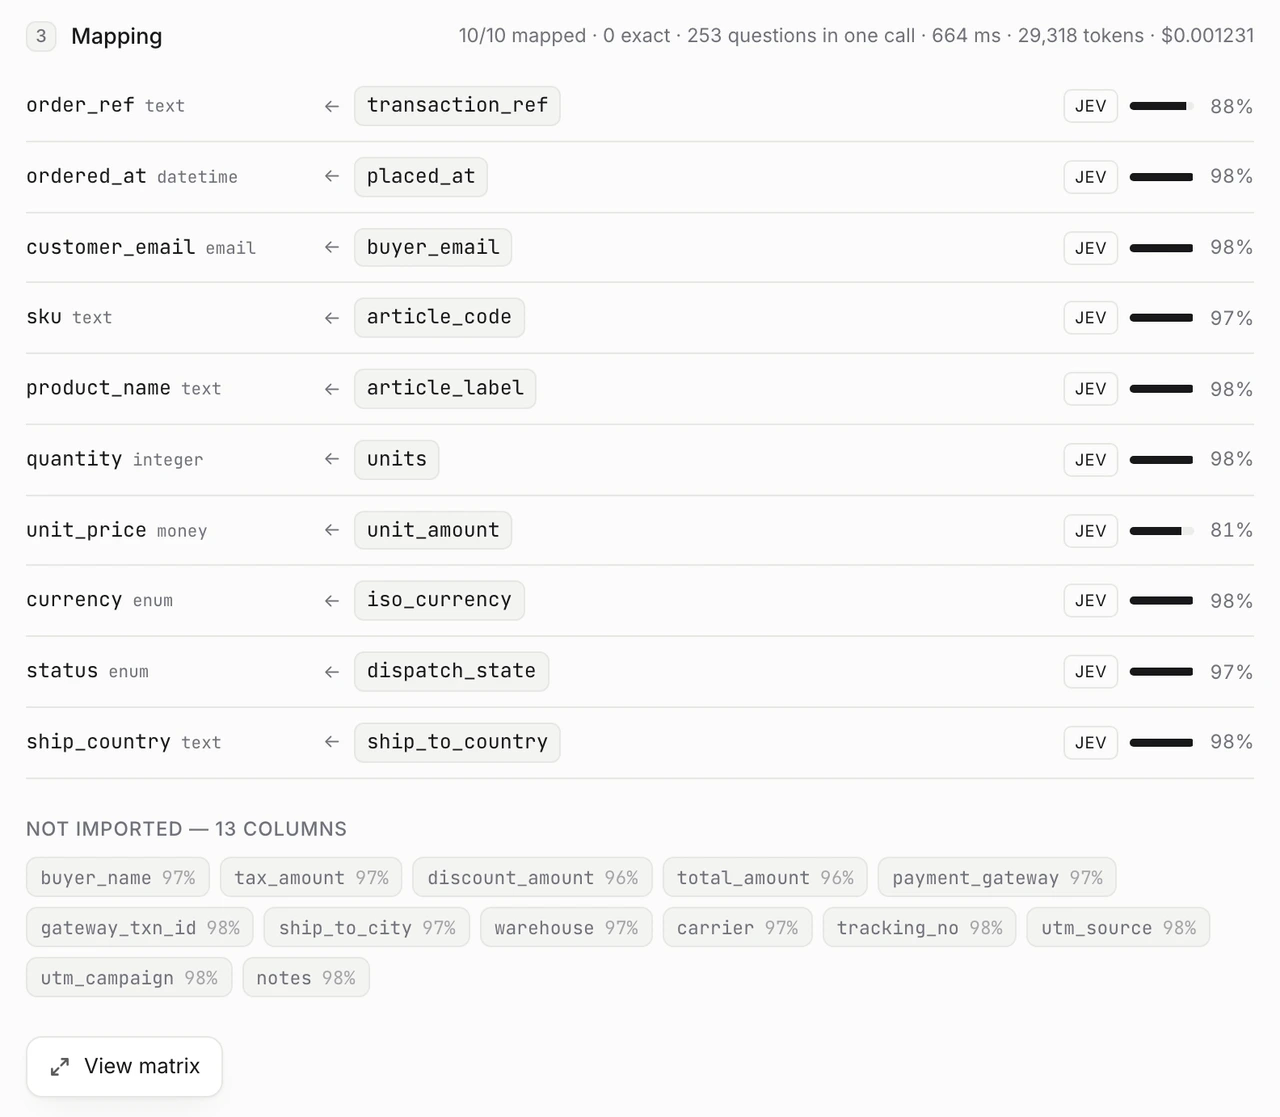
Drei Zieltabellen mit jeweils zehn Spalten und neun Beispiel-CSVs, die eher nach schwierigen als nach einfachen Fällen ausgewählt wurden: ein sauberer HubSpot-Export, eine Datei vollständig auf Französisch mit zwei verschiedenen E-Mail-Spalten, ein Shopify-Export, bei dem Name die Bestellnummer ist, und ein Lager-Export mit 23 Spalten, von denen 13 nirgendwo hingehören.
Jede Zielspalte hat eine einzeilige Beschreibung, und diese Beschreibung ist keine Dekoration. Sie ist das, was zwei benachbarte Felder voneinander trennt.
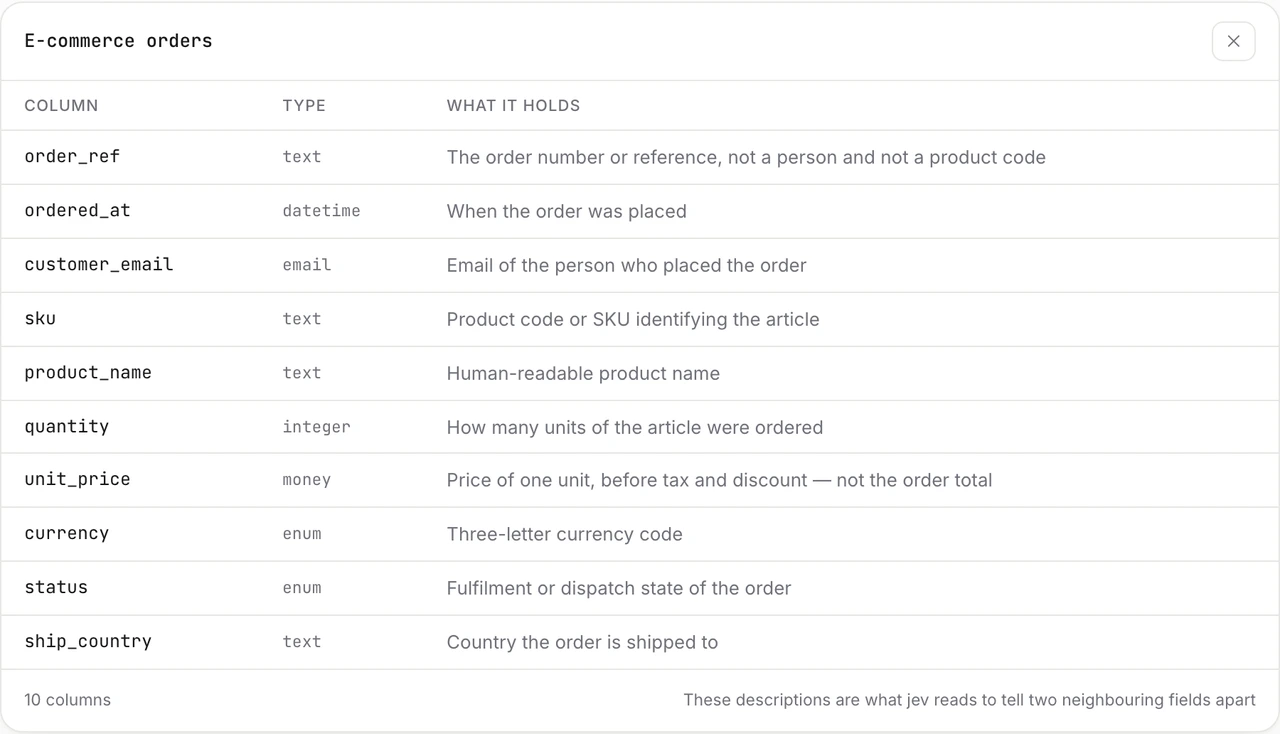
Der Durchlauf selbst besteht aus drei Stufen, wobei nur die mittlere ein Modell ist.
Stufe 1 · im Code, kostenlos und sofort
Stufe 2 · ein Aufruf, jedes verbleibende Paar gleichzeitig
Stufe 3 · wieder im Code
Die Form der Fragen ist die einzige Designentscheidung, über die es sich zu streiten lohnt. Pro eingehender Spalte eine Multiple-Choice-Frage zu stellen, wäre der offensichtliche Weg, aber es ist der falsche.
Eine Wahl pro eingehender SpalteDie offensichtliche Form
- Muss immer eines der Ziele wählen
- Wenn nichts passt, wird trotzdem etwas benannt, etwa 0,85
- Nichts in der Antwort sagt "keines davon"
Ein Ja/Nein pro Paar, plus ein GuardWas gebaut wurde
- Jedes Paar erhält eine eigene Zahl, unabhängig von anderen
- Eine Spalte kann überall niedrig scoren, was "nicht in dieser Tabelle" bedeutet
- Der Guard fragt direkt, ob es nirgendwo hingehört
Das Ergebnis
Alle neun Dateien wurden in einem einzigen Aufruf verarbeitet.
| Datei | Spalten | In Code geklärt | Fragen | Jev-Zeit | Kosten |
|---|---|---|---|---|---|
crm-hubspot-export.csv | 10 | 7 | 12 | 464 ms | $0.000077 |
hr-bamboo.csv | 8 | 5 | 18 | 374 ms | $0.000109 |
orders-minimal.csv | 5 | 0 | 55 | 409 ms | $0.000287 |
hr-payroll.csv | 10 | 2 | 72 | 484 ms | $0.000362 |
crm-eventbrite.csv | 7 | 0 | 77 | 514 ms | $0.000395 |
orders-shopify.csv | 10 | 1 | 90 | 437 ms | $0.000462 |
crm-french-crm.csv | 10 | 0 | 110 | 495 ms | $0.000549 |
hr-identity-provider.csv | 12 | 0 | 132 | 474 ms | $0.000658 |
orders-warehouse-export.csv | 23 | 0 | 253 | 675 ms | $0.001231 |
Die Kosten für die Fragen sind 21-mal höher als die Wartezeit, steigen aber nur um das 1,45-fache. Zwölf Fragen benötigen 464 ms, 253 Fragen 675 ms. Auf dieser Eigenschaft basiert das gesamte Design: Wäre jede Frage ein eigener Aufruf, würde die Warehouse-Datei zwei Minuten statt zwei Drittel einer Sekunde dauern, und die Matrix wäre unbrauchbar.
Beim HubSpot-Export erreichen 7 der 10 Spalten das Modell überhaupt nicht. Dieser Teil ist kostenlos, sofortig und kann nicht falsch sein.
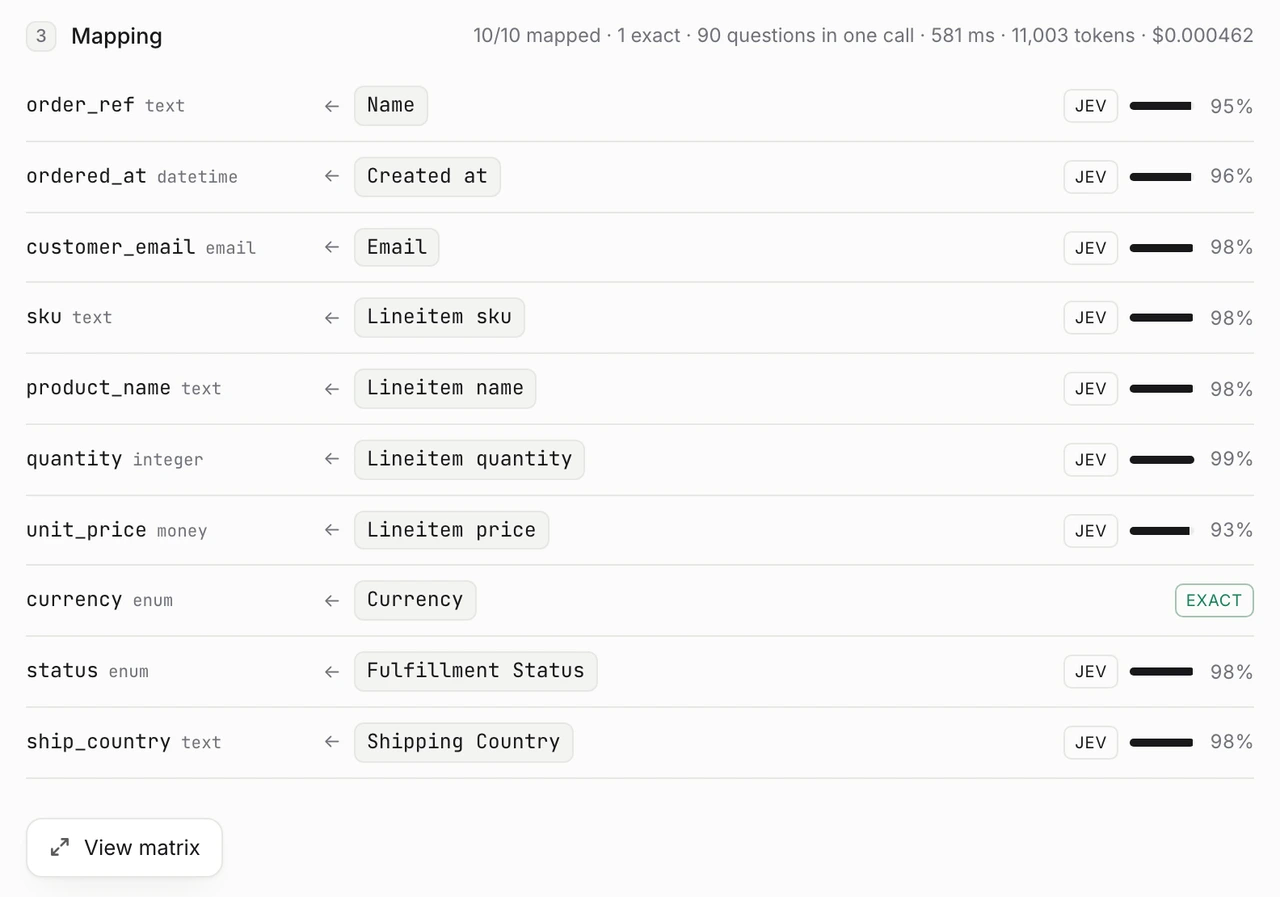
Die Beispielwerte erledigen den Großteil der Arbeit. Jede Spalte wird mit drei ihrer Werte gesendet, gekürzt auf die ersten und letzten 100 Zeichen. Das signalisiert dem Modell, dass Shopifys Name eine Bestellreferenz ist, und ist der Grund, warum derselbe Spaltenname unterschiedlich zugeordnet wird, je nachdem, was darunter steht.
Ein Aufruf, und dann gehören alle Zahlen Ihnen
Der Aufruf gibt die gesamte Matrix zurück, nicht eine einzelne Entscheidung. Das Öffnen der Matrix ist die klarste Darstellung dessen, was tatsächlich passiert ist.
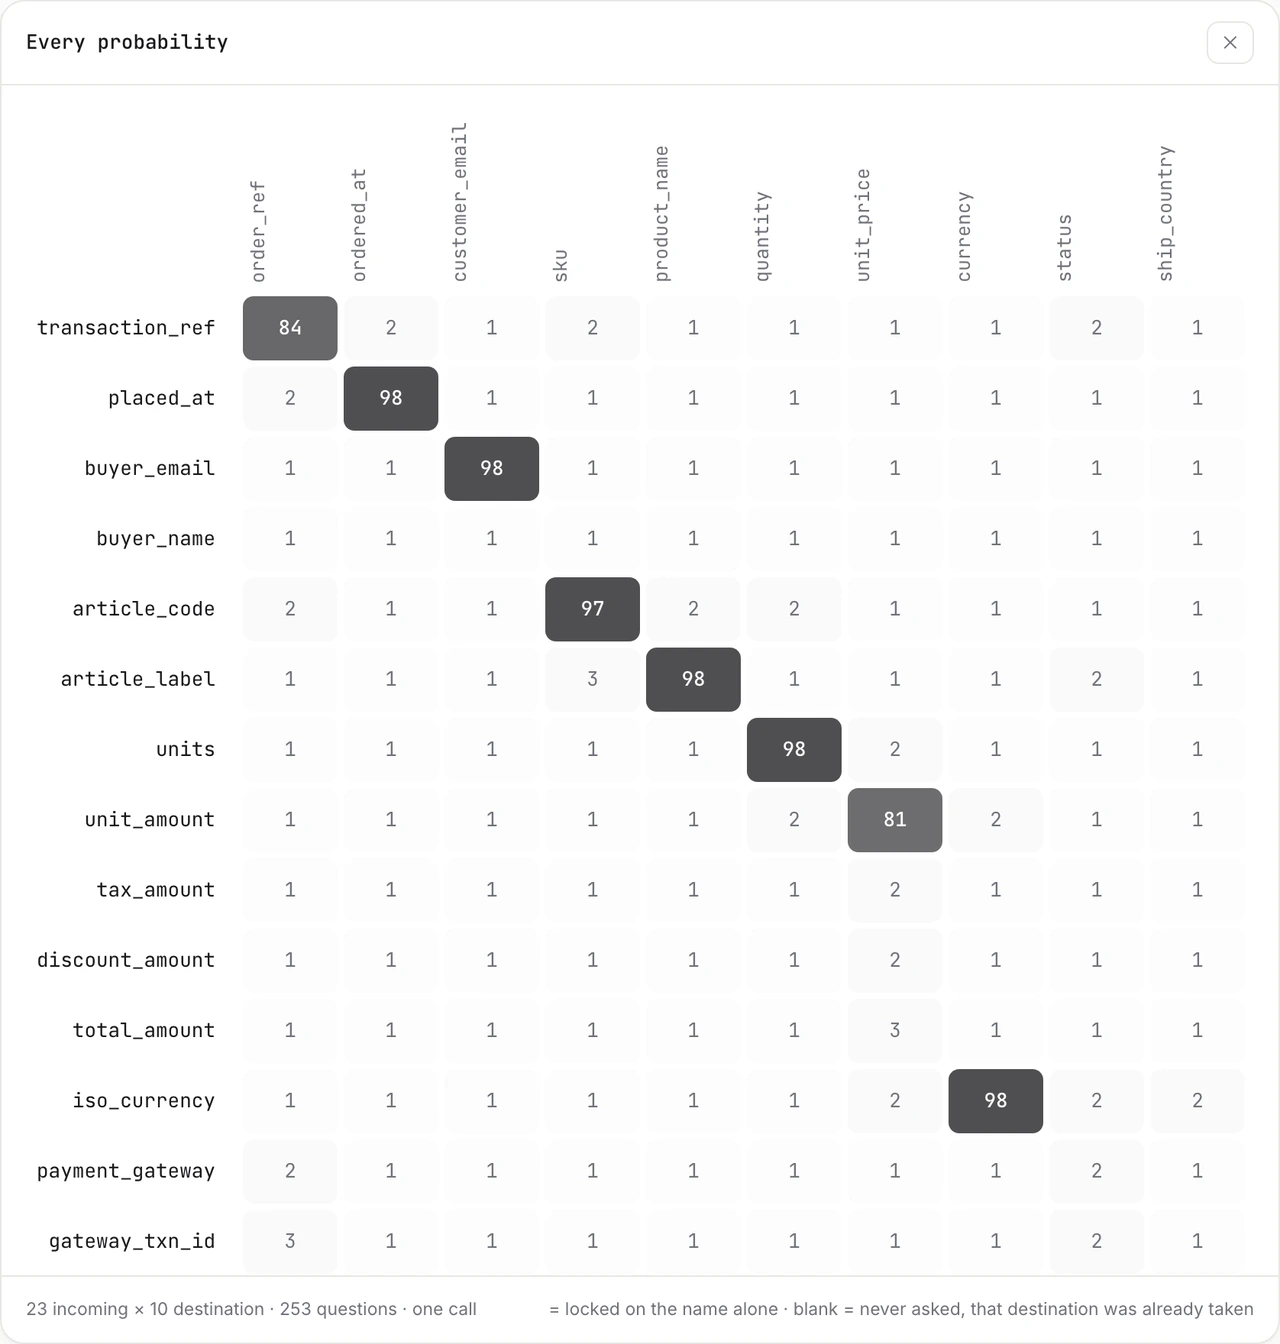
Da der Code jeden Wert enthält, ist der Schwellenwert eine Konstante, die ich verschieben kann, statt eines Verhaltens, das ich per Prompt erzwingen muss. Bei 0,75 bildet der Warehouse-Export alle zehn Ziele ab und verwirft die richtigen dreizehn Spalten.
Wo es zurückgegeben wird
Die Eventbrite-Datei ist diejenige, die das Modell nicht abschließen kann, und genau das macht diesen Bildschirm interessant.
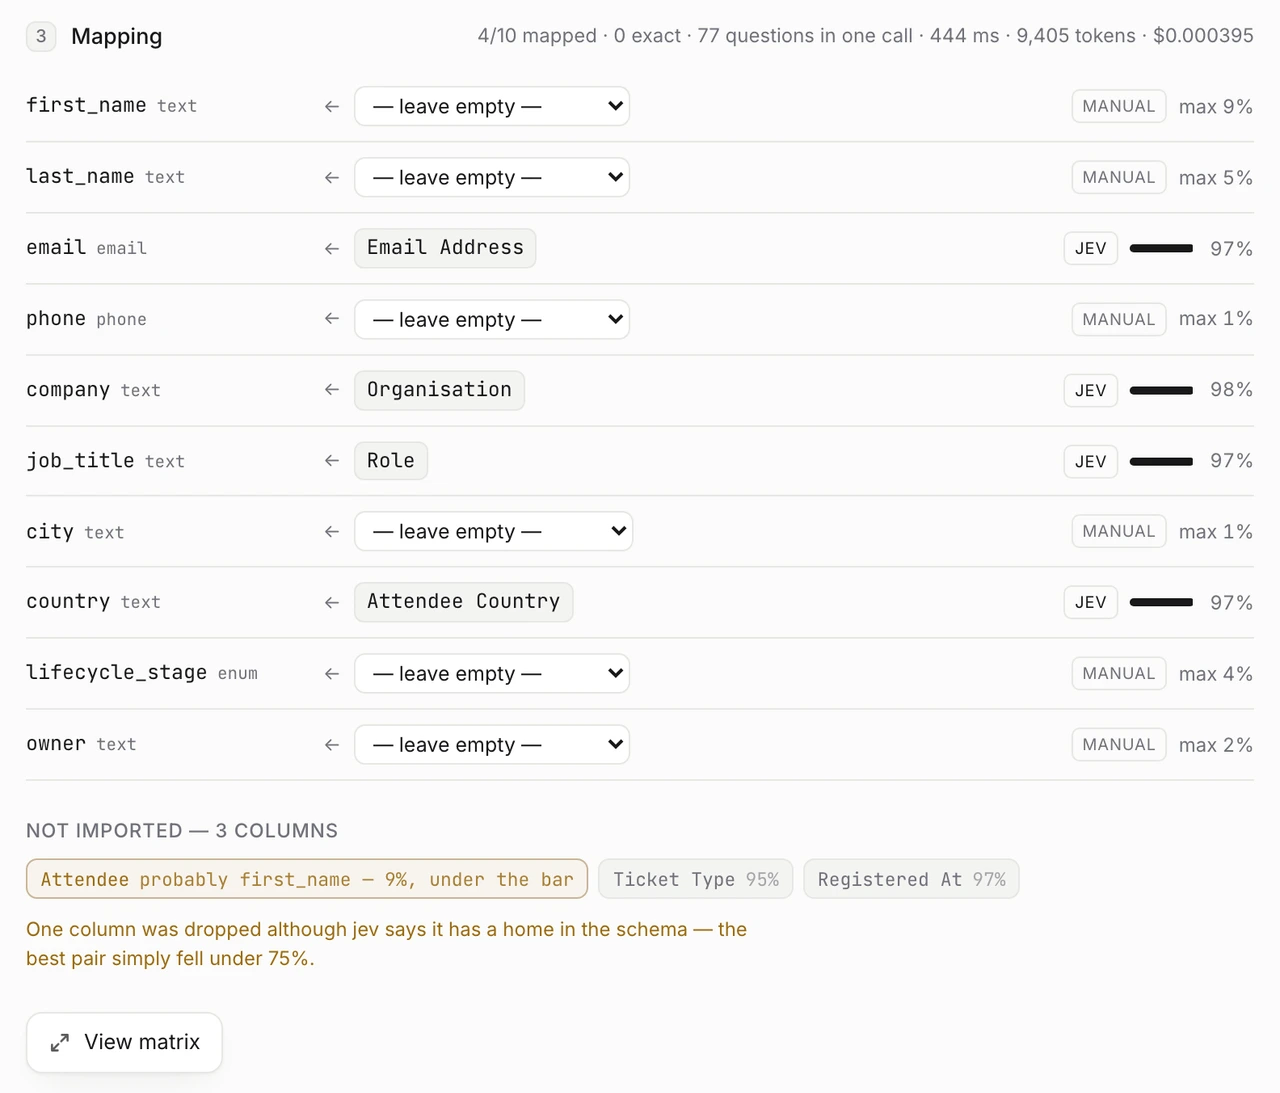
Die Guard-Frage hat ihren Platz am unteren Ende dieses Bildschirms. Attendee erzielt 9 % bei “gehört dies nirgendwo hin”, das heißt, das Modell sagt, dass es einen Platz hat, aber das beste Paar lag unter 0,75. Die Benutzeroberfläche markiert dies gelb, anstatt es stillschweigend zu verwerfen. Ticket Type mit 95 % und Registered At mit 97 % werden ohne Kommentar verworfen, da sie tatsächlich nirgendwo hingehören.
Was ich daraus ziehe
Erledigen Sie den deterministischen Teil und nichts weiter als den deterministischen Teil. Die erste Version normalisierte Groß-/Kleinschreibung, Akzente und Trennzeichen und enthielt zudem eine kleine Alias-Tabelle: attendeecountry zu country, site zu location, team zu department. Das sind Urteile, die sich als Normalisierung tarnen, und sie führen doppelt zu Fehlern. Eine Datei, die sowohl Attendee Country als auch Company Country enthält, erzeugt zwei exakte Treffer für ein Ziel, und der Code sperrt stillschweigend den Wert, der in der Spaltenreihenfolge zuerst kam. Und team ist nicht department, sondern eine Frage. Das Entfernen der Aliase ließ das Problem verschwinden, anstatt mich zur Schiedsrichterrolle zu zwingen, da nun keine Spalte mehr exakt passt und das Modell sie anhand ihrer Werte trennt.
Einmal fragen, danach entscheiden. Ein Aufruf liefert 253 kalibrierte Zahlen in 675 ms, und alles danach ist Arithmetik, die ich nachvollziehen kann: der Schwellenwert, die Reihenfolge der Auflösung, was als Warnung zählt. Nichts am Ergebnis hängt davon ab, dass ein Modell dazu überredet wurde, sich so zu verhalten. Das Verschieben der Grenze von 0,75 auf 0,80 ist eine Konstante, kein Prompt.
Eine Wahrscheinlichkeit ist es wert, gezeigt zu werden. Da die Zahl ohnehin existiert, gibt die Benutzeroberfläche sie aus, und eine Zuordnung mit 81 % wirkt anders als eine mit 98 %. Das Modell führt einen Vorlauf durch, trifft aber nicht die Entscheidung: Der Nutzer sieht, wie sicher es sich war, bei welcher Spalte, und übernimmt die Kontrolle über die wichtigen Fälle. Das ist ein besseres Angebot als ein selbstbewusstes Dropdown ohne Zahlenwert.
Dies wurde mit neun Dateien getestet, jeweils mit drei Tabellen und zehn Zielspalten. Ein Schema mit 40 Spalten würde mehr als einen Aufruf erfordern, und das zweite Budget im Kontextfenster von jev wird nicht aufgeteilt. Somit ist eine sehr breite Zieltabelle ein echtes Limit und kein bloßer Performance-Einbruch. Ich habe es nicht ausprobiert.