

Die meisten KI-Agenten sollten keine Agenten sein
Als Agenten in n8n eingeführt wurden, habe ich viele davon gebaut. Man fügt einen Agenten-Knoten ein, hängt drei Tools daran und lässt ihn entscheiden, welches er aufrufen soll. Es fühlte sich an, als wäre plötzlich alles ganz einfach geworden.
In den folgenden Monaten habe ich die meisten davon wieder entfernt. In den Workflows, die skalieren und wirklich produktiv laufen mussten, ist nur noch etwa ein Fünftel der Agenten übrig, die ich zuvor hatte.
Nicht, weil Agenten schlecht sind. Sondern weil der Agent bei den meisten meiner Aufgaben zur Laufzeit Dinge entschied, die ich schon beim Aufbau wusste, und mich dafür bei jeder einzelnen Interaktion zur Kasse bat.
Das Beispiel, das ich mir vornehme
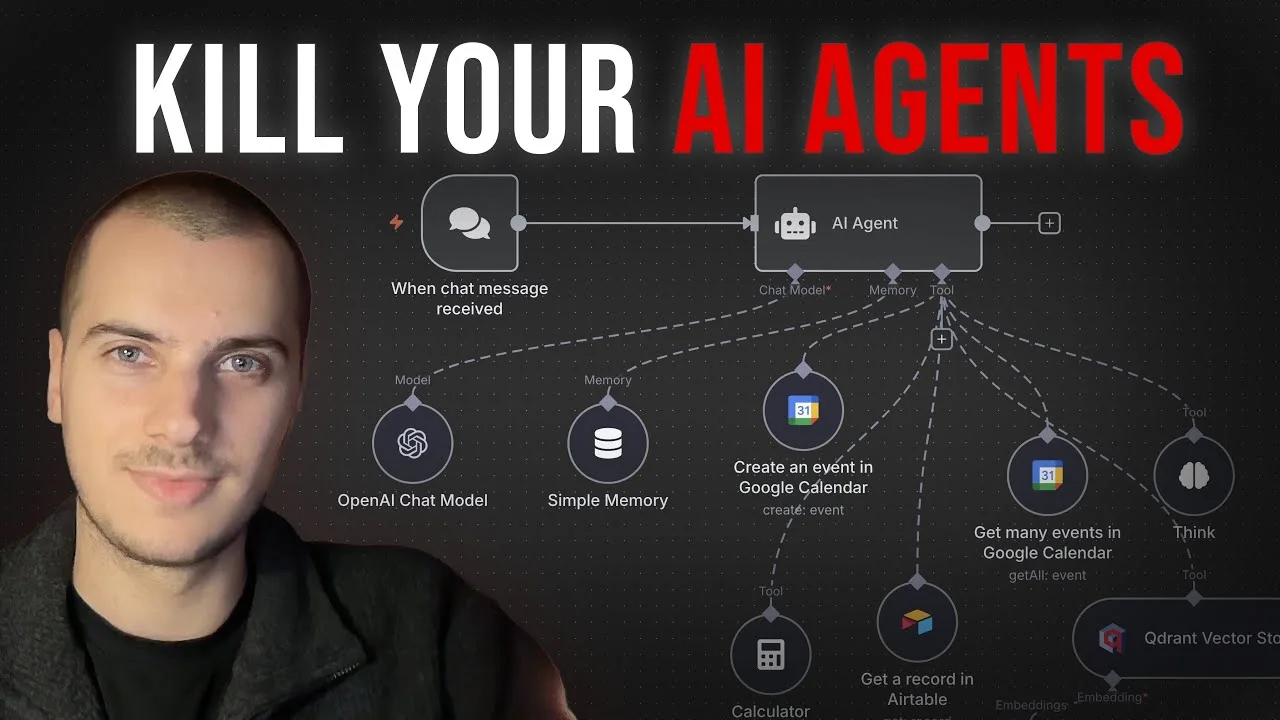
Ein Support-Chatbot. Chat-Trigger, ein Agent mit einem großen Modell und ein Tool: eine HTTP-Anfrage an einen Retrieval-Endpunkt, der Fragen zu meinen Dokumenten beantwortet. Jemand fragt nach dem Produkt, der Agent ruft das Tool auf, liest das Ergebnis und formuliert eine Antwort.
KI-Wissensagent
- Bei empfangener Chatnachricht
- KI-Wissensagentgpt-4.1ChatmodellOpenAI-Chatmodellgpt-4.1GedächtnisEinfaches GedächtnisToolWissensdatenbank abfragenHTTP-Anfrage. Der Agent formuliert die Abfrage und entscheidet, wann er sie aufruft
Jemand sagt Hallo, und es kostet dich ein Spitzenmodell
Schick diesem Agenten ein „Hi“. Nach etwa 1.3 Sekunden erhältst du eine freundliche Antwort, verfasst von einem der größten verfügbaren Modelle.
Es wurde kein Tool aufgerufen. Es wurden keine Informationen abgerufen. Der gesamte System-Prompt ging als Eingabe ein, einschließlich jeder Zeile zu Tools, die überhaupt nicht verwendet wurden.
- Die Nachricht kommt an"hi"1 Token
- Der vollständige System-Prompt wird übermitteltJede Tool-Beschreibung, jede Regel dazu, wann welches Tool aufgerufen werden sollalles
- Das große Modell entscheidetEs entscheidet, nichts aufzurufen
- Das große Modell antwortet"Hey, wie kann ich dir heute helfen?"
Die Begrüßung ist ein leicht nachvollziehbares Beispiel, aber kein seltener Fall. Bei einem Chatbot braucht ein großer Teil der Nachrichten weder einen Informationsabruf noch eine Suche.
Dasselbe, nur ausgeschrieben
Hier ist der Ersatz. Es sind mehr Knoten, und jeder davon steht für eine Entscheidung, die ich einmal getroffen habe, statt für eine, die ein Modell bei jeder Nachricht trifft.
Intelligenter und effizienter RAG-Chatbot
- Wenn eine Chatnachricht eingeht
- Frühere Nachrichten abrufenSpeicherverwalter, LademodusMemoryEinfacher Speicher
- Absichts-RouterTextklassifizierer, zwei KategorienChat ModelSehr kleines Modellgpt-4.1-nano
kein Wissensabruf nötig
- Einfache AntwortEinfache LLM-Kette mit demselben winzigen Modell
Wissensabruf nötig
- Suchanfrage vorbereitenEinfache LLM-Kette, gpt-4.1-mini
- RAG über LookioEinfache HTTP-Anfrage. In diesem Schritt kommt überhaupt kein Modell zum Einsatz
- Abschließende Antwort formulierenEinfache LLM-Kette, gpt-4.1. Das einzige große Modell auf der Arbeitsfläche
- Auf Chat antworten
- Nachrichten speichernSpeicherverwalter, Einfügemodus
Erst weiterleiten, mit einem kostenlosen Modell
Die einzige Aufgabe des Textklassifizierers ist zu entscheiden, welchen Pfad die Nachricht nimmt. Zwei Kategorien, jeweils mit einer Beschreibung:
- Kein Wissensabruf nötig. Begrüßungen, Bestätigungen, Small Talk. Alles, was sich ohne Nachschlagen beantworten lässt.
- Wissensabruf nötig. Für die Antwort braucht die Nachricht Informationen aus den Dokumenten.
Klassifizieren ist eine einfache Aufgabe, für die ein kleines Modell bestens geeignet ist. Es ist schnell genug, dass der Schritt bei der Gesamtlatenz kaum ins Gewicht fällt, und günstig genug, dass ich mir darüber keine Gedanken mehr mache.
Der günstige Pfad ist eine einfache LLM-Kette mit demselben winzigen Modell und einem kurzen System-Prompt. Auf „Hi“ kommt jetzt nach etwa zwei Sekunden eine Antwort, die genauso klingt, mit einem Modell, dessen Kosten pro Token nur einen Bruchteil des ersetzten Modells betragen.
Ein Modellknoten versorgt sowohl den Router als auch die einfache Antwort. Das sind unterschiedliche Aufgaben, aber sie sind ähnlich anspruchsvoll. Wenn ich das Modell an einer Stelle ändern kann, probiere ich tatsächlich ab und zu ein anderes aus, statt zwei Knoten anzupassen und den zweiten zu vergessen.
Denselben Ansatz nutze ich für die Chat-Seitenleiste: Gesprächstitel nach einem Zeitplan mit einem kleinen Modell generieren, statt bei jeder Nachricht einen Titel generieren zu lassen.
Den Trigger so einstellen, dass ein Knoten antwortet
Eine Kleinigkeit, die das ganze Konzept blockiert, wenn man sie übersieht. Ein Chat-Trigger antwortet standardmäßig über den letzten Knoten, aber in diesem Workflow gibt es zwei Pfade, die beide antworten müssen.
Stelle den Antwortmodus des Triggers auf „Von einem Knoten antworten“ und setze dann einen Auf Chat antworten-Knoten an die Stelle, an der die Zweige zusammenlaufen. Ohne ihn können nicht sowohl der günstige als auch der teure Pfad eine Antwort liefern. Genau darum geht es bei der Weiterleitung.
Der Abrufpfad in drei Knoten
Sieh dir an, was der Agent bei einer echten Frage gemacht hat. Das große Modell wurde aufgerufen, brauchte 600ms und entschied, das Tool aufzurufen. Gute Entscheidung. Aber das Ergebnis all dieser Intelligenz ist eine kurze Anfragezeichenfolge, im Wesentlichen eine bereinigte Version dessen, was der Nutzer gerade eingegeben hat. Und dafür wurde der gesamte System-Prompt erneut übermittelt.
Aufgaben im DurchlaufAlle mit dem großen Modell
- Entscheiden, dass ein Abruf nötig ist
- Eine kurze Suchanfrage formulieren
- Aus den abgerufenen Informationen die endgültige Antwort verfassen
Was die jeweilige Aufgabe brauchtBei Auswahl pro Schritt
- Einen Klassifizierer, winziges Modell
- Eine Umformulierung, kleines Modell
- Ein großes Modell, das sich hier bewährt
Der Pfad besteht also aus drei Knoten statt aus einem Agenten.
Suchanfrage vorbereiten ist eine einfache LLM-Kette mit einem Mini-Modell. Der System-Prompt lautet: Formuliere aus der Nutzernachricht eine kurze, prägnante Anfrage für das Wissensabruf-Tool und gib sie direkt als Frage aus. In meinen Tests formulierte das kleine Modell dieselbe Anfrage wie das große.
RAG über Lookio ist eine einfache HTTP-Anfrage. Die Anfrage steht im Body, die Assistant-ID und der Modus sind feste Werte, die ich selbst festgelegt habe, statt Parameter, die ein Modell verändern könnte. Die meisten Tools, die man an einen Agenten anhängt, sind im Hintergrund APIs, und die Plattform stellt normalerweise den passenden Knoten bereit, den man direkt einfügen kann.
„Finale Antwort verfassen“ erhält die ursprüngliche Nachricht und die abgerufenen Inhalte mit Kennzeichnung und formuliert die Antwort. Dieser Schritt bleibt beim großen Modell, denn an der Formulierung der endgültigen Antwort zeigt sich die Qualität.
Den Speicher musst du jetzt selbst verwalten
Das ist der Teil, den der Agent für dich übernommen hat und den du nun selbst wieder einbauen musst.
Ein Agentenknoten übernimmt einen Speicher-Unterknoten und verwaltet ihn. Wenn du den Agenten in einzelne Schritte aufteilst, fällt diese Funktion weg. Deshalb wird der Gesprächsverlauf einmal am Anfang geladen und einmal am Ende gespeichert.
- Frühere Nachrichten findenSpeicherverwaltung im Lademodus, direkt nach dem Auslösereinmal
- Jeder Prompt bekommt den VerlaufRouter, einfache Antwort und beide Abrufschritte erhalten jeweils den Gesprächsverlauf×4
- Auf den Chat antwortenDie Antwort geht zurück an den Nutzer
- Nachrichten speichernSpeicherverwaltung im Einfügemodus: die Nutzernachricht und die Antworteinmal
Das macht mehr Arbeit. Gleichzeitig fällt dir dabei auf, dass ein Agent den gesamten Gesprächsverlauf in jede einzelne Runde geschickt hat und ein Schritt zur Umformulierung der Anfrage die letzten zwei Nachrichten braucht, nicht die letzten zwanzig.
Was du dafür zurückbekommst
AgentEntscheidung zur Laufzeit
- Großes Modell bei jeder Runde, mit oder ohne Begrüßung
- System-Prompt und Tool-Beschreibungen bei jedem Aufruf
- Kann ein Tool überspringen und aus dem Gedächtnis antworten
- Kann die Reihenfolge ändern, und du erfährst es erst im Produktivbetrieb
Explizite SchritteEntscheidung beim Erstellen
- Großes Modell in einem von fünf Knoten
- Nirgendwo Tool-Beschreibungen
- Der Abruf läuft immer, weil er ein Schritt ist
- Die Reihenfolge entspricht genau deiner Skizze
Am wichtigsten ist für mich die dritte Zeile. Wenn ein Agent ein Tool überspringt und mit dem antwortet, was er gerade zu wissen glaubt, lässt sich dieser Fehler weder reproduzieren noch testen. Ein Workflow kann das nicht tun. Der Knoten ist da und wird ausgeführt.
Wann ich trotzdem zu einem Agenten greife
Wenn ich die Reihenfolge wirklich nicht kenne. Bei offener Recherche etwa, wenn die zweite Anfrage davon abhängt, was die erste ergeben hat. Oder wenn sich die Anzahl der Schritte nicht im Voraus bestimmen lässt.
Das ist inzwischen mein Prüfstein: Kann ich den Ablauf vor der Ausführung auf Papier skizzieren? Wenn ja, bezahle ich bei einem Agenten dafür, dass ein Modell meine Skizze bei jeder Anfrage neu herausfindet.
Dieselbe Frage, eine Ebene höher
Diese Denkweise lässt sich übertragen. Wenn ich mit Claude Code oder Codex arbeite, ähneln viele meiner Abläufe dem Support-Bot, und die kostspieligen Teile sind dieselben: Der gesamte Kontext wird erneut mitgeschickt, obwohl ein Schritt nur einen Bruchteil davon braucht, oder ein Modell findet etwas erneut heraus, das ich schon wusste.
Wenn du weißt, was ein Tool-Aufruf kostet, weil du einmal selbst einen eingerichtet und die Tokenzahl beobachtet hast, erkennst du, was in einem Harness passiert, das dir fast nichts zeigt.
Öffne deine eigenen Agenten und sieh dir die Ausführungen an. Frag dich bei jeder, ob du die Schritte vorab selbst hättest skizzieren können. Bei den meisten meiner Agenten hätte ich das gekonnt.