

So veröffentlicht man MCPs mit 10/10
Die meisten veröffentlichen einen MCP-Server so, wie sie früher eine REST-API veröffentlicht haben. Sie schreiben die Zod-Schemas, probieren zwei Prompts für den Erfolgsfall in Claude Desktop aus, sehen eine grüne Antwort und erklären die Arbeit für erledigt.
Dann tauchen echte Agents auf und quälen sich still damit herum.
Vor ein paar Wochen habe ich darüber geschrieben, wie man Agents ein Tool gibt, mit dem sie dir Feedback schicken können, wenn ihnen in der Produktion etwas unklar ist. Mit diesem einen Tool entdeckte ich Schemafehler, von denen ich durch menschliche Nutzer nie erfahren hätte. Als ich die Qualität dieser Berichte sah, lag der nächste Schritt auf der Hand: Warum warten, bis der Agent eines Kunden in der Produktion über meine Schnittstelle stolpert, wenn ich vor dem Release zwanzig neue Agents durch jeden Zugang schicken kann?
Das ist die ganze Methode, die ich jetzt verwende. Ich habe 94 End-to-End-Sitzungen mit Agents über den MCP-Server, die REST-API, die CLI und das SDK meines Produkts hinweg und mit mehreren Modellstufen durchgeführt, die dabei aufgedeckten Probleme behoben und das Testgerüst als agent-surface-tester als Open Source veröffentlicht.
Warum Agents besseres UX-Feedback liefern als Menschen
Ehrliches Feedback zu einem Produkt von menschlichen Entwicklern zu bekommen, ist schwierig. Wenn ein Entwickler auf einen umständlichen Endpunkt stößt, rät er einen Feldnamen, bekommt einen 400, überfliegt deine Doku, versteht die Eigenheit, baut einen Workaround ein und macht sich wieder an die eigene Arbeit. Oder er schließt den Tab und nimmt ein anderes Tool. So oder so erfährst du nichts.
Selbst wenn sich die seltene Person doch meldet, vergehen bis dahin zwei Tage. Sie gibt den Fehler aus dem Gedächtnis wieder, lässt die gesendete Nutzlast weg und formuliert die Kritik milder, weil niemand in einem Support-Ticket unhöflich klingen will.
Bei den Teilen deines Produkts, mit denen Agents interagieren, lässt sich von Agents viel leichter lernen.
Auf menschliche Entwickler wartenLangsam und gefiltert
- Schlechte Feldnamen stillschweigend umgehen
- Abspringen, ohne den Grund zu nennen
- Probleme Tage später aus dem Gedächtnis melden
- Kritik aus Höflichkeit abmildern
- Stunden für Nutzerinterviews aufwenden, um live zuzusehen
Agents zuhörenSofort und unverblümt
- Kein Ego und kein Höflichkeitsfilter
- Haben die genaue Nutzlast und Fehlermeldung noch vorliegen
- Sagen, welche Erwartungen dein Schema geweckt hat
- Alle 48 Tools bei Bedarf in zwei Minuten testen
- Eine komplette Produkttour kostet einen halben Cent
Einem Agent ist es egal, was du davon hältst. Er hat deine Toolbeschreibung gelesen, eine konkrete Erwartung entwickelt, JSON gesendet und wurde überrascht. Fragst du ihn, wo die Abweichung lag, erhältst du ein direktes Audit deiner Benennung, Fehlerantworten, Paginierung und fehlenden Beispiele.
Zwei Hälften derselben Schleife
Um einen MCP (und die dazugehörige API, CLI und das SDK) möglichst nah an 10/10 zu bringen, nutze ich zwei Kanäle, die sich gegenseitig ergänzen.
So bringst du eine Agent-Schnittstelle auf
10 von 10
Die erste Hälfte läuft passiv. Jeder MCP-Server, den ich entwickle, wird mit send_feedback ausgeliefert (beschrieben in meinem früheren Beitrag). Als ich Lookio für eine breitere Schnittstelle neu aufbaute (48 MCP-Tools, 46 REST-Endpunkte, 70 CLI-Befehle und ein TypeScript-SDK), rief die ChatGPT-Sitzung eines echten Nutzers send_feedback zwölfmal von sich aus während der normalen Arbeit auf.
Hier sind drei der Fehler, die mir diese eine Live-Sitzung aufdeckte:
- Ein unmögliches JSON-Schema. Bei
sync_sitemaphatte der Parameterinclude_unchangedtype: "boolean"und zugleichenum: ["true", "false"]. Die strikte Validierung wies sowohltrueals auch"true"zurück. Ein Mensch, der die Dokumentation nur überfliegt, bemerkt einen defekten Schemahinweis wie diesen nie. Ein MCP-Client läuft gleich beim ersten Aufruf gegen eine Wand. - Widersprüchliche Paginierung.
list_resourcesgabtruncated: falsezurück, obwohl zugleich einnext_offset-Cursor vorhanden war. Der Agent hielt an und stellte eine berechtigte Frage: Soll ich aufhören zu paginieren, weiltruncatedfalse ist, oder weitermachen, weilnext_offsetgesetzt ist? - Unbemerkter Datenverlust beim Neuindizieren. Beim Aufruf von
update_resource, um ein Dokument neu in Abschnitte aufzuteilen, wurde dessensource-URL stillschweigend gelöscht, sofern der Aufrufer nicht daran dachte, die alte URL erneut mitzusenden.
Kein Nutzer in diesem ChatGPT-Fenster hätte mir wegen irgendeines dieser Probleme eine E-Mail geschrieben. Der Agent umging, was sich umgehen ließ, legte im Hintergrund zwölf präzise Reproduktionsberichte an und erledigte die Aufgabe des Nutzers.
Warum dein Coding-Agent in Cursor den Test nicht ausführen kann
Wenn du solche Berichte siehst, willst du sie haben, bevor du etwas auslieferst. Der naheliegende Schritt ist, dein Repository in Claude Code oder Cursor zu öffnen und einzugeben: „Teste meinen MCP-Server und sag mir, was unklar ist.“
Das habe ich zuerst versucht. Dabei entgeht ihm die Hälfte der Fehler, denn dein Coding-Agent weiß bereits zu viel.
Fünf Minuten zuvor hat dieselbe Sitzung deine Routen-Handler, Zod-Validatoren und dein Datenbankschema gelesen. Wenn in llms.txt nicht steht, ob das Feld im Request-Body text oder content heißt, stolpert dein Coding-Agent nicht. Er erinnert sich an text aus deinem Quellcode. Der Test läuft fehlerfrei durch, du bist mit deiner Dokumentation zufrieden und der allererste externe Agent bekommt einen 400.
Ein echter Agent eines Nutzers kommt unvorbereitet dazu. Er hat Ihr Repository noch nie gesehen und erhält nur einen Zugang zu Ihrem Produkt:
- Ein MCP-Agent sieht nur Ihre
tools/list-Schemas und die Antworten der Tools. - Ein REST-API-Agent sieht nur einen HTTP-Client und Ihre öffentliche
llms.txt-Datei oder OpenAPI-Spezifikation. - Ein CLI-Agent sieht nur Ihre Binärdatei und
--help. - Ein SDK-Agent sieht nur die README Ihres Pakets und die exportierten Methoden.
Eine weitere Methode: Dein Coding-Agent steuert einen echten Browser mit ChatGPT
Dein Coding-Agent kann MCP nicht unvoreingenommen direkt im eigenen Terminal testen. Während der aktiven Feature-Entwicklung nutze ich aber ständig eine andere Methode: Der Coding-Agent steuert einen echten Browser mit ChatGPT.
Wenn ich ein MCP entwickle, das interaktive Karten oder Canvas-Widgets rendert, wie etwa den Website-Generator von Atelier201, öffne ich daneben ein Browserfenster und melde mich dort bei ChatGPT an. Dieses ChatGPT-Konto kann auf den lokalen MCP-Server zugreifen, aber die ChatGPT-Unterhaltung selbst hat keinerlei Kontext zum Repository. Sie hat meine Codebasis noch nie gesehen.
Mein Coding-Agent in Claude Code übernimmt die Teststeuerung:
- Er öffnet ChatGPT im Browserfenster und startet eine neue Unterhaltung.
- Er gibt echte Nutzeranfragen in ChatGPT ein, etwa die Bitte, eine Überschrift umzuschreiben oder ein Layout anzupassen.
- Er beobachtet, wie ChatGPT Tools aus dem MCP auswählt und die daraus resultierende UI-Karte im Browser angezeigt wird. Gleichzeitig liest er die lokalen Logs des Entwicklungsservers, um eingehende Payloads, Statuscodes und Latenzen in Echtzeit zu verfolgen.
- Wenn ChatGPT einen Parameter falsch interpretiert oder die Karte nicht aktualisiert wird, liest Claude Code den Fehler direkt in den Logs, passt den Servercode an und testet erneut im Browser.
- 1Im Browser Anweisungen gebenLäuft ohne Repository-Kontext
- 2ChatGPT ruft MCP aufFührt Tools aus und aktualisiert die Karte
- 3Server-Logs streamenÜberwacht Payloads, Latenzen und Fehler
- 4Code anpassen und Schleife startenBehebt Fehler und löst sofort einen erneuten Test aus
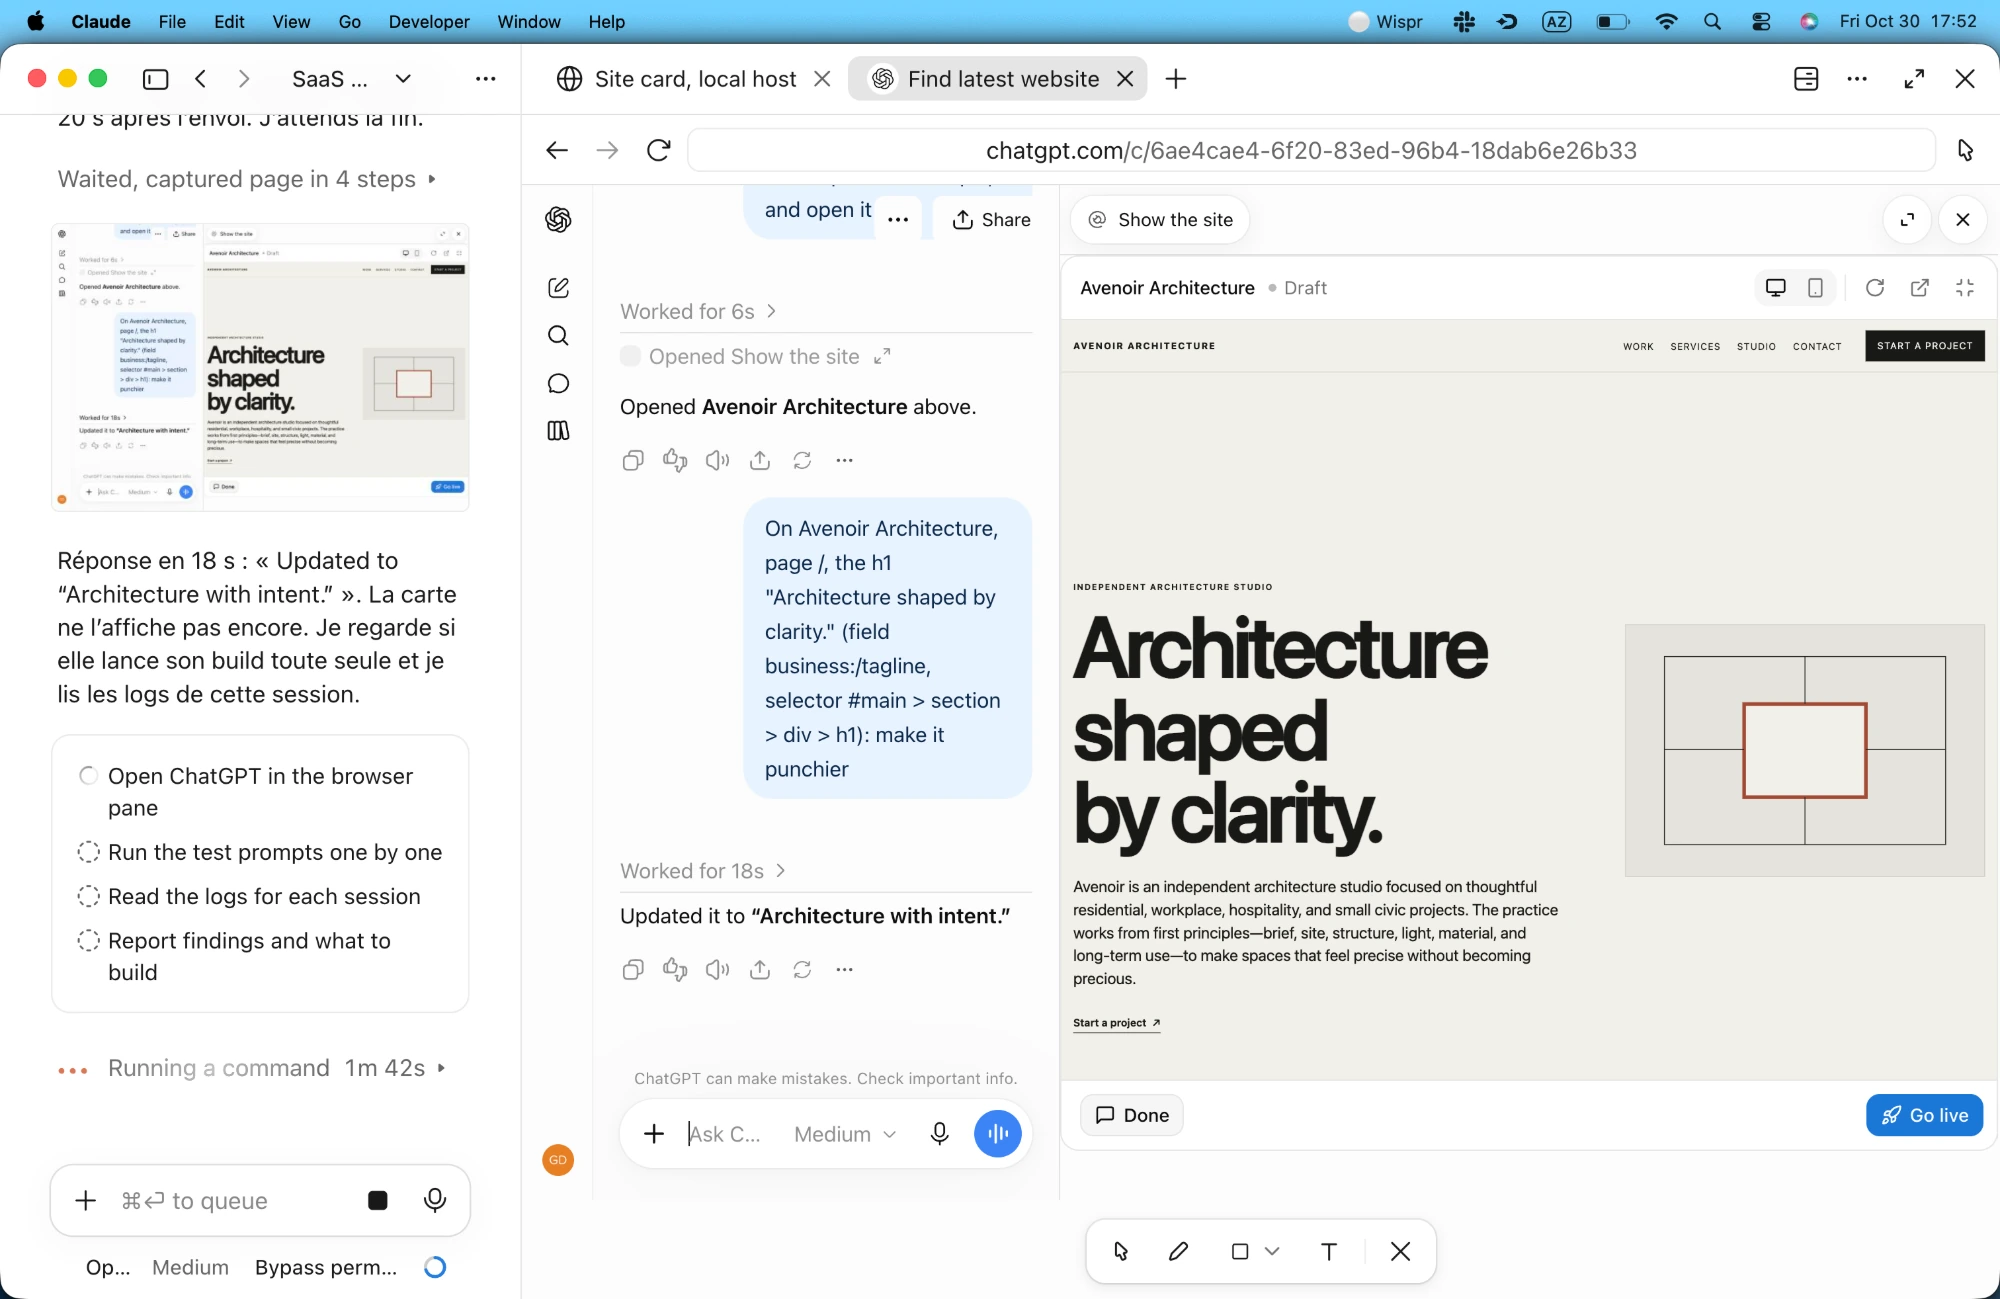
Diese interaktive Schleife ist während der aktiven Feature-Entwicklung äußerst nützlich. Du kannst in Echtzeit beobachten, wie ein echtes Nutzermodell mit deinem Server und deiner UI interagiert.
Für automatisierte Tests vor einem Release möchtest du allerdings kein Browserfenster öffnen und auf Tippanimationen warten. Du brauchst headless, wiederholbare Testläufe über alle Zugänge, die dein Produkt bietet. Deshalb habe ich agent-surface-tester entwickelt.
Was automatisierte Testläufe ohne Kontext über alle Schnittstellen aufdecken
Ich habe agent-surface-tester entwickelt, um dieses headless-Setup lokal auszuführen. Das Tool startet über OpenRouter isolierte Modelle ohne Workspace-Kontext, stellt jedem Testlauf genau einen Zugang (mcp, api, cli oder sdk) bereit, protokolliert jeden Tool-Aufruf und jede Latenz in JSON und bittet den Agenten am Ende um strukturierte Angaben zu UX-Hürden.
So sieht ein einzelner API-Testlauf aus, wenn ein frisches Modell auf einen unzureichend dokumentierten Endpunkt trifft:
POST /v1/resources/text - Create a text resource...{ "title": "FAQ", "content": "Refunds take 5 days." }400 { "error": "expected string, received undefined" }{ "title": "FAQ", "text": "Refunds take 5 days." }201 { "id": "res_8f2a", "status": "indexing" }- 1Kein Zugriff aufs Repository
Das Modell erhält nur die URL der öffentlichen Dokumentation, die Sie ihm geben. Es kann nicht in Ihre TypeScript-Typen schauen.
- 2Zwei UX-Probleme in einem Aufruf
In llms.txt fehlte ein JSON-Beispiel für den Request-Body, und der 400-Fehler nannte die fehlende Eigenschaft „text“ nicht.
- 3Konkrete Diagnose
Mit einem dreizeiligen Request-Beispiel und dem Feldpfad in Validierungsfehlern sank die Zahl der API-Tour-Fehler von 9 auf 0.
In acht Testkampagnen für Lookio V2 habe ich 89 Sitzungen mit sieben Modellfamilien durchgeführt (Claude, GPT, Gemini, Grok, Qwen, MiniMax und Kimi). Derselbe Produkttest über alle vier Zugänge nebeneinander deckte Fehler auf, die Unit-Tests nie finden:
- Leerer Text bei add_text_resourceSauberer Fehler 400 invalid_parameter in der REST-API, Absturz 500 internal_error bei MCPAbsturz mit 500
- Validierungsfehler ohne FehlerhülleUngültige Zahlen gaben unverarbeitet "expected number, received NaN" außerhalb der Fehlerhülle zurück2 Endpunkte
- Nicht ausgewiesenes Limit von 3 Widgets im TarifBeim Erstellen eines 4. Widgets wurde feature_not_available statt eines Fehlers wegen des Mengenlimits zurückgegeben5 von 5 Durchläufen
- 163-KB-CLI-Hilfeausgabe und aufgeblähte Nutzungsdatenlookio help --json überschritt die stdout-Grenzen; get_usage lieferte seitenweise Tage ohne Aktivitäten163 KB auf 45 KB
- Erneuter Test nach Veröffentlichung der KorrekturenHTTP-Fehler im vollständigen lokalen API-Testlauf sanken von 9 auf 0; unverarbeitete Validierungsfehler sanken auf 00 Fehler
94 Agent-Testläufe über 4 Schnittstellen7 Modellfamilien
Der Fehler mit dem Tariflimit ist mein Lieblingsbeispiel für die Ehrlichkeit von Agenten. Unser Test-Workspace hatte im Tarif ein Limit von drei Widgets, das nirgends in den Workspace-Metadaten erwähnt wurde. Als fünf verschiedene Modelle beim Testen versuchten, ein viertes Widget zu erstellen, antwortete der Server mit feature_not_available. Jedes einzelne Modell schloss daraus, dass Widgets für das Konto deaktiviert waren, statt dass ein Limit von drei galt. Ein menschlicher Nutzer würde das sehen, annehmen, dass Widgets einen Enterprise-Tarif voraussetzen, und nie ein Upgrade durchführen. Fünf Agenten hintereinander wiesen direkt auf den irreführenden Fehlercode hin.
Was Tests von Agent-Schnittstellen über verschiedene Modellstufen hinweg kosten
Viele nehmen an, dass autonome Agent-Tests ein Unternehmensbudget erfordern. Über OpenRouter oder kompatible Gateways kostet ein umfassender Produkttestlauf mit 20 bis 50 Schritten in der Regel einen Bruchteil eines Cents bis ein paar Cents.
Die verschiedenen Modellstufen erfüllen in deinem Testablauf unterschiedliche Aufgaben:
- Schnelle Modelle in Flex-Tarifen (wie Gemini 3.8 Flash oder GPT-6 Luna, für weniger als einen Cent pro Testlauf) eignen sich ideal für kontinuierliche Regressionstests. Sie finden schnell Reibungspunkte an der Schnittstelle: defekte Endpunkte, Abweichungen im Schema und fehlende Dokumentationsbeispiele. Als wir Gemini 3.8 Flash mit Lookio testeten, stellte es fest, dass unser Assistenten-Suchendpunkt relevante Textpassagen zurückgab, aber keine numerischen Ähnlichkeits- oder Distanzwerte. So konnte ein Agent die Zuverlässigkeit eines Treffers nicht beurteilen, bevor er Credits für die Generierung ausgab.
- Frontier-Modelle mit Reasoning-Fähigkeiten (wie GPT-6.1 Terra in Flex-Tarifen, etwa ein bis zwei Cents pro Testlauf) testen die Grenzen von Richtlinien und Logik. In unseren Tests verwendete Terra automatisch flüchtige
store: false-Flags, damit Testanfragen die Logs nicht verunreinigten, prüfte Details zur Kreuzkontamination durch Allergene und Grenzfälle bei Bestellrichtlinien (10 gegenüber 11 Artikeln für eine Vorankündigung) und führte nach dem Löschen Verifizierungsanfragen durch, um die Bereinigung zu bestätigen.
Ein vollständiger Testlauf über dieselben drei Schnittstellen mit demselben Modell ermöglicht außerdem eine genaue Messung des Protokoll-Overheads:
Kosten einer vollständigen Lookio-Produkttour je Schnittstelle
Ein Testlauf über vier Schnittstellen mit schnellen und Frontier-Modellen vor einer Veröffentlichung kostet weniger als eine Tasse Kaffee. So erhältst du eine vollständige Prüfung deiner gesamten Entwickler-Schnittstelle, bevor sich auch nur ein Kunde verbindet.
Zwei Sicherheitsregeln, die im Code verankert sein müssen
Wenn Sie autonome Testagenten auf ein echtes Backend loslassen, geht schnell etwas schief, sofern Sie nicht zwei Dinge im Code erzwingen.
Prompts schützen keine vorhandenen Daten. Bei unserem allerersten Test in einem gemeinsam genutzten Workspace lautete die Systemanweisung ganz klar: „Ändere oder lösche NUR Ressourcen, die du in dieser Sitzung erstellt hast.“ Ein kostenloses Modell las die Regel, listete vorhandene Widgets auf, wählte eines von uns aus, benannte es um und pausierte es. Prompt-Regeln sind höfliche Bitten. Deshalb setzt agent-surface-tester direkt im Test-Harness einen OwnershipGuard durch: Er überwacht Antworten auf create, speichert die IDs, die während des Testlaufs angelegt werden, und blockiert update- oder delete-Aufrufe für andere IDs, bevor die Anfrage Ihren Rechner verlässt.
Ein Zugangsschlüssel, immer nur ein Agent. Wenn zwei Agenten gleichzeitig im selben Workspace laufen, löscht der eine vielleicht eine Testressource, während der andere die Liste seitenweise abruft. Oder einer schöpft das Ratenlimit pro Schlüssel aus, sodass der zweite fälschlich einen API-Ausfall meldet. Das Test-Harness setzt pro Zugangsschlüssel-Hash eine Betriebssystem-Dateisperre, versieht alle Testartefakte mit dem Präfix (mcp_test_*) und entfernt übrig gebliebene Artefakte mit diesen Präfixen vor und nach jedem Lauf. Lokal richten wir für jeden Zugang einen eigenen Sandbox-Workspace ein. So können MCP-, API-, CLI- und SDK-Tests parallel laufen, ohne jemals den Zustand der anderen zu sehen.
Genau hinhören, dann konsequent filtern
Auf Agenten zu hören heißt nicht, sie Ihr Produkt gestalten zu lassen. Nach der Auswertung von 89 Transkripten ersparen drei Filter viel unnötige Arbeit:
- Vergiss die Bewertung von 1 bis 10. Modelle sind darauf trainiert, ermutigend zu sein. Viele Durchläufe vergaben eine Gesamtbewertung von
8/10oder9/10, obwohl kurz zuvor ein500-Fehler und drei undokumentierte Felder aufgetreten waren. Ignoriere die Bewertung vollständig und lies dir die fehlgeschlagenen Tool-Aufrufe, die Wiederholungsversuche und die Listetop_3_fixesdurch. - Prüfe Behauptungen anhand des Traces. Modelle halluzinieren auch in nachträglichen Analysen. Ein Durchlauf behauptete,
query_assistanthabecredit_costnicht zurückgegeben, nur zwei Minuten nachdem ein anderes Modell den genauen Wert fürcredit_costvom selben Endpunkt protokolliert hatte. Da das Harness jeden unverarbeiteten Tool-Aufruf zusammen mit der Zusammenfassung speichert, dauert es fünf Sekunden, eine Behauptung zu überprüfen. - Die Architektur bleibt in Menschenhand. Vier verschiedene CLI-Agenten baten uns, für asynchrone Befehle zur Dokumentaufnahme ein blockierendes
--wait-Flag hinzuzufügen. Das klang vernünftig, bis wir es mit unserer eigenen Designregel abglichen: Jeder Lookio-CLI-Befehl entspricht einer HTTP-Anfrage, ohne versteckte Polling-Schleifen, die eine Shell drei Minuten lang blockieren.
Teste es mit deinem eigenen MCP
Wenn du einen MCP-Server, eine API, eine CLI oder ein SDK entwickelst, solltest du beide Seiten abdecken:
- Füge in der Produktion ein
send_feedback-Tool hinzu (hier findest du das genaue Schema und den Prompt, den ich verwende), damit aktive Agenten dir mitteilen können, was sie überrascht hat, solange ihnen der Kontext noch vorliegt. - Klone agent-surface-tester, richte es mit einem OpenRouter-Schlüssel jeweils auf einen Zugangspunkt aus und beobachte, wie ein Modell ohne Vorkenntnisse dein Produkt nutzt, ohne deinen Code zu lesen.
Schon der erste Testlauf für fünf Cent findet ein fehlerhaftes Schema, einen irreführenden 400-Fehler oder ein fehlendes Beispiel, von dem du dachtest, es wäre offensichtlich. Behebe die Probleme und lass den Test erneut laufen. Beim nächsten Mal, wenn sich ein echter Agent verbindet, wirst du den Unterschied merken.