

Kleine Modelle sollten entscheiden, was große Modelle sehen
Es wird immer üblicher, ein leistungsstarkes KI-Modell kleinere Modelle orchestrieren zu lassen. Das große Modell plant die Arbeit und überträgt dann Klassifizierung, Extraktion oder vorhersehbare Änderungen an schnellere und günstigere Modelle.
Das leuchtet ein. Doch so wird nur optimiert, wer welche Aufgabe erledigt.
Meiner Meinung nach lässt sich die Effizienz noch stärker steigern: Kleine Modelle nicht nur unterhalb des großen Modells einsetzen, sondern auch um es herum.
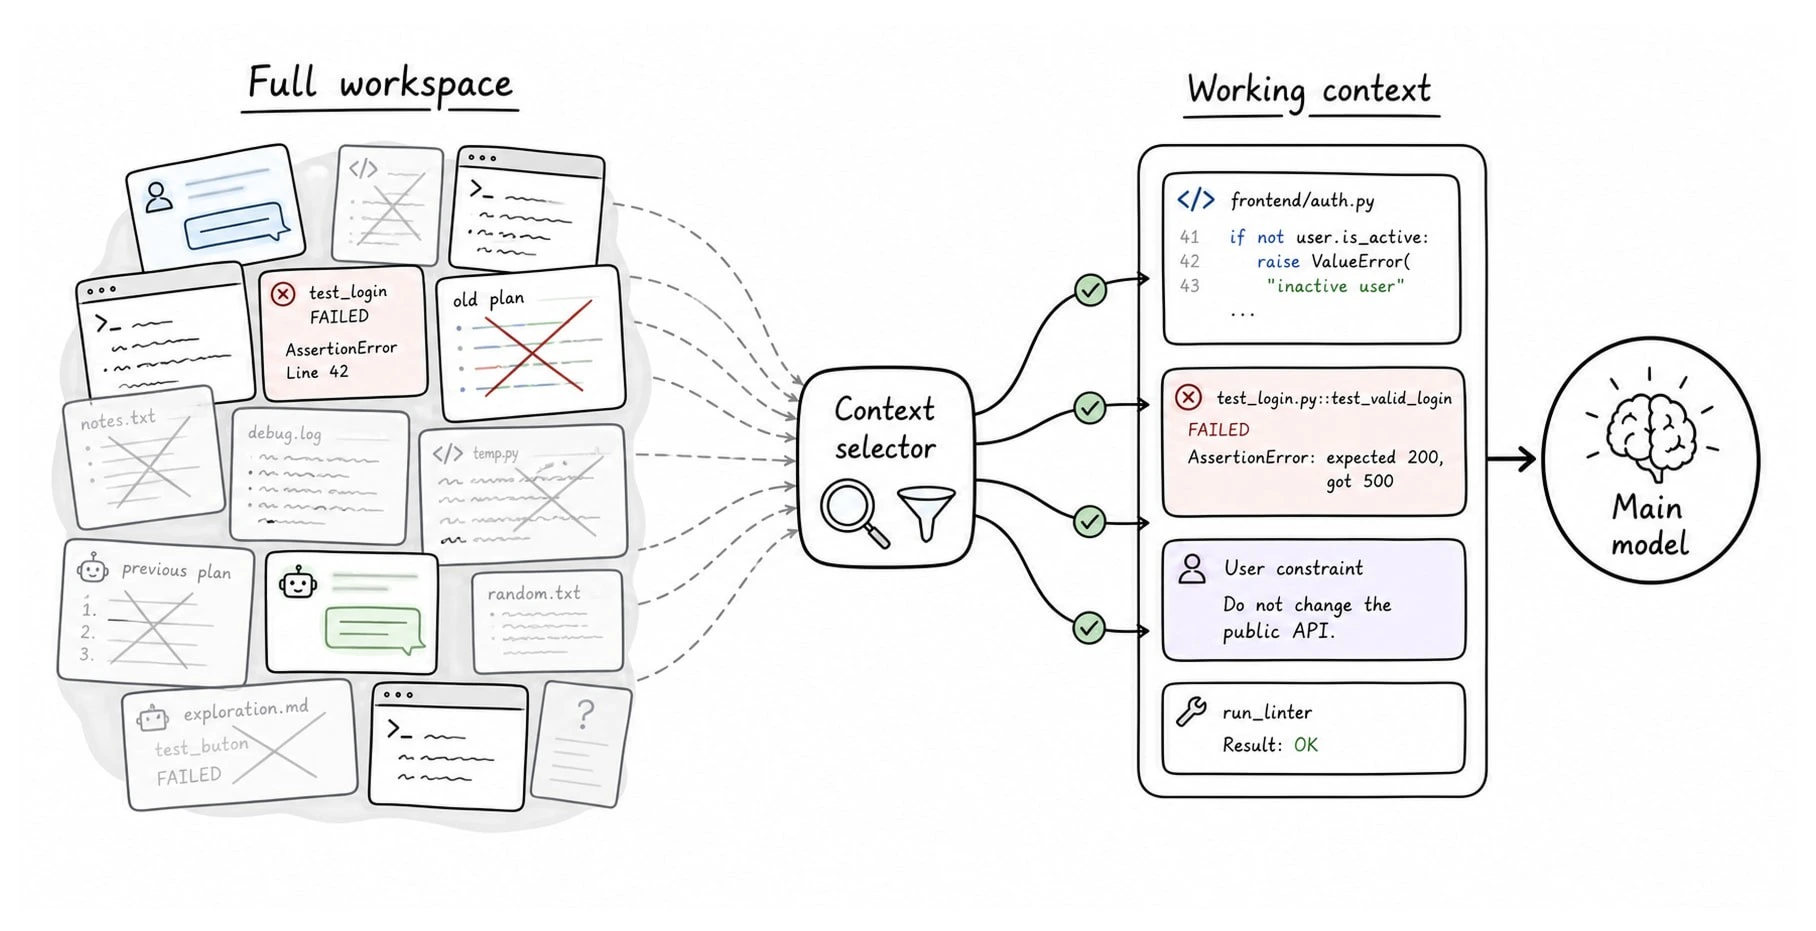
Sie könnten den Kontext vorbereiten, bevor das große Modell Schlussfolgerungen zieht, die Ausgaben seiner Tools filtern und nützliche Informationen bewahren, während die Sitzung länger wird.
Das große Modell würde weiterhin die schwierigen Entscheidungen treffen. Doch weil es intelligent, langsam und teuer ist, sollte jedes Token, das es verarbeitet, seinen Platz verdienen.
Kontext vorbereiten, statt ihn anzuhäufen
Coding-Agenten bauen einen langen Arbeitsverlauf auf: Nachrichten, Pläne, Befehlsausgaben, Dateien, Fehler und überholte Versionen derselben Informationen. Jeder Eintrag war vielleicht einmal nützlich. Für spätere Entscheidungen bleiben nur wenige dauerhaft relevant.
Aktuelle Systeme häufen dieses Material oft an, bis sie Tool-Ergebnisse löschen, Erinnerungen speichern oder die Unterhaltung komprimieren. In Anthropics Dokumentation gelten irrelevante Kontextinhalte als Gefahr für die Konzentration des Modells, nicht nur für die Kapazität des Kontextfensters.
Ein kleines Modell könnte vor jedem wichtigen Schlussfolgerungsschritt den Kontext auswählen. Seine Ausgabe könnte etwa so aussehen:
{
  "include_messages": [2, 7, 11],
  "include_files": [
    { "path": "src/auth.ts", "lines": "48-126" },
    { "path": "tests/auth.test.ts", "match": "refresh token" }
  ],
  "include_tool_results": ["call_184"],
  "durable_notes": ["The user rejected cookie-based sessions."],
  "omit_reason": "Unrelated build logs and superseded files"
}
Das große Modell erhielte die ausgewählten Originalpassagen, keine vage Zusammenfassung des gesamten Verlaufs. So entsteht ein Abrufsystem für den sich ständig weiterentwickelnden Arbeitsbereich des Agenten.
Tool-Ausgaben filtern, bevor das Hauptmodell sie liest
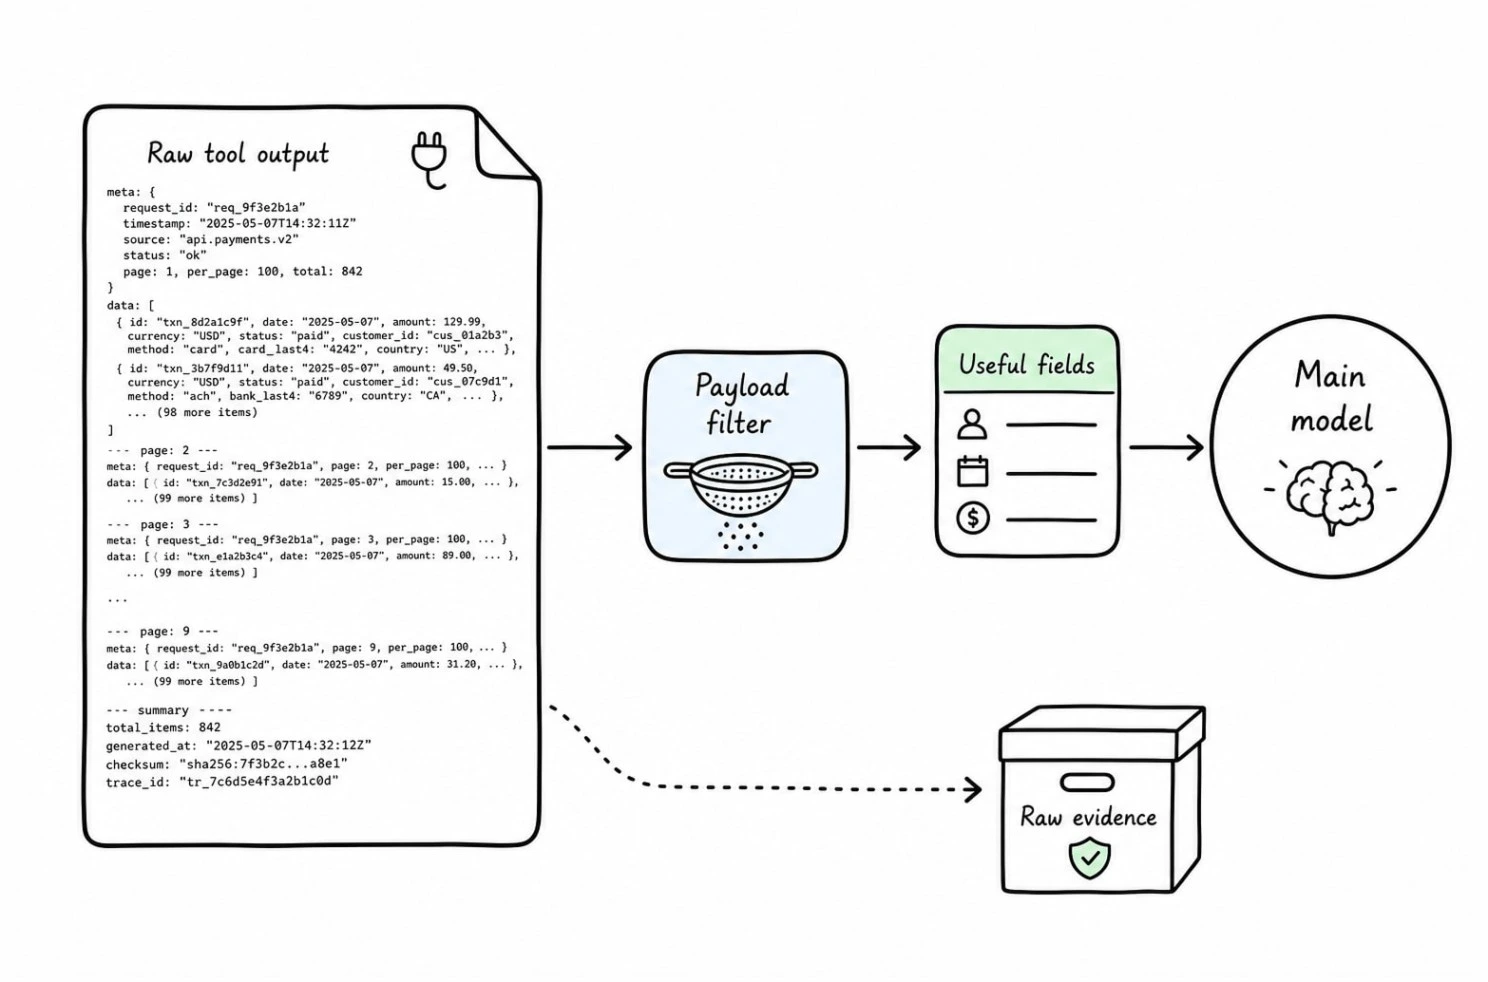
Eine API oder ein MCP-Server gibt möglicherweise Dutzende Felder zurück, obwohl der Agent nur drei benötigt. IDs, Zeitstempel, Metadaten zur Seitennavigation und wiederholte Beschreibungen bleiben dann im Transkript und werden in späteren Durchläufen möglicherweise erneut verarbeitet.
Ein kleines Modell könnte zwischen der Tool-Antwort und dem Hauptmodell sitzen. Es würde die Rohdaten anhand des aktuellen Ziels filtern, eine typisierte Teilmenge zurückgeben und einen Verweis auf das unveränderte Ergebnis aufbewahren. Das ist besonders nützlich, wenn die Entwicklerin oder der Entwickler des Agenten das externe Tool nicht ändern kann.
Dieselbe Ebene könnte Dateien klassifizieren, relevante Abschnitte finden und generierte Inhalte ausschließen, bevor das große Modell sie liest.
Informationen komprimieren, solange sie noch frisch sind
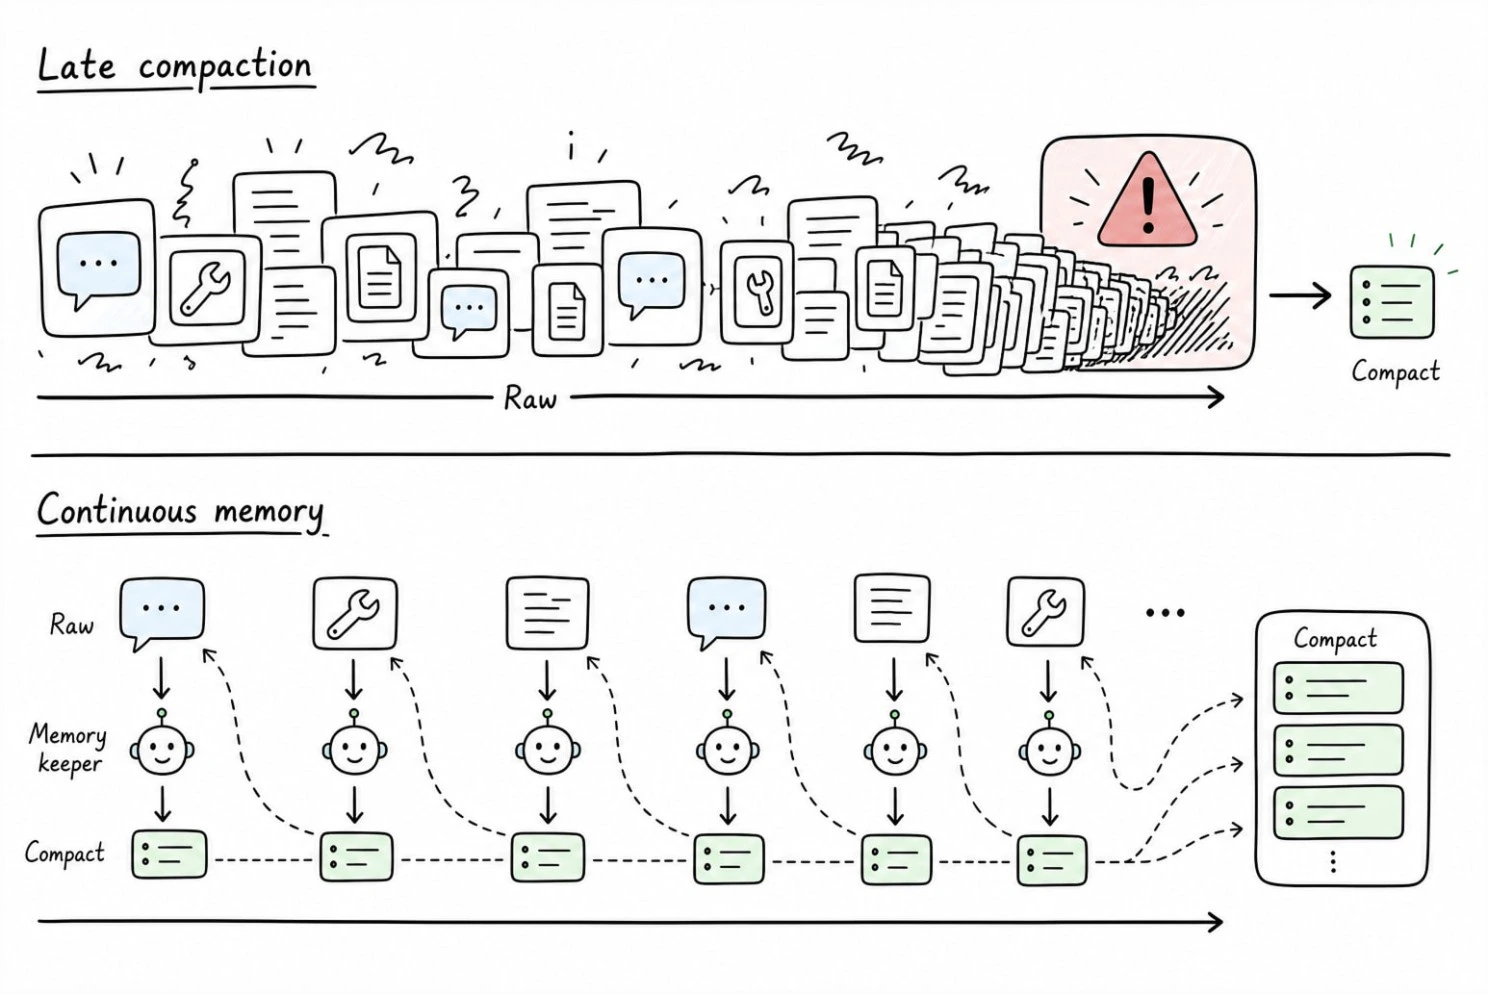
Die Komprimierung erfolgt meist reaktiv: Sobald der Kontext einen Schwellenwert erreicht, wird aus einer umfangreichen Historie eine kurze Zusammenfassung. Bis dahin hat das Hauptmodell umfangreiche Inhalte möglicherweise schon viele Male erneut gelesen. Eine einzige späte Zusammenfassung muss außerdem Details aus mehreren Phasen bewahren, deren spätere Relevanz sich nur schwer vorhersagen lässt.
Die Historie eines Agenten hat zwei Leser mit unterschiedlichen Anforderungen. Menschen benötigen die vollständigen Nachrichten in natürlicher Sprache, um nachvollziehen und prüfen zu können, was passiert ist. KI-Modelle brauchen dieselben Fakten mit möglichst wenigen verlässlichen Tokens.
Ein kleines Modell könnte beide Versionen fortlaufend pflegen, während neue Informationen eintreffen: das vollständige, für Menschen lesbare Transkript und eine kompakte, maschinenlesbare Darstellung, die in den aktiven Kontext geladen wird. Jedes komprimierte Element würde auf sein Original verweisen.
Die maschinenlesbare Version müsste kein ausgefeilter Text sein. Sie könnte sich am jüngsten „Caveman“-Trend bei Coding-Agenten orientieren: telegrammartige Aussagen, die Artikel, Höflichkeitsfloskeln, Relativierungen und verbindende Füllwörter weglassen, dabei aber technische Details bewahren. Es geht nicht darum, dass Menschen so sprechen. Es geht darum, große Modelle nicht dafür zu bezahlen, Sprache erneut zu lesen, die für Menschen geschrieben wurde.
Ein 2,000-Token-Testprotokoll könnte so aussehen:
14 Tests bestanden.
refreshes expired tokenfehlgeschlagen, weilexpiresAtbeiauth.test.ts:88undefinedwar. Vollständige Ausgabe: Artefakttest-run-184.
Das Ergebnis, der Fehler, der relevante Wert, die Fundstelle und der Weg zurück zum Beleg bleiben erhalten. Der Ballast nicht.
Das ist laufende Pflege statt einer Notfallkomprimierung.
Die Kostenrechnung ist plausibel
Die zusätzliche Inferenz lohnt sich nur, wenn sie mehr einspart, als sie an Geld, Latenz und Fehlern kostet. Ein einfaches Modell zeigt, dass die finanzielle Hürde niedrig sein kann.
Betrachten wir eine beispielhafte Coding-Sitzung mit 20 Schritten. Das große Modell erhält insgesamt 1.45 Millionen Eingabe-Tokens. Ein Kontextmodell liest dieselbe Historie, gibt 10,000 Tokens an Auswahlhinweisen aus und reduziert die Eingabe des großen Modells auf 560,000 Tokens. Beide Varianten erzeugen 40,000 Ausgabe-Tokens des großen Modells.
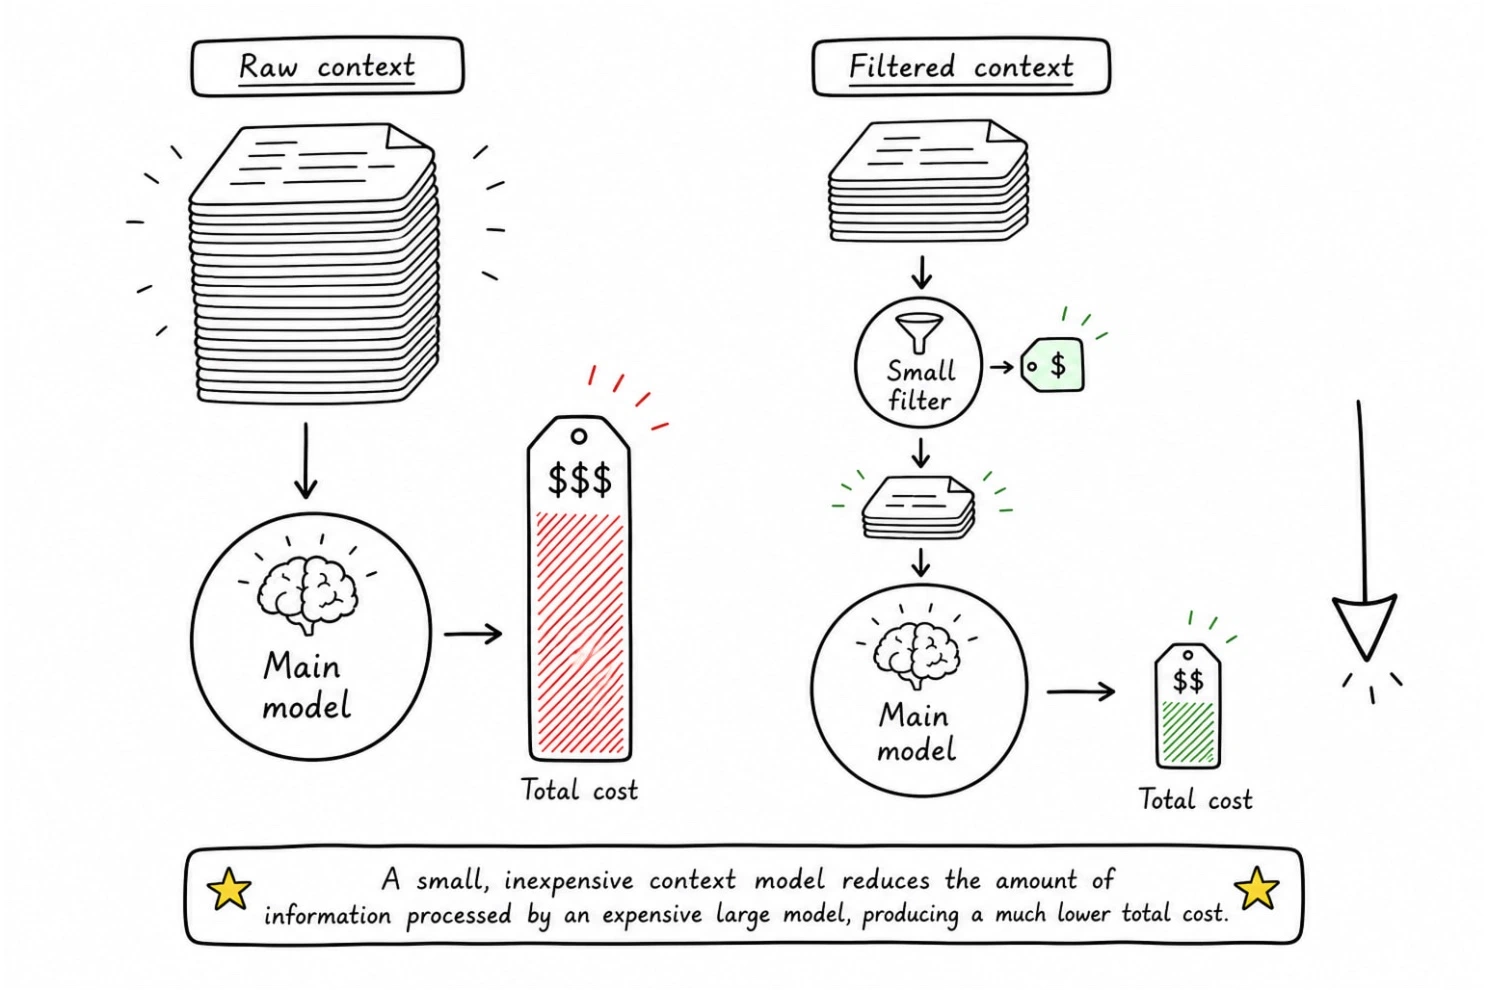
Bei den am 4 July 2026 veröffentlichten Standard-API-Preisen ergibt die Kombination aus Gemini 3.1 Flash-Lite ($0.25 pro Million Eingabe-Tokens und $1.50 pro Million Ausgabe-Tokens) und Claude Fable 5 ($10 für Eingaben und $50 für Ausgaben) Folgendes:
| Ohne Filterung | Mit Filterung | |
|---|---|---|
| Eingabe des großen Modells | 1.45M Tokens | 0.56M Tokens |
| Kosten des großen Modells | $16.50 | $7.60 |
| Kosten des Kontextmodells | keine | $0.38 |
| Gesamt | $16.50 | $7.98 |
Gesamtkosten einer Sitzung mit 20 Schritten
Die Filterung hat sich bezahlt gemacht, sobald 37,750 Fable-Eingabe-Tokens entfernt wurden, also 2.6% der Rohdaten.
Der Filter kann versagen
Wenn Kontext entfernt wird, kann auch der Hinweis verschwinden, der zur Lösung der Aufgabe führt. Ein kleines Modell könnte eine ungewöhnliche Logzeile verwerfen, eine Vorgabe des Nutzers verfälschen oder eine Kennung auslassen, die der nächste Tool-Aufruf benötigt.
Die Architektur braucht daher einige klare Regeln:
- Rohdaten müssen weiterhin abrufbar sein;
- Filterentscheidungen müssen strukturiert und nachvollziehbar sein;
- Nutzeranweisungen und Sicherheitsvorgaben dürfen niemals komprimiert werden;
- Unsicheres muss einbezogen werden;
- das Hauptmodell muss die ursprünglichen Belege anfordern können;
- gemessen werden muss der Aufgabenerfolg, nicht nur die Token-Ersparnis.
Kleine Modelle sollten den Zugriff auf Belege verwalten und nicht unbemerkt zur Quelle der Wahrheit werden.
Das Experiment zählt mehr als die Schätzung
Die Idee sollte mit drei Alternativen verglichen werden: unverändert angesammelter Kontext, Verdichtung anhand eines Schwellenwerts und kontinuierliche semantische Filterung.
Jedes System sollte dieselben Programmieraufgaben bearbeiten. Bewertet werden sollten die gesamten Tokenkosten, die Latenz, die Cache-Auslastung und der Aufgabenerfolg. Außerdem sollte jeder Fall dokumentiert werden, in dem durch die Filterung ein Beleg entfernt wird, den das Hauptmodell später benötigt.
- 1Ein AufgabensatzDieselben Programmieraufgaben für alle
- 2Drei SystemeUnverändert, Schwellenwert-Verdichtung, kontinuierliche Filterung
- 3Vier MessgrößenKosten, Latenz, Cache-Treffer, Erfolg
- 4Ein UrteilGünstiger zählt nur, wenn es weiterhin funktioniert
Die Architektur ist nur dann erfolgreich, wenn sie die Kosten senkt, ohne die Qualität der Ausführung zu beeinträchtigen. Solange ein solcher Test fehlt, ist die Wirtschaftlichkeit ein Grund zum Experimentieren, aber kein Beleg dafür, dass das System funktioniert.
Eine neue Rolle für kleine Modelle
Beim Model-Routing lautet die Frage: Welches Modell soll diese Aufgabe übernehmen?
Bei dieser Architektur lautet die Frage: Was verdient die Aufmerksamkeit des besten Modells?
Model-RoutingWer die Arbeit erledigt
- Liest die Aufgabe und wählt ein Modell aus
- Das günstige Modell übernimmt die einfachen Aufgaben
- Der Kontext ist das, was sich angesammelt hat
Kleine Modelle rund um das große ModellWorauf die Arbeit basiert
- Das beste Modell übernimmt die schwierigen Entscheidungen
- Kleine Modelle wählen aus, was es liest
- Der Kontext wird vor jedem Schritt ausgewählt
Kleine Modelle könnten zu Kontextbibliothekaren, Bearbeitern von Payloads und Verwaltern des Gedächtnisses werden. Sie würden den Arbeitsbereich vorbereiten, bevor das Hauptmodell Schlussfolgerungen zieht, und anschließend die nützlichen Ergebnisse sichern.
Besonders relevant ist die Idee für Programmieragenten, weil diese große Mengen an Zwischenmaterial erzeugen. Sie lässt sich auch auf Recherche, Support und andere lang laufende Arbeitsabläufe übertragen, in denen Gespräche, Tools und externe Daten zusammenkommen.
Das leistungsfähigste Modell sollte nicht jede Zeile lesen, nur weil das System sie ihm schicken kann.
Jedes Token sollte einen Zweck erfüllen.